Contents — find the section you need
Görsel-Dil-Eylem (VLA) modelleri, kamera görüntülerini ve doğal dil talimatlarını tek bir sisteme entegre eden ve robotun eylemlerini (motor komutlarını) doğrudan üreten bir mimaridir. Robotikte algılama (tanıma) ve kontrolü (planlama ve yürütme) ayrı süreçler olarak tasarlayan geleneksel yaklaşımın aksine, buradaki temel fikir zihniyet değişikliğidir: ikisini de tek bir transformatör modeline entegre etmek.
 Görsel + Dil → Eylem
Büyük VLA şirketleri (Physical Intelligence, vb.) için lisanssız resmi bir logo bulunamadığından, bunun yerine görsel, dil ve eylemin entegrasyonunu temsil eden basit bir simge oluşturuldu.
VLA'ya Genel Bakış
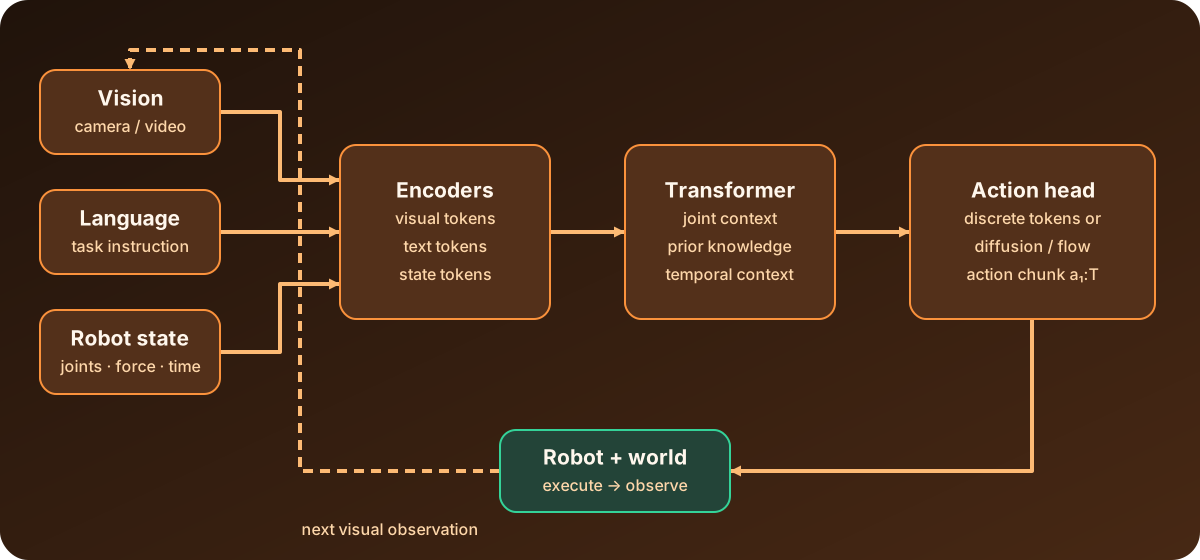
Diyagram: Duskcoil. VLA çıkarımı ile fiziksel dünya geri bildirimi arasındaki temsili bir ilişkiyi basitleştirir.
Bir VLA, yalnızca okuyabilen bir model değildir. Görüntüler ve dil; çıktısı fiziksel eyleme bağlı olan kapalı bir döngünün parçasıdır. Görüntüler, talimatlar ve eklem durumu paylaşılan bir temsile eşlenir, bir transformatör bağlamı entegre eder ve bir eylem başlığı bunu bir eylem parçasına dönüştürür. Yürütme sonrası gözlem bir sonraki girdi haline geldiğinden, pratik değerlendirme yalnızca model doğruluğunu değil, aynı zamanda çıkarım gecikmesini, eylem düzgünlüğünü ve davranış anormal hale geldiğinde güvenli bir şekilde durduran bir mekanizmayı da içermelidir.
Soy Ağacı: RT-1'den RT-2'ye ve OpenVLA'ya
Google'ın RT-1'i erken bir amiral gemisi örneğiydi ve halefi RT-2, web ölçekli görüntü ve dil verileri üzerinde önceden eğitilmiş büyük bir modelden gelen bilgiyi robot eylemleri üretmeye yönlendirerek fikri daha da geliştirdi. Açık kaynak tarafında, Open-VLA, Octo ve CLIP-RT gibi modeller, çapraz modlu dikkat (görüntü ve dili kapsayan karşılıklı bir dikkat mekanizması) etrafında inşa edilmiş transformatör tabanlı mimarilerle bunu izledi. Bunların hepsinin ortak noktası, "görmek", "anlamak" ve "hareket etmek"in ayrı modüllere ayrılmamasıdır — Tek bir ağ, girişten (görüntü artı talimat) çıkışa (eylem) kadar uçtan uca eğitilir.
İç Yapı: Üç Alt Sistem
Bir VLA modelinin hesaplama mimarisi kabaca üç alt sistem olarak anlaşılabilir. İlk olarak, bir görüntü kodlayıcı, kameradan gelen ham piksel verilerini yapılandırılmış bir özellik temsiline dönüştürür - genellikle SigLIP veya DINOv2 gibi önceden eğitilmiş görüntü kodlayıcılarının bir kombinasyonu. Ardından, çıkarılan görsel özellikleri dil modelinin çalıştığı gömme alanına eşleyen bir projeksiyon modülü (genellikle çok katmanlı bir algılayıcı) gelir. Son olarak, bir sadece kod çözücü dönüştürücü, birleştirilmiş görsel ve dil (talimat) belirteç dizisini işler ve nihai eylemi üretir.
Eylem Üretme: İki Tasarım Yaklaşımı
Görüntü ve dil entegre edildikten sonra, gerçek motor komutunun (eylem) nasıl üretileceğine dair genel olarak iki tasarım yaklaşımı vardır.
Biri ayrık eylem belirteçleri kullanır: sürekli eylem Değerler (eklem açıları, hızlar vb.) sabit sayıda bölmeye (örneğin 256) ayrıştırılır ve dil modelinin sözlüğünden az kullanılan belirteç kimlikleri, eylemleri temsil etmek üzere yeniden kullanılır. Avantajı, görme, dil ve eylemin aynı tür "belirteç dizisi" olarak tekdüze bir şekilde ele alınabilmesidir; bu da eylem dizisini a_{1:T} otoregresif olarak - o gözlemine bağlı olarak - oluşturur ve her bir sonraki belirteci, kendisinden önce oluşturulanlara dayanarak üretir.
Bu formülasyon, doğal dil üretiminde sonraki kelime tahminine tam olarak aynı şekle sahiptir ve VLA'nın temel fikrini yakalar - görme, dil ve eylemi aynı olasılık modelinde ele almak.
Diğer yaklaşım, difüzyon tabanlı bir eylem başlığı kullanır: dönüştürücünün görevi, görsel ve dil bilgilerini özetleyen bir "okuma belirteci" üretmek ve gerçek sürekli veriyi oluşturmakla sınırlıdır. Eylem değerleri bir difüzyon modeline aktarılır. Aşamalar halinde üretilen ayrık eylem belirteçleri, bazen gerçek zamanlı yanıt verme ve akıcılık konusunda yetersiz kalabilirken, difüzyon tabanlı bir eylem başlığı daha akıcı, sürekli eylem çıktısı üretme eğilimindedir. İkisinin kombinasyonları da giderek daha yaygın hale geliyor - örneğin Octo, görüntü ve dil belirteçlerini tek bir dizi olarak bir transformatörden geçirir, ardından çıktısını (okuma belirteci) bir koşul olarak difüzyon tabanlı bir eylem başlığına iletir.
Bu Tasarımın Pratikteki Anlamı
Klasik bir kontrol sistemi, yalnızca senaryosunu izleyerek ve başka hiçbir şey yapmadan, tasarlanmadığı bir durumu ele alabilir. VLA modelinin avantajı, açıkça eğitilmediği koşullara genelleme yapabilme olasılığıdır. Uygulama alanı, depo otomasyonundan cerrahi yardım robotlarına kadar hızla genişliyor ve giderek daha fazla Somutlaştırılmış Yapay Zekanın arkasındaki temel teknoloji olarak konumlandırılıyor. Aynı zamanda, büyük ölçekli insan gösterim verilerine aşırı bağımlılık, hem veri toplama hem de eğitim maliyeti açısından önemli bir zorluk olmaya devam ediyor.
Fiziksel Physical Intelligence'ın π0 Soy Ağacı
Son zamanlarda VLA'da en çok dikkat çeken isimlerden biri, 400 milyon doların üzerinde yatırım alan bir girişim olan Physical Intelligence'ın π0'ı (pi-zero). Çok amaçlı bir robot politikası olarak duyurulan π0, büyük ölçekli çok görevli, çok robotlu veri toplamayı yeni bir ağ mimarisiyle birleştirerek, çamaşır katlama, masa temizleme, kahve çekirdeği kepçeleme gibi çeşitli görevleri yerine getirebiliyor. Physical Intelligence, π0'ın kodunu ve ağırlıklarını openpi deposu olarak açık kaynaklı hale getirdi ve o zamandan beri geliştirilmiş sürümlerini (π0.5, π0.6, π0.7) yayınlamaya devam etti. π0 tabanı, şirketin kendi yedi robot platformuyla birlikte Open X-Embodiment (OXE) veri kümesi üzerinde önceden eğitildi ve ince ayar için tasarlanmış genel amaçlı bir model olarak tasarlandı: ön eğitim verileriyle zaten kapsanan görevler için kullanılabilir sıfır atışlı, ancak belirli bir kullanım için beklenen yol olarak ince ayar ile inşa edildi. Örnek.
Fiziksel Zekanın Son Gelişmeleri: π0.7 ve Ötesi
Fiziksel Zekanın kendi resmi blogunu takip edersek, π0 serisi 2026 yılına kadar sürekli olarak yetenek eklemeye devam etti. Mart 2026'da art arda iki sürüm yayınlandı: VLA modelinden çıkarılan bir "RL Token" kullanarak gerçek robot manipülasyon görevlerini çevrimiçi takviyeli öğrenme yoluyla hızla iyileştiren bir yöntem ve on dakikadan uzun süren görevleri ele almak için uzun ve kısa süreli belleği entegre eden "Çok Ölçekli Somutlaştırılmış Bellek". Nisan ayında duyurulan π0.7, dışarıdan yönlendirilebilen, genelleme performansında "adım değişikliği" anlamına gelen ortaya çıkan yetenekler sergileyen yönlendirilebilir bir model olarak konumlandırılmıştır. Geliştirmedeki ağırlık merkezi, tek seferlik gösterim taklitinden, gerçek anlamda otonom robot operasyonuna çok daha yakın yeteneklere doğru kayıyor gibi görünüyor: bellek, çevrimiçi öğrenme, yönlendirilebilirlik.
LIBERO Doygunluğa Ulaşıyor ve Hız Yarışı
LIBERO, simülasyon kıyaslama testi VLA araştırmalarında standart hale gelen bu yaklaşım, 2026 yılının ikinci yarısında birden fazla yöntemin görev başarı oranlarının %90'ların üzerinde olduğunu gösteriyor; doğruluk oranı fiilen doygunluğa yaklaşıyor. 4 boyutlu sahne temsiliyle hizalanarak zamansal bağlam anlayışını güçlendiren Temporal Forcing (Ağustos 2026), LIBERO'da %98,8 başarı oranına ulaşırken, daha zorlu "gizli yerleştirme" görevinde başarı oranını %20,0'dan %43,3'e çıkarıyor; bu da standart kıyaslama doygunluğa ulaştıkça, alanın değerlendirme odağının daha zorlu genelleme görevlerine doğru kaydığının bir işareti.
Yöntemler arasında doğruluk oranları yakınsarken, araştırma odağı da çıkarım hızını optimize etmeye doğru kaydı. Geleneksel çok adımlı difüzyon sürecini tek bir ileri geçişle değiştiren DriftingVLA (Ağustos 2026), LIBERO'da %98,32 başarı oranını korurken, yinelemeli yöntemlere kıyasla eylem öbeği üretiminde 3,36 kat hızlanma bildiriyor. AdaVLA (Ağustos 2026, IROS 2026), halihazırda eğitilmiş modelleri yeniden eğitmeden hızlandıran bir yöntem olup, akış eşleştirme yörüngesinin eğriliğinden üretim güvenini tahmin eden bir metrik sunarak, ek eğitim gerektirmeden sırasıyla π0.5 ve X-VLA'da 1,87x ve 2,24x hızlanma sağlıyor. Uzun ufuklu görevlerde düzgün hareket üretimine odaklanan SMILE (Ağustos 2026) de LIBERO'da %98,0 başarı oranını korurken, B-spline katsayılarını tahmin eden bir tasarım sayesinde 1,1x hızlanma bildiriyor — "doğruluktan ödün vermeden daha hızlı", 2026'nın ikinci yarısında VLA araştırmalarının ana eksenlerinden biri haline geldi.
2026'nın Yayılımı
VLA alanındaki araştırmalar 2026'ya kadar hızlı bir şekilde devam etti. Eylem manifoldunu içeren ABot-M0 Öğrenme; ACE-Brain-0.5, somutlaştırılmış ajansal yapay zekâ için birleşik bir temel model; Kairos, bir dünya modelini eylemle bütünleştiriyor — araştırma, basit "gör ve hareket et" yaklaşımının ötesine geçerek, fiziksel dünyada entegre bir şekilde modelleme, hatırlama ve eylemde bulunmaya doğru genişliyor. VLA kavramı da yeniden konumlandırılıyor — robotik odaklı bir teknolojiden, daha geniş "Fiziksel Yapay Zekâ" çerçevesinin temel bir unsuruna dönüşüyor.
Değerlendirmenin Bittiği ve Gerçek Robot Operasyonunun Başladığı Yer
VLA kıyaslama sonuçları, kontrollü koşullar altında yapılan karşılaştırmalı ölçümlerdir: eğitim robotu, kamera yerleşimi, talimat metni, başarı kriteri ve sıfırlama prosedürü kıyaslama tanımı içinde tutulur. Bir kıyaslama başarı oranı, başka bir robot veya çalışma ortamı için doğrudan bir güvenlik iddiası olarak okunamaz. Dağıtımdan önce, eylem çıktısının, hızı, ivmeyi ve eklem sınırlarını uygulayan ve iletişim kaybı, çıkarım zaman aşımı veya sensör hatası durumunda robotu durduran ayrı bir denetim katmanına ihtiyacı vardır. Başarısızlık.
Bir VLA tarafından oluşturulan bir eylem bloğu, çıkarım zamanında mevcut olan gözleme dayalı bir tahmindir. Bir kişi veya nesne blok sırasında hareket ederse, başka bir gözlem olmadan tüm bloğu yürütmek, sistemde eski algıya dayalı komutlar bırakır. Daha sık yeniden planlama ile daha kısa bloklar, tepki hızını artırır ancak çıkarım ve iletişim yükünü artırır. Daha uzun bloklar daha verimli olabilirken, tıkanma veya temas değişikliklerine daha yavaş tepki verir. Araştırmadan operasyona pratik köprü, görev başarısına ek olarak durma mesafesini, yeniden planlama süresini ve kurtarma oranını ölçmektir.
Eğitim verilerinin dağılımı da önemlidir. Eğitim koşullarından farklı olan aydınlatma, malzeme, eklem sürtünmesi ve kamera gecikmesi, gerçek robotta eylem hataları olarak ortaya çıkabilir. Bu nedenle değerlendirme, tekrarlanan bilinen görevleri, hareket eden nesnelerle yapılan testlerden, yeniden ifade edilmiş talimatlardan, tıkanmadan sonraki kurtarmadan ve kasıtlı olarak geciktirilmiş iletişimden ayırmalıdır. Bir modelden başarısızlıktan sonra yeniden denemesini istemek, nedeni belirlemez. Giriş görüntüsünü, talimatı, oluşturulan eylemi, denetim sınırlarını ve durdurma nedenini tek bir paylaşılan zaman tabanına karşı saklayın. Bu, bir algılama hatasını diğer hatalardan ayırt etmeyi kolaylaştırır. Mekanik veya iletişimsel bir arıza durumunda, model güncellemesinden sonra aynı değerlendirmeyi tekrarlamak gerekir.
Uygulama kararları da aşamalı olarak alınmalıdır. Simülasyondaki başarı, laboratuvarda çalışan bir durdurma koşulu ve sınırlı bir ortamda görevin tamamlanması farklı kanıt parçalarıdır. Açık alanlara veya insanlarla paylaşılan alanlara geçmeden önce, bilinmeyen nesneleri, aydınlatma değişikliklerini, düşük pili ve ağ kaybını test edin, ardından modele güvenme koşullarını ve kontrolü geleneksel bir kontrol cihazına geri verme koşullarını belgeleyin. Bu sınırı açıkça belirtmek, bir kontrol sisteminin gerektirdiği doğrulanabilirliği kaybetmeden bir VLA'nın esnekliğini korur.
Deney kaydı, model ve ağırlık sürümünü, giriş çözünürlüğünü, çıkarım süresini, kontrol süresini ve eylem tutma süresini içermelidir. Bu alanlar olmadan, aynı modeli tekrar çalıştırmak karşılaştırılabilir bir sonuç üretmez. "Başarı" bile farklı anlamlara gelebilir: bir nesneyi hedefe yerleştirmek, temastan kaçınmak veya bir sınırlayıcı müdahale ettikten sonra bir görevi tamamlamak. Başarı ve kesinti kriterlerini önceden tanımlayın ve modelin ne ürettiğini ve denetleyici katmanın neye izin verdiğini ayrı ayrı raporlayın. Araştırma verilerini operasyonel bir kararda kullanmak için, ölçüm koşulları ve Ölçülmemiş aralık aynı tabloya yazılmalıdır.
Rutin çalışma sırasında, modelin kendisi değiştirilmemiş olsa bile, kamera değişimi veya aydınlatma değişikliğinden sonra davranış değişebilir. Dağılım kaymalarını tespit etmek için, güven göstergelerini, eylem büyüklüklerini ve denetleyici katman tarafından yapılan müdahale sayısını kaydetmeye devam edin. Anormal değerler devam ettiğinde, yavaş moda geçmek veya manuel çalışma, otomatik olarak tekrar tekrar denemekten daha kolay teşhis edilebilir. Bir VLA'yı gözlem, çıkarım, sınırlama ve durdurmayı ayıran bir sistemin bir bileşeni olarak ele almak, hem tekrarlanabilirliği hem de güvenliği destekler.
Görünür talimat anlayışı güvenli robot eylemi oluşturuyor mu?
Eylem sınırları, yürütme koşulları, arıza tespiti ve durdurma mekanizmaları gerekli olmaya devam etmektedir. Akıcı dil, fiziksel başarının kanıtı değildir.
Referanslar
- [Robotik Manipülasyonda Görsel Dil Eylem Modelleri: Sistematik Bir İnceleme] (arXiv)](https://arxiv.org/pdf/2507.10672)
- π0: Fiziksel Zeka Resmi Blogu
- π0.7 Resmi Duyuru
- π0.7 Makalesi (Fiziksel Zeka)
- Verimli Çevrimiçi RL ile Hassas Manipülasyon (Fiziksel Zeka)
- Uzun ve Kısa Süreli Belleğe Sahip VLA'lar (Fiziksel Zeka)
- Fiziksel Zeka openpi GitHub Deposu Kapsamı (Robot Raporu)
- Robotik için Görsel-Dil-Eylem (VLA) Modelleri (Roboflow Blogu) )
- Görsel-Dil-Eylem Modelleri Üzerine Bir Araştırma: Eylem Tokenizasyon Perspektifi (arXiv)
- Fiziksel Zeka Resmi Blogu
- Zamansal Zorlama Makalesi (arXiv)
- DriftingVLA Makalesi (arXiv)
- AdaVLA Makalesi (IROS 2026, arXiv)
- SMILE Makalesi (arXiv)
Yorumlar
Lütfen önce giriş yapın.
Henüz veri yok.