Contents — find the section you need
Model Visi-Bahasa-Aksi (VLA) adalah arsitektur yang menggabungkan rekaman kamera dan instruksi bahasa alami ke dalam satu sistem, menghasilkan aksi robot (perintah motorik) secara langsung. Berbeda dengan tradisi dalam robotika yang merancang persepsi (pengenalan) dan kontrol (perencanaan dan eksekusi) sebagai alur kerja terpisah, ide inti di sini adalah pergeseran pola pikir: mengintegrasikan keduanya ke dalam satu model transformer.
 Visi + Bahasa → Aksi
Tidak ditemukan logo resmi bebas lisensi untuk perusahaan VLA utama (Physical Intelligence, dll.), jadi ikon sederhana yang mewakili integrasi visi, bahasa, dan aksi dibuat sebagai penggantinya.
Sekilas tentang VLA
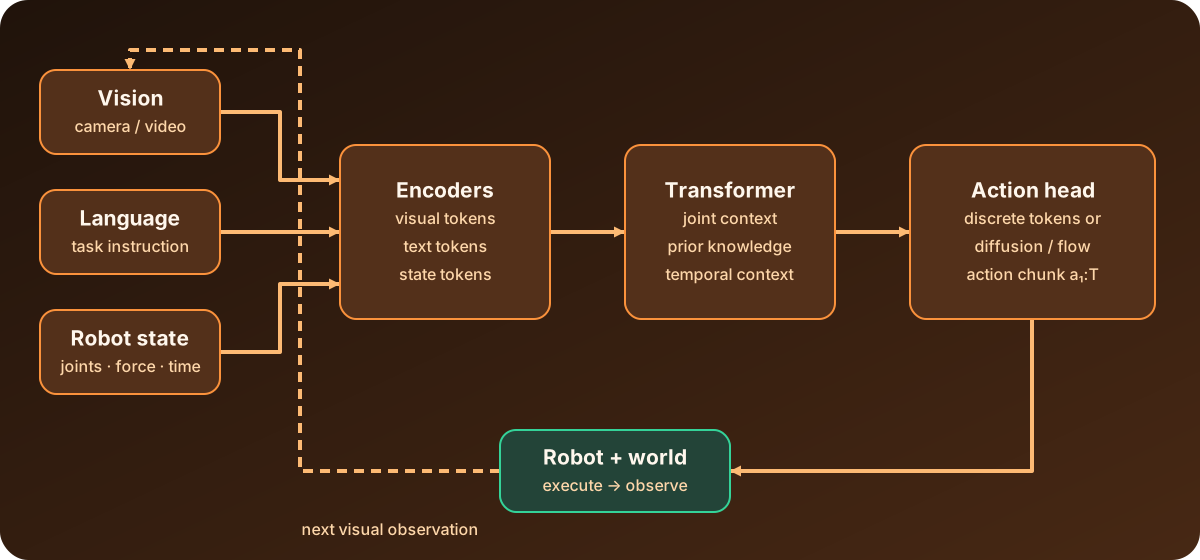
Diagram: Duskcoil. Ini menyederhanakan hubungan representatif antara inferensi VLA dan umpan balik dunia fisik.
VLA bukan hanya model yang dapat membaca gambar dan bahasa; ia merupakan bagian dari loop tertutup yang outputnya terhubung dengan aksi fisik. Gambar, instruksi, dan status sendi dipetakan ke dalam representasi bersama, sebuah transformer mengintegrasikan konteks, dan sebuah action head mengubahnya menjadi potongan aksi. Karena observasi setelah eksekusi menjadi input berikutnya, evaluasi praktis harus mencakup tidak hanya akurasi model tetapi juga latensi inferensi, kelancaran aksi, dan mekanisme yang berhenti dengan aman ketika perilaku menjadi abnormal.
Silsilah: Dari RT-1 ke RT-2 ke OpenVLA
RT-1 Google adalah contoh unggulan awal, dan penerusnya RT-2 mengembangkan ide tersebut lebih lanjut, mengarahkan pengetahuan dari model besar yang telah dilatih sebelumnya pada data visi dan bahasa skala web menuju pembuatan aksi robot. Di sisi open-source, model seperti Open-VLA, Octo, dan CLIP-RT telah mengikuti dengan arsitektur berbasis transformer yang dibangun di sekitar perhatian lintas modal (mekanisme perhatian bersama yang mencakup visi dan bahasa). Yang dimiliki bersama oleh semua ini adalah bahwa "melihat," "memahami," dan "bertindak" tidak dipisahkan menjadi modul terpisah — satu jaringan dilatih dari ujung ke ujung, dari input (rekaman video). ditambah instruksi) hingga ke output (aksi).
Struktur Internal: Tiga Subsistem
Arsitektur komputasi model VLA dapat dipahami secara kasar sebagai tiga subsistem. Pertama, encoder visi mengubah data piksel mentah dari kamera menjadi representasi fitur terstruktur — seringkali kombinasi dari encoder gambar yang telah dilatih sebelumnya seperti SigLIP atau DINOv2. Selanjutnya adalah modul proyeksi (biasanya perceptron multi-layer) yang memetakan fitur visual yang diekstrak ke ruang embedding tempat model bahasa bekerja. Terakhir, transformer khusus decoder memproses urutan token visual dan bahasa (instruksi) yang digabungkan dan menghasilkan aksi akhir.
Menghasilkan Aksi: Dua Pendekatan Desain
Setelah visi dan bahasa diintegrasikan, secara umum ada dua pendekatan desain tentang bagaimana perintah motorik aktual (aksi) dihasilkan.
Salah satunya menggunakan token aksi diskrit: nilai aksi kontinu (sudut sendi, kecepatan, dan sejenisnya) didiskretisasi menjadi sejumlah token tetap. bin (misalnya 256), dan ID token dari kosakata model bahasa yang jarang digunakan untuk hal lain, digunakan kembali untuk merepresentasikan tindakan. Keuntungannya adalah bahwa visi, bahasa, dan tindakan dapat ditangani secara seragam sebagai jenis "urutan token" yang sama, menghasilkan urutan tindakan a_{1:T} secara autoregresif — dikondisikan pada pengamatan o, menghasilkan setiap token berikutnya berdasarkan token yang dihasilkan sebelumnya.
Formulasi ini memiliki bentuk yang sama persis dengan prediksi kata berikutnya dalam generasi bahasa alami, dan menangkap ide inti VLA — menangani visi, bahasa, dan tindakan dalam model probabilistik yang sama.
Pendekatan lain menggunakan kepala tindakan berbasis difusi: tugas transformer dikurangi menjadi menghasilkan "token bacaan" yang meringkas informasi visual dan bahasa, dan menghasilkan nilai tindakan kontinu yang sebenarnya diserahkan ke model difusi. Token tindakan diskrit, yang dihasilkan secara bertahap, terkadang kurang akurat secara real-time. Responsif dan halus, sedangkan kepala aksi berbasis difusi cenderung menghasilkan keluaran aksi yang lebih halus dan kontinu. Kombinasi keduanya juga semakin umum — Octo, misalnya, memasukkan token gambar dan bahasa melalui transformator sebagai satu urutan, kemudian meneruskan keluarannya (token pembacaan) sebagai kondisi ke kepala aksi berbasis difusi.
Apa Arti Desain Ini dalam Praktik
Sistem kontrol klasik hanya dapat menangani situasi yang tidak dirancang untuknya dengan mengikuti skripnya dan tidak lebih. Keuntungan model VLA adalah kemungkinan generalisasi ke kondisi yang tidak pernah dilatih secara eksplisit. Jangkauan aplikasinya berkembang pesat, dari otomatisasi gudang hingga robot bantuan bedah, dan semakin diposisikan sebagai teknologi inti di balik AI yang Terwujud. Pada saat yang sama, ketergantungan yang besar pada data demonstrasi manusia skala besar tetap menjadi tantangan utama, baik dalam pengumpulan data maupun biaya pelatihan.
Garis Keturunan π0 dari Kecerdasan Fisik
Salah satu nama yang paling menarik perhatian dalam VLA baru-baru ini adalah π0 (pi-nol), dari Kecerdasan Fisik, Sebuah startup yang telah mengumpulkan dana lebih dari $400 juta. Diumumkan sebagai kebijakan robot serbaguna, menggabungkan pengumpulan data multi-tugas dan multi-robot skala besar dengan arsitektur jaringan baru, yang mampu menangani beragam tugas — melipat pakaian, membersihkan meja, menyendok biji kopi. Physical Intelligence membuka kode dan bobot π0 sebagai repositori openpi, dan terus merilis versi yang lebih baik sejak saat itu — π0.5, π0.6, π0.7. Basis π0 dilatih sebelumnya pada dataset Open X-Embodiment (OXE) bersama dengan tujuh platform robot milik perusahaan sendiri, dan dirancang sebagai model serbaguna yang dimaksudkan untuk penyempurnaan: dapat digunakan sebagai zero-shot untuk tugas-tugas yang sudah tercakup oleh data pra-pelatihan, tetapi dibangun dengan penyempurnaan sebagai jalur yang diharapkan untuk kasus penggunaan spesifik.
Kabar Terbaru Physical Intelligence: π0.7 dan Selanjutnya
Melacak blog resmi Physical Intelligence sendiri, lini π0 terus menambahkan kemampuan secara bertahap melalui 2026. Maret 2026 menghadirkan dua rilis berturut-turut: sebuah metode yang menggunakan "Token RL" yang diekstrak dari model VLA untuk dengan cepat menyempurnakan tugas manipulasi robot nyata melalui pembelajaran penguatan daring, dan "Memori Terwujud Multi-Skala," yang mengintegrasikan memori jangka panjang dan pendek untuk menangani tugas yang berjalan lebih dari sepuluh menit. π0.7, yang diumumkan pada bulan April, diposisikan sebagai model yang dapat dikendalikan — model yang dapat dipandu secara eksternal — yang menunjukkan kemampuan yang muncul yang setara dengan "perubahan langkah" dalam kinerja generalisasi. Pusat gravitasi dalam pengembangan tampaknya bergeser dari imitasi demonstrasi sekali jalan menuju kemampuan yang jauh lebih dekat dengan operasi robot otonom sejati: memori, pembelajaran daring, kemampuan kendali.
LIBERO Jenuh, dan Perlombaan Kecepatan
LIBERO, tolok ukur simulasi yang telah menjadi standar dalam penelitian VLA, telah melihat beberapa metode mencapai tingkat keberhasilan tugas di atas 90% pada paruh kedua tahun 2026 — akurasi secara efektif mendekati kejenuhan. Temporal Forcing (Agustus) DriftingVLA (Agustus 2026), yang memperkuat pemahaman konteks temporal dengan menyelaraskan dengan representasi adegan 4D, mencatatkan akurasi 98,8% pada LIBERO sambil meningkatkan keberhasilan pada tugas "penempatan tersembunyi" yang lebih sulit dari 20,0% menjadi 43,3% — sebuah tanda bahwa seiring dengan jenuhnya tolok ukur standar, fokus evaluasi bidang ini bergeser ke arah tugas generalisasi yang lebih sulit.
Dengan akurasi yang konvergen di berbagai metode, fokus penelitian juga telah bergeser ke arah pengoptimalan kecepatan inferensi. DriftingVLA (Agustus 2026), yang menggantikan proses difusi multi-langkah konvensional dengan satu kali proses maju, mempertahankan akurasi 98,32% pada LIBERO sambil melaporkan peningkatan kecepatan 3,36 kali lipat dalam pembuatan potongan aksi dibandingkan dengan metode iteratif. AdaVLA (Agustus 2026, IROS 2026), yang mempercepat model yang sudah dilatih tanpa melatih ulang, memperkenalkan metrik yang memperkirakan kepercayaan generasi dari kelengkungan lintasan pencocokan aliran, mencapai 1,87 kali lipat dan Peningkatan kecepatan 2,24x pada π0.5 dan X-VLA masing-masing tanpa pelatihan tambahan. SMILE (Agustus 2026), yang ditujukan untuk menghasilkan gerakan halus pada tugas-tugas jangka panjang, juga mempertahankan tingkat keberhasilan 98,0% pada LIBERO sambil melaporkan peningkatan kecepatan 1,1x melalui desain yang memprediksi koefisien B-spline — "lebih cepat tanpa mengorbankan akurasi" telah menjadi salah satu poros utama penelitian VLA di paruh kedua tahun 2026.
Penyebaran di Tahun 2026
Penelitian di bidang VLA terus muncul dengan cepat hingga tahun 2026. ABot-M0, yang menggabungkan pembelajaran manifold aksi; ACE-Brain-0.5, model dasar terpadu untuk AI agenik yang terwujud; Kairos, yang mengintegrasikan model dunia dengan aksi — penelitian meluas melampaui sekadar "melihat dan bergerak" menuju pemodelan, mengingat, dan bertindak di dunia fisik secara terintegrasi. VLA sebagai konsep itu sendiri sedang Diposisikan ulang — dari teknologi khusus robotika menjadi elemen inti dari kerangka kerja "AI Fisik" yang lebih luas.
Di Mana Evaluasi Berakhir dan Operasi Robot Nyata Dimulai
Hasil benchmark VLA adalah pengukuran komparatif dalam kondisi terkontrol: robot pelatihan, penempatan kamera, kata-kata instruksi, kriteria keberhasilan, dan prosedur reset dipertahankan dalam definisi benchmark. Tingkat keberhasilan benchmark tidak dapat dibaca langsung sebagai klaim keselamatan untuk robot lain atau lingkungan kerja. Sebelum penyebaran, output aksi memerlukan lapisan pengawasan terpisah yang memberlakukan batas kecepatan, percepatan, dan sendi, dan menghentikan robot jika terjadi kehilangan komunikasi, waktu habis inferensi, atau kegagalan sensor.
Sebuah potongan aksi yang dihasilkan oleh VLA adalah prediksi berdasarkan pengamatan yang tersedia pada saat inferensi. Jika seseorang atau objek bergerak selama potongan tersebut, mengeksekusi seluruh potongan tanpa pengamatan lain akan meninggalkan perintah berdasarkan persepsi usang dalam sistem. Potongan yang lebih pendek dengan perencanaan ulang yang lebih sering meningkatkan responsivitas tetapi meningkatkan beban inferensi dan komunikasi. Potongan yang lebih panjang dapat lebih efisien, sementara bereaksi lebih lambat terhadap oklusi atau perubahan kontak. Jembatan praktis dari penelitian ke operasi adalah mengukur jarak berhenti, periode perencanaan ulang, dan tingkat pemulihan selain keberhasilan tugas.
Distribusi data pelatihan juga penting. Pencahayaan, material, gesekan sendi, dan latensi kamera yang berbeda dari kondisi pelatihan dapat muncul sebagai kesalahan tindakan pada robot nyata. Oleh karena itu, evaluasi harus memisahkan tugas yang diketahui berulang dari pengujian dengan objek yang dipindahkan, instruksi yang diparafrasekan, pemulihan setelah oklusi, dan komunikasi yang sengaja ditunda. Hanya meminta model untuk mencoba lagi setelah kegagalan tidak mengidentifikasi penyebabnya. Simpan gambar masukan, instruksi, tindakan yang dihasilkan, batasan pengawasan, dan alasan berhenti terhadap satu basis waktu bersama. Ini memudahkan untuk membedakan kesalahan persepsi dari kesalahan mekanis atau komunikasi dan untuk mengulangi evaluasi yang sama setelah pembaruan model.
Keputusan penyebaran juga harus bertahap. Keberhasilan dalam simulasi, kondisi berhenti yang berfungsi di laboratorium, dan penyelesaian tugas di lingkungan terbatas adalah bukti yang berbeda. Sebelum pindah ke ruang luar atau ruang yang digunakan bersama manusia, uji objek yang tidak dikenal, perubahan pencahayaan, baterai lemah, dan kehilangan jaringan, lalu dokumentasikan kondisi untuk mempercayainya. Model dan kondisi untuk mengembalikan kendali ke pengontrol konvensional. Menjelaskan batasan tersebut secara eksplisit mempertahankan fleksibilitas VLA tanpa mengorbankan verifikasi yang dibutuhkan oleh sistem kontrol.
Catatan eksperimen harus mencakup versi model dan bobot, resolusi input, waktu inferensi, periode kontrol, dan durasi penahanan aksi. Tanpa bidang-bidang ini, menjalankan kembali model yang sama tidak menghasilkan hasil yang sebanding. Bahkan "sukses" dapat berarti hal yang berbeda: menempatkan objek pada target, menghindari kontak, atau menyelesaikan tugas setelah pembatas ikut campur. Tetapkan kriteria sukses dan interupsi terlebih dahulu, dan laporkan secara terpisah apa yang dihasilkan model dan apa yang diizinkan oleh lapisan pengawas. Untuk menggunakan angka penelitian dalam keputusan operasional, kondisi pengukuran dan rentang yang tidak terukur harus ditulis dalam tabel yang sama.
Dalam operasi rutin, perilaku dapat berubah setelah penggantian kamera atau perubahan pencahayaan bahkan ketika model itu sendiri tidak disentuh. Untuk mendeteksi pergeseran distribusi, terus catat indikator kepercayaan, besaran aksi, dan jumlah intervensi oleh lapisan pengawas. Ketika nilai abnormal tetap ada, beralih ke mode lambat atau operasi manual lebih mudah didiagnosis daripada mencoba berulang kali. secara otomatis. Memperlakukan VLA sebagai salah satu komponen dalam sistem yang memisahkan observasi, inferensi, pembatasan, dan penghentian mendukung reproduksibilitas dan keamanan.
Apakah pemahaman instruksi yang tampak membuktikan tindakan robot yang aman?
Batasan tindakan, kondisi eksekusi, deteksi kegagalan, dan mekanisme penghentian tetap diperlukan. Bahasa yang lancar bukanlah bukti keberhasilan fisik.
Referensi
- Vision Language Action Models in Robotic Manipulation: A Systematic Review (arXiv)
- π0: Physical Intelligence Official Blog
- π0.7 Official Announcement
- π0.7 Paper (Physical Intelligence) )
- Manipulasi Presisi dengan RL Online yang Efisien (Kecerdasan Fisik)
- VLA dengan Memori Jangka Panjang dan Pendek (Kecerdasan Fisik)
- Liputan Repositori GitHub openpi Kecerdasan Fisik (Laporan Robot)
- Model Visi-Bahasa-Aksi (VLA) untuk Robotika (Blog Roboflow)
- Survei tentang Model Visi-Bahasa-Aksi: Perspektif Tokenisasi Aksi (arXiv)
- Blog Resmi Kecerdasan Fisik
- Makalah Pemaksaan Temporal (arXiv)
- [Makalah DriftingVLA] Makalah AdaVLA (IROS 2026, arXiv)
- Makalah AdaVLA (IROS 2026, arXiv)
- Makalah SMILE (arXiv)
Komentar
Silakan masuk terlebih dahulu.
Belum ada data.