Contents — find the section you need
विज़न-लैंग्वेज-एक्शन (VLA) मॉडल एक ऐसी संरचना है जो कैमरा फुटेज और प्राकृतिक भाषा के निर्देशों को एक ही सिस्टम में एकीकृत करती है, जिससे रोबोट की क्रियाएं (मोटर कमांड) सीधे आउटपुट होती हैं। रोबोटिक्स में पहले धारणा (पहचान) और नियंत्रण (योजना और निष्पादन) को अलग-अलग पाइपलाइन के रूप में डिजाइन करने की परंपरा के विपरीत, यहाँ मूल विचार सोच में बदलाव लाना है: दोनों को एक ही ट्रांसफॉर्मर मॉडल में एकीकृत करना।
 दृष्टि + भाषा → क्रिया
प्रमुख VLA कंपनियों (फिजिकल इंटेलिजेंस, आदि) के लिए कोई लाइसेंस-मुक्त आधिकारिक लोगो नहीं मिल सका, इसलिए दृष्टि, भाषा और क्रिया के एकीकरण को दर्शाने वाला एक सरल आइकन बनाया गया।
VLA एक नज़र में
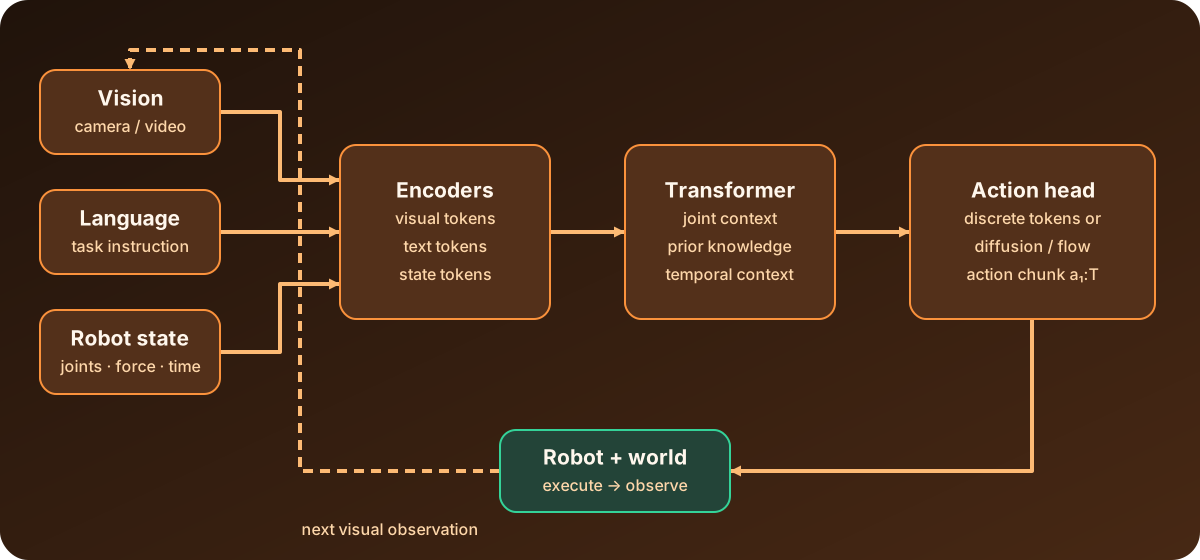
आरेख: डस्ककॉइल। यह VLA अनुमान और भौतिक जगत के बीच एक प्रतिनिधि संबंध को सरल बनाता है। प्रतिक्रिया।
एक वीएलए केवल एक मॉडल नहीं है जो छवियों और भाषा को पढ़ सकता है; यह एक बंद लूप का हिस्सा है जिसका आउटपुट भौतिक क्रिया से जुड़ा होता है। छवियों, निर्देशों और संयुक्त स्थिति को एक साझा प्रतिनिधित्व में मैप किया जाता है, एक ट्रांसफ़ॉर्मर संदर्भ को एकीकृत करता है, और एक एक्शन हेड इसे एक एक्शन चंक में परिवर्तित करता है। चूंकि निष्पादन के बाद का अवलोकन अगला इनपुट बन जाता है, इसलिए व्यावहारिक मूल्यांकन में न केवल मॉडल की सटीकता बल्कि अनुमान विलंबता, क्रिया की सुगमता और एक ऐसा तंत्र भी शामिल होना चाहिए जो व्यवहार असामान्य होने पर सुरक्षित रूप से रुक जाए।
वंश: आरटी-1 से आरटी-2 से ओपनवीएलए तक
गूगल का आरटी-1 एक प्रारंभिक प्रमुख उदाहरण था, और इसके उत्तराधिकारी आरटी-2 ने इस विचार को और आगे बढ़ाया, वेब-स्केल विज़न और भाषा डेटा पर पूर्व-प्रशिक्षित एक बड़े मॉडल से प्राप्त ज्ञान को रोबोट क्रियाओं को उत्पन्न करने की दिशा में पुनर्निर्देशित किया। ओपन-सोर्स पक्ष में, ओपन-वीएलए, ऑक्टो और क्लिप-आरटी जैसे मॉडल ने क्रॉस-मोडल अटेंशन (विज़न और भाषा को शामिल करने वाला एक पारस्परिक ध्यान तंत्र) के इर्द-गिर्द निर्मित ट्रांसफ़ॉर्मर-आधारित आर्किटेक्चर के साथ इसका अनुसरण किया है। इन सभी में जो बात समान है वह यह है कि "देखना," "समझना," और "अभिनय" को अलग-अलग मॉड्यूल में विभाजित नहीं किया जाता है — एक ही नेटवर्क को इनपुट (फुटेज और निर्देश) से लेकर आउटपुट (क्रिया) तक, शुरू से अंत तक प्रशिक्षित किया जाता है।
आंतरिक संरचना: तीन उपप्रणालियाँ
एक VLA मॉडल की कम्प्यूटेशनल संरचना को मोटे तौर पर तीन उपप्रणालियों के रूप में समझा जा सकता है। सबसे पहले, एक विज़न एनकोडर कैमरे से प्राप्त कच्चे पिक्सेल डेटा को एक संरचित विशेषता प्रतिनिधित्व में परिवर्तित करता है — अक्सर यह SigLIP या DINOv2 जैसे पूर्व-प्रशिक्षित छवि एनकोडरों का संयोजन होता है। इसके बाद एक प्रोजेक्शन मॉड्यूल (आमतौर पर एक बहु-परत परसेप्ट्रॉन) आता है जो निकाले गए दृश्य विशेषताओं को उस एम्बेडिंग स्पेस में मैप करता है जिसमें भाषा मॉडल काम करता है। अंत में, एक डिकोडर-ओनली ट्रांसफॉर्मर दृश्य और भाषा (निर्देश) टोकन के संयुक्त अनुक्रम को संसाधित करता है और अंतिम क्रिया उत्पन्न करता है।
क्रिया उत्पन्न करना: दो डिज़ाइन दृष्टिकोण
एक बार जब विज़न और भाषा एकीकृत हो जाते हैं, तो वास्तविक मोटर कमांड (क्रिया) कैसे उत्पन्न होती है, इसके लिए मोटे तौर पर दो डिज़ाइन दृष्टिकोण हैं।
एक यह असतत क्रिया टोकन का उपयोग करता है: सतत क्रिया मानों (जोड़ कोण, वेग, आदि) को निश्चित संख्या में बिन्स (उदाहरण के लिए 256) में विभाजित किया जाता है, और भाषा मॉडल की शब्दावली से उन टोकन आईडी का उपयोग क्रियाओं को दर्शाने के लिए किया जाता है जिनका अन्य उपयोग बहुत कम होता है। इसका लाभ यह है कि दृष्टि, भाषा और क्रिया सभी को एक ही प्रकार के "टोकन अनुक्रम" के रूप में समान रूप से संभाला जा सकता है, जिससे क्रिया अनुक्रम a_{1:T} स्वतः प्रतिगामी रूप से उत्पन्न होता है — अवलोकन o पर आधारित, और प्रत्येक अगला टोकन उससे पहले उत्पन्न टोकन के आधार पर उत्पन्न होता है।
यह सूत्रण प्राकृतिक भाषा निर्माण में अगले शब्द की भविष्यवाणी के समान ही आकार का है, और यह VLA के मूल विचार को समाहित करता है — दृष्टि, भाषा और क्रिया को एक ही संभाव्य मॉडल के भीतर संभालना।
दूसरा दृष्टिकोण प्रसार-आधारित क्रिया हेड का उपयोग करता है: ट्रांसफ़ॉर्मर का कार्य दृश्य को सारांशित करने वाला एक "रीडआउट टोकन" उत्पन्न करने तक सीमित हो जाता है। और भाषा संबंधी जानकारी, और वास्तविक निरंतर क्रिया मानों को उत्पन्न करने का कार्य एक प्रसार मॉडल को सौंप दिया जाता है। अलग-अलग चरणों में उत्पन्न होने वाले असतत क्रिया टोकन कभी-कभी वास्तविक समय की प्रतिक्रियाशीलता और सुगमता में कमी कर सकते हैं, जबकि प्रसार-आधारित क्रिया हेड अधिक सुगम, निरंतर क्रिया आउटपुट उत्पन्न करता है। इन दोनों का संयोजन भी तेजी से आम होता जा रहा है - उदाहरण के लिए, ऑक्टो छवि और भाषा टोकन को एक ही अनुक्रम के रूप में ट्रांसफ़ॉर्मर से गुजारता है, फिर इसके आउटपुट (रीडआउट टोकन) को एक शर्त के रूप में प्रसार-आधारित क्रिया हेड में भेजता है।
व्यवहार में इस डिज़ाइन का अर्थ
एक पारंपरिक नियंत्रण प्रणाली केवल अपनी स्क्रिप्ट का पालन करके ही उस स्थिति को संभाल सकती है जिसके लिए इसे डिज़ाइन नहीं किया गया था। वीएलए मॉडल का लाभ यह है कि यह उन स्थितियों के लिए सामान्यीकरण कर सकता है जिन पर इसे कभी स्पष्ट रूप से प्रशिक्षित नहीं किया गया था। गोदाम स्वचालन से लेकर शल्य चिकित्सा सहायता रोबोट तक, इसके अनुप्रयोगों का दायरा तेजी से बढ़ रहा है, और इसे तेजी से एम्बोडेड एआई के पीछे की मुख्य तकनीक के रूप में स्थापित किया जा रहा है। साथ ही, बड़े पैमाने पर मानव प्रदर्शन डेटा पर अत्यधिक निर्भरता, डेटा संग्रह और प्रशिक्षण दोनों में, एक बड़ी चुनौती बनी हुई है। लागत।
फिजिकल इंटेलिजेंस का π0 वंश
हाल ही में VLA में सबसे अधिक ध्यान आकर्षित करने वाले नामों में से एक है फिजिकल इंटेलिजेंस का π0 (पाई-ज़ीरो)। यह एक स्टार्टअप है जिसने 400 मिलियन डॉलर से अधिक की फंडिंग जुटाई है। इसे एक सामान्य-उद्देश्यीय रोबोट नीति के रूप में घोषित किया गया था, जो बड़े पैमाने पर बहु-कार्य, बहु-रोबोट डेटा संग्रह को एक नए नेटवर्क आर्किटेक्चर के साथ जोड़ती है, और विभिन्न प्रकार के कार्यों को संभालने में सक्षम है - कपड़े तह करना, मेज साफ करना, कॉफी बीन्स निकालना। फिजिकल इंटेलिजेंस ने π0 के कोड और वेट्स को ओपनपाई रिपॉजिटरी के रूप में ओपनसोर्स किया है, और तब से इसके बेहतर संस्करण जारी करता रहा है - π0.5, π0.6, π0.7। π0 बेस को कंपनी के अपने सात रोबोट प्लेटफॉर्म के साथ ओपन एक्स-एम्बोडिमेंट (OXE) डेटासेट पर प्रीट्रेन किया गया था, और इसे फाइन-ट्यूनिंग के लिए डिज़ाइन किए गए एक सामान्य-उद्देश्यीय मॉडल के रूप में बनाया गया है: प्रीट्रेनिंग डेटा द्वारा पहले से कवर किए गए कार्यों के लिए ज़ीरो-शॉट उपयोग योग्य, लेकिन विशिष्ट उपयोग के लिए अपेक्षित मार्ग के रूप में फाइन-ट्यूनिंग के साथ बनाया गया है। मामला।
फिजिकल इंटेलिजेंस की नवीनतम जानकारी: π0.7 और उससे आगे
फिजिकल इंटेलिजेंस के आधिकारिक ब्लॉग के अनुसार, π0 श्रृंखला ने 2026 तक लगातार नई क्षमताएं जोड़ी हैं। मार्च 2026 में दो लगातार रिलीज़ हुईं: एक ऐसी विधि जो VLA मॉडल से निकाले गए "RL टोकन" का उपयोग करके ऑनलाइन रीइन्फोर्समेंट लर्निंग के माध्यम से वास्तविक रोबोट हेरफेर कार्यों को तेजी से परिष्कृत करती है, और "मल्टी-स्केल एम्बोडेड मेमोरी", जो दस मिनट से अधिक समय तक चलने वाले कार्यों को संभालने के लिए दीर्घकालिक और अल्पकालिक मेमोरी को एकीकृत करती है। अप्रैल में घोषित π0.7 को एक स्टीयरेबल मॉडल के रूप में प्रस्तुत किया गया है - एक ऐसा मॉडल जिसे बाहरी रूप से निर्देशित किया जा सकता है - जो उभरती हुई क्षमताओं को प्रदर्शित करता है जो सामान्यीकरण प्रदर्शन में एक "महत्वपूर्ण बदलाव" लाती हैं। विकास का केंद्र बिंदु एकल-शॉट प्रदर्शन अनुकरण से हटकर वास्तविक स्वायत्त रोबोट संचालन के करीब की क्षमताओं की ओर स्थानांतरित होता दिख रहा है: मेमोरी, ऑनलाइन लर्निंग, स्टीयरेबिलिटी।
LIBERO संतृप्त हो रहा है, और गति की दौड़
LIBERO, सिमुलेशन बेंचमार्क जो मानक बन गया है VLA अनुसंधान में, 2026 की दूसरी छमाही तक कई विधियों ने 90% से अधिक की कार्य-सफलता दर हासिल कर ली है — सटीकता प्रभावी रूप से संतृप्ति के करीब पहुंच रही है। टेम्परल फोर्सिंग (अगस्त 2026), जो 4D दृश्य प्रतिनिधित्व के साथ संरेखित होकर अस्थायी-संदर्भ समझ को मजबूत करता है, LIBERO पर 98.8% सफलता दर हासिल करता है, जबकि कठिन "छिपे हुए स्थान निर्धारण" कार्य में सफलता दर को 20.0% से बढ़ाकर 43.3% कर देता है — यह संकेत है कि जैसे-जैसे मानक बेंचमार्क संतृप्त होता है, क्षेत्र का मूल्यांकन केंद्र कठिन सामान्यीकरण कार्यों की ओर स्थानांतरित हो रहा है।
विभिन्न विधियों में सटीकता के अभिसरण के साथ, अनुसंधान का केंद्र भी अनुमान गति को अनुकूलित करने की ओर स्थानांतरित हो गया है। ड्रिफ्टिंगVLA (अगस्त 2026), जो पारंपरिक बहु-चरणीय प्रसार प्रक्रिया को एकल फॉरवर्ड पास से प्रतिस्थापित करता है, LIBERO पर 98.32% सफलता दर बनाए रखता है, जबकि पुनरावृत्ति विधियों की तुलना में एक्शन-चंक जनरेशन में 3.36 गुना तेजी दर्ज करता है। AdaVLA (अगस्त 2026 में विकसित एक तकनीक (IROS 2026), जो पहले से प्रशिक्षित मॉडलों को पुनः प्रशिक्षित किए बिना उनकी गति बढ़ाती है, प्रवाह-मिलान प्रक्षेपवक्र की वक्रता से पीढ़ी की सटीकता का अनुमान लगाने वाला एक मीट्रिक प्रस्तुत करती है, जिससे π0.5 और X-VLA पर क्रमशः 1.87 गुना और 2.24 गुना गति वृद्धि बिना किसी अतिरिक्त प्रशिक्षण के प्राप्त होती है। SMILE (अगस्त 2026), जिसका उद्देश्य दीर्घकालिक कार्यों पर सुचारू गति उत्पन्न करना है, LIBERO पर 98.0% सफलता दर बनाए रखती है और B-स्प्लाइन गुणांकों की भविष्यवाणी करने वाले डिज़ाइन के माध्यम से 1.1 गुना गति वृद्धि दर्ज करती है - "सटीकता का त्याग किए बिना तेज़ गति" 2026 के उत्तरार्ध में VLA अनुसंधान के मुख्य बिंदुओं में से एक बन गई है।
2026 का प्रसार
VLA क्षेत्र में अनुसंधान 2026 में भी तेजी से जारी रहा है। ABot-M0, जो एक्शन-मैनिफोल्ड लर्निंग को समाहित करता है; ACE-Brain-0.5, मूर्त अभियांत्रिकी कृत्रिम बुद्धिमत्ता (एजेंटिक एआई) के लिए एक एकीकृत आधारभूत मॉडल; काइरोस, जो क्रिया के साथ एक विश्व मॉडल को एकीकृत करता है — अनुसंधान सरल "देखना और चलना" से आगे बढ़कर भौतिक जगत में मॉडलिंग, स्मरण और क्रिया करने की दिशा में एकीकृत हो रहा है। वीएलए (VLA) की अवधारणा को भी पुनःस्थापित किया जा रहा है — रोबोटिक्स-विशिष्ट तकनीक से हटकर व्यापक "भौतिक एआई" ढांचे के एक प्रमुख तत्व के रूप में।
मूल्यांकन कहाँ समाप्त होता है और वास्तविक रोबोट संचालन कहाँ से शुरू होता है
वीएलए बेंचमार्क परिणाम नियंत्रित परिस्थितियों में तुलनात्मक माप हैं: प्रशिक्षण रोबोट, कैमरा प्लेसमेंट, निर्देश शब्दावली, सफलता मानदंड और रीसेट प्रक्रिया बेंचमार्क परिभाषा के भीतर रखी जाती हैं। बेंचमार्क सफलता दर को सीधे किसी अन्य रोबोट या कार्य वातावरण के लिए सुरक्षा दावे के रूप में नहीं पढ़ा जा सकता है। तैनाती से पहले, क्रिया आउटपुट को एक अलग पर्यवेक्षी परत की आवश्यकता होती है जो वेग, त्वरण और संयुक्त सीमाओं को लागू करती है, और संचार हानि, अनुमान समय समाप्ति या सेंसर विफलता पर रोबोट को रोकती है।
वीएलए द्वारा उत्पन्न एक क्रिया खंड एक भविष्यवाणी है जो इस पर आधारित है अनुमान लगाने के समय उपलब्ध अवलोकन। यदि चंक के दौरान कोई व्यक्ति या वस्तु हिलती है, तो बिना किसी अन्य अवलोकन के पूरे चंक को निष्पादित करने से सिस्टम में पुरानी धारणा पर आधारित कमांड रह जाते हैं। अधिक बार पुनर्योजना के साथ छोटे चंक प्रतिक्रियाशीलता में सुधार करते हैं, लेकिन अनुमान और संचार भार बढ़ाते हैं। लंबे चंक अधिक कुशल हो सकते हैं, जबकि अवरोध या संपर्क परिवर्तनों पर प्रतिक्रिया धीमी होती है। अनुसंधान से संचालन तक व्यावहारिक सेतु कार्य की सफलता के अलावा स्टॉपिंग दूरी, पुनर्योजना अवधि और रिकवरी दर को मापना है।
प्रशिक्षण डेटा का वितरण भी मायने रखता है। प्रकाश, सामग्री, जोड़ घर्षण और कैमरा विलंबता जो प्रशिक्षण स्थितियों से भिन्न होते हैं, वास्तविक रोबोट पर क्रिया त्रुटियों के रूप में दिखाई दे सकते हैं। इसलिए मूल्यांकन में दोहराए गए ज्ञात कार्यों को गतिमान वस्तुओं, पुनर्लिखित निर्देशों, अवरोध के बाद रिकवरी और जानबूझकर विलंबित संचार वाले परीक्षणों से अलग किया जाना चाहिए। किसी विफलता के बाद मॉडल को पुनः प्रयास करने के लिए कहना ही कारण की पहचान नहीं करता है। इनपुट छवि, निर्देश, उत्पन्न क्रिया, पर्यवेक्षी सीमाएं और रुकने का कारण एक साझा समय आधार के विरुद्ध संग्रहीत करें। इससे यांत्रिक या संचार दोष से धारणा त्रुटि को अलग करना और मॉडल के बाद उसी मूल्यांकन को दोहराना आसान हो जाता है। अपडेट।
तैनाती संबंधी निर्णय भी चरणबद्ध तरीके से लिए जाने चाहिए। सिमुलेशन में सफलता, प्रयोगशाला में काम करने वाली स्टॉप स्थिति और सीमित वातावरण में कार्य पूर्णता, ये सभी अलग-अलग प्रमाण हैं। बाहरी या मानव-साझा स्थानों में जाने से पहले, अज्ञात वस्तुओं, प्रकाश परिवर्तन, कम बैटरी और नेटवर्क हानि का परीक्षण करें, फिर मॉडल पर भरोसा करने की स्थितियों और नियंत्रण को पारंपरिक नियंत्रक को वापस सौंपने की स्थितियों को दस्तावेज़ित करें। इस सीमा को स्पष्ट करने से नियंत्रण प्रणाली के लिए आवश्यक सत्यापनशीलता को छोड़े बिना वीएलए की लचीलता बनी रहती है।
प्रयोग रिकॉर्ड में मॉडल और भार संस्करण, इनपुट रिज़ॉल्यूशन, अनुमान समय, नियंत्रण अवधि और क्रिया-होल्ड अवधि शामिल होनी चाहिए। इन फ़ील्ड के बिना, उसी मॉडल को दोबारा चलाने से तुलनीय परिणाम प्राप्त नहीं होते हैं। यहां तक कि "सफलता" का भी अर्थ अलग-अलग हो सकता है: लक्ष्य पर वस्तु रखना, संपर्क से बचना, या किसी सीमाक के हस्तक्षेप के बाद कार्य पूरा करना। सफलता और व्यवधान मानदंडों को पहले से परिभाषित करें, और मॉडल द्वारा उत्पादित और पर्यवेक्षी परत द्वारा अनुमत परिणामों की अलग-अलग रिपोर्ट करें। परिचालन निर्णय में अनुसंधान संख्याओं का उपयोग करने के लिए, माप स्थितियों और अमापित सीमा को एक ही प्रारूप में लिखा जाना चाहिए। तालिका।
नियमित संचालन में, कैमरा बदलने या प्रकाश व्यवस्था में परिवर्तन के बाद भी व्यवहार बदल सकता है, भले ही मॉडल में कोई बदलाव न हुआ हो। वितरण में बदलाव का पता लगाने के लिए, विश्वास संकेतक, क्रिया परिमाण और पर्यवेक्षी परत द्वारा किए गए हस्तक्षेपों की संख्या को रिकॉर्ड करते रहें। जब असामान्य मान बने रहते हैं, तो स्वचालित रूप से बार-बार प्रयास करने की तुलना में धीमे मोड या मैन्युअल संचालन पर स्विच करना निदान के लिए आसान होता है। अवलोकन, अनुमान, सीमा निर्धारण और रोकने को अलग करने वाली प्रणाली में VLA को एक घटक के रूप में मानने से पुनरुत्पादकता और सुरक्षा दोनों को बढ़ावा मिलता है।
क्या स्पष्ट निर्देश समझ सुरक्षित रोबोट क्रिया स्थापित करती है?
क्रिया सीमाएँ, निष्पादन स्थितियाँ, विफलता का पता लगाना और रोकने के तंत्र आवश्यक बने रहते हैं। धाराप्रवाह भाषा भौतिक सफलता का प्रमाण नहीं है।
संदर्भ
- रोबोटिक हेरफेर में विज़न लैंग्वेज एक्शन मॉडल: एक व्यवस्थित समीक्षा (arXiv)
- π0: भौतिक बुद्धिमत्ता आधिकारिक ब्लॉग
- π0.7 आधिकारिक घोषणा
- π0.7 पेपर (भौतिक बुद्धिमत्ता)
- कुशल ऑनलाइन आरएल के साथ सटीक हेरफेर (भौतिक बुद्धिमत्ता)
- दीर्घ और अल्पकालिक स्मृति वाले वीएलए (भौतिक बुद्धिमत्ता)
- भौतिक बुद्धिमत्ता ओपनपीआई गिटहब रिपॉजिटरी कवरेज (द रोबोट रिपोर्ट)
- रोबोटिक्स के लिए विजन-लैंग्वेज-एक्शन (वीएलए) मॉडल (रोबोफ्लो ब्लॉग)
- [एक सर्वेक्षण] विज़न-लैंग्वेज-एक्शन मॉडल: एक एक्शन टोकनाइज़ेशन परिप्रेक्ष्य (arXiv)](https://arxiv.org/pdf/2507.01925)
- फिजिकल इंटेलिजेंस आधिकारिक ब्लॉग
- टेम्पोरल फोर्सिंग पेपर (arXiv)
- ड्रिफ्टिंगवीएलए पेपर (arXiv)
- एडीएवीएलए पेपर (IROS 2026, arXiv)
- स्माइल पेपर (arXiv)
टिप्पणियाँ
पहले लॉग इन करें।
अभी कोई डेटा नहीं है।