Contents — find the section you need
Los modelos de Visión-Lenguaje-Acción (VLA) constituyen una arquitectura que integra imágenes de cámara e instrucciones en lenguaje natural en un único sistema, generando directamente las acciones del robot (comandos motores). A diferencia de la tradición robótica que concebía la percepción (reconocimiento) y el control (planificación y ejecución) como procesos separados, la idea central aquí radica en un cambio de enfoque: integrar ambos en un único modelo transformador.
 Visión + Lenguaje → Acción
No se encontró ningún logotipo oficial libre de derechos de las principales empresas de VLA (Inteligencia Física, etc.), por lo que se creó un icono sencillo que representa la integración de visión, lenguaje y acción.
VLA de un vistazo
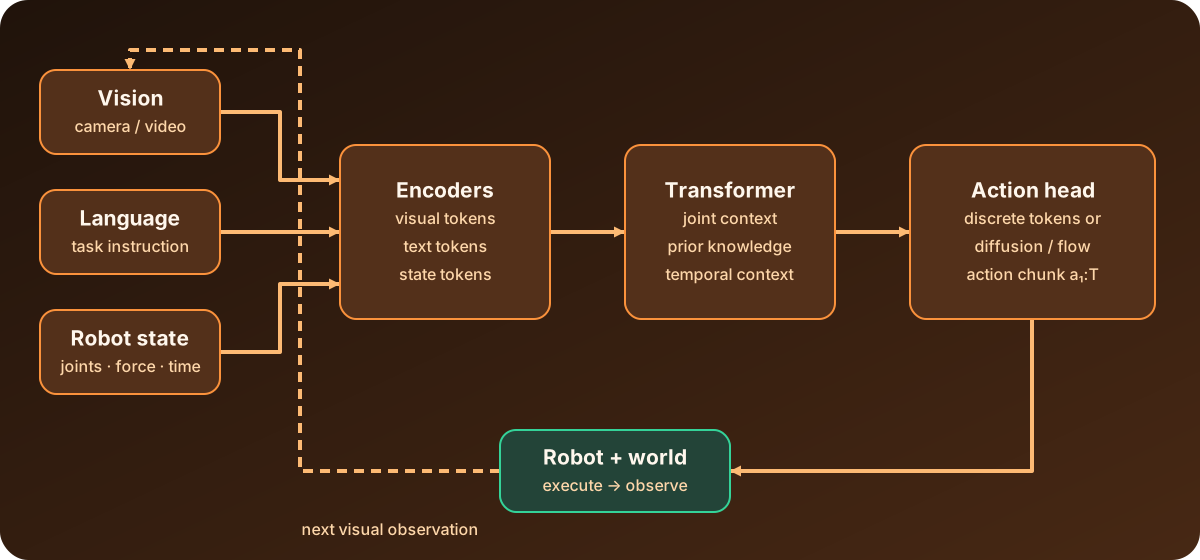
Diagrama: Duskcoil. Simplifica una relación representativa entre la inferencia VLA y la retroalimentación del mundo físico.
Un VLA no es simplemente un modelo que puede leer imágenes y lenguaje; Forma parte de un bucle cerrado cuya salida está conectada a la acción física. Las imágenes, las instrucciones y el estado de las articulaciones se mapean en una representación compartida, un transformador integra el contexto y un módulo de acción lo convierte en un fragmento de acción. Dado que la observación posterior a la ejecución se convierte en la siguiente entrada, la evaluación práctica debe incluir no solo la precisión del modelo, sino también la latencia de la inferencia, la fluidez de la acción y un mecanismo que se detenga de forma segura cuando el comportamiento se vuelva anómalo.
Linaje: De RT-1 a RT-2 y OpenVLA
RT-1 de Google fue un ejemplo emblemático inicial, y su sucesor, RT-2, desarrolló aún más la idea, redirigiendo el conocimiento de un modelo grande preentrenado con datos de visión y lenguaje a escala web hacia la generación de acciones robóticas. En el ámbito del código abierto, modelos como Open-VLA, Octo y CLIP-RT han seguido con arquitecturas basadas en transformadores construidas en torno a la atención multimodal (un mecanismo de atención mutua que abarca la visión y el lenguaje). Lo que todos comparten es que "ver", "comprender" y "actuar" no se dividen en módulos separados: una única red se entrena de extremo a extremo, desde la entrada. (Imágenes más instrucciones) hasta la salida (acción).
Estructura interna: Tres subsistemas
La arquitectura computacional de un modelo VLA se puede entender como tres subsistemas. Primero, un codificador de visión convierte los datos de píxeles sin procesar de la cámara en una representación de características estructurada, a menudo una combinación de codificadores de imagen preentrenados como SigLIP o DINOv2. A continuación, un módulo de proyección (generalmente un perceptrón multicapa) mapea las características visuales extraídas al espacio de incrustación en el que trabaja el modelo de lenguaje. Finalmente, un transformador decodificador procesa la secuencia concatenada de tokens visuales y de lenguaje (instrucciones) y genera la acción final.
Generación de la acción: Dos enfoques de diseño
Una vez integrados la visión y el lenguaje, existen dos enfoques de diseño principales para generar el comando motor (la acción).
Uno utiliza tokens de acción discretos: los valores de acción continuos (ángulos articulares, velocidades, etc.) se discretizan. Los tokens se clasifican en un número fijo de contenedores (por ejemplo, 256), y los identificadores de tokens del vocabulario del modelo de lenguaje, que tienen poco uso, se reutilizan para representar acciones. La ventaja es que la visión, el lenguaje y la acción se pueden gestionar de forma uniforme como una misma "secuencia de tokens", generando la secuencia de acciones a_{1:T} de forma autorregresiva —condicionada a la observación o—, generando cada token siguiente en función de los generados anteriormente.
Esta formulación tiene exactamente la misma estructura que la predicción de la siguiente palabra en la generación de lenguaje natural y captura la idea central de VLA: gestionar la visión, el lenguaje y la acción dentro del mismo modelo probabilístico.
El otro enfoque utiliza un cabezal de acción basado en difusión: la función del transformador se reduce a producir un "token de lectura" que resume la información visual y lingüística, y la generación de los valores de acción continuos se delega a un modelo de difusión. Los tokens de acción discretos, al generarse por etapas, a veces pueden fallar. Un sistema de control basado en difusión carece de capacidad de respuesta en tiempo real y fluidez, mientras que un cabezal de acción basado en difusión tiende a producir una salida de acción más fluida y continua. Las combinaciones de ambos también son cada vez más comunes: Octo, por ejemplo, introduce tokens de imagen y lenguaje a través de un transformador como una secuencia única, y luego pasa su salida (el token de lectura) como una condición a un cabezal de acción basado en difusión.
¿Qué significa este diseño en la práctica?
Un sistema de control clásico solo puede manejar una situación para la que no fue diseñado siguiendo su guion y nada más. La ventaja de un modelo VLA es la posibilidad de generalizar a condiciones para las que nunca fue entrenado explícitamente. Su rango de aplicación se está expandiendo rápidamente, desde la automatización de almacenes hasta los robots de asistencia quirúrgica, y se está posicionando cada vez más como la tecnología central de la IA encarnada. Al mismo tiempo, la gran dependencia de datos de demostración humana a gran escala sigue siendo un desafío importante, tanto en la recopilación de datos como en el costo del entrenamiento.
El linaje π0 de la inteligencia física
Uno de los nombres que más atención ha atraído en VLA recientemente es π0 (pi-cero). De Physical Intelligence, una startup que ha recaudado más de 400 millones de dólares. Se anunció como una política robótica de propósito general, que combina la recopilación de datos a gran escala para múltiples tareas y robots con una nueva arquitectura de red, capaz de realizar una amplia gama de tareas: doblar la ropa, recoger una mesa, servir café. Physical Intelligence publicó el código y los pesos de π0 como código abierto en el repositorio openpi, y desde entonces ha seguido lanzando versiones mejoradas: π0.5, π0.6 y π0.7. La base de π0 se preentrenó con el conjunto de datos Open X-Embodiment (OXE) junto con las siete plataformas robóticas propias de la compañía, y está diseñada como un modelo de propósito general pensado para el ajuste fino: utilizable sin necesidad de entrenamiento previo para tareas ya cubiertas por los datos de preentrenamiento, pero concebido para el ajuste fino como la ruta prevista para un caso de uso específico.
Últimas novedades de Physical Intelligence: π0.7 y más allá
Siguiendo el blog oficial de Physical Intelligence, la línea π0 ha seguido añadiendo nuevas funcionalidades. Capacidad en constante desarrollo hasta 2026. En marzo de 2026 se lanzaron dos versiones consecutivas: un método que utiliza un "Token RL" extraído del modelo VLA para refinar rápidamente tareas de manipulación de robots reales mediante aprendizaje por refuerzo en línea, y "Memoria Incorporada Multiescala", que integra memoria a corto y largo plazo para gestionar tareas de más de diez minutos. π0.7, anunciado en abril, se posiciona como un modelo dirigible —que puede ser guiado externamente— y exhibe capacidades emergentes que representan un salto cualitativo en el rendimiento de generalización. El centro de gravedad del desarrollo parece estar desplazándose de la imitación de demostraciones puntuales hacia capacidades mucho más cercanas a la operación de robots genuinamente autónomos: memoria, aprendizaje en línea y capacidad de dirección.
Saturación de LIBERO y la carrera por la velocidad
LIBERO, el referente de simulación que se ha convertido en estándar en la investigación de VLA, ha visto cómo varios métodos alcanzan tasas de éxito en tareas superiores al 90% en la segunda mitad de 2026; la precisión se acerca prácticamente a la perfección. Saturación. Temporal Forcing (agosto de 2026), que mejora la comprensión del contexto temporal mediante la alineación con una representación de escena 4D, obtiene un 98,8 % en LIBERO, a la vez que aumenta el éxito en una tarea más compleja de "ubicación oculta" del 20,0 % al 43,3 %, lo que indica que, a medida que el estándar de referencia se satura, el enfoque de evaluación del campo se desplaza hacia tareas de generalización más exigentes.
Con la convergencia de la precisión entre los distintos métodos, la investigación también se ha centrado en optimizar la velocidad de inferencia. DriftingVLA (agosto de 2026), que reemplaza el proceso de difusión convencional de múltiples pasos con una única pasada hacia adelante, mantiene un éxito del 98,32 % en LIBERO, a la vez que reporta una aceleración de 3,36 veces en la generación de fragmentos de acción en comparación con los métodos iterativos. AdaVLA (agosto de 2026, IROS 2026), que acelera los modelos ya entrenados sin necesidad de volver a entrenarlos, introduce una métrica que estima la confianza de la generación. A partir de la curvatura de la trayectoria de coincidencia de flujo, se lograron aceleraciones de 1,87x y 2,24x en π0.5 y X-VLA, respectivamente, sin entrenamiento adicional. SMILE (agosto de 2026), orientado a la generación de movimiento suave en tareas de largo plazo, también mantiene un 98,0 % de éxito en LIBERO, reportando una aceleración de 1,1x mediante un diseño que predice coeficientes B-spline. "Más rápido sin sacrificar precisión" se ha convertido en uno de los ejes principales de la investigación en VLA durante la segunda mitad de 2026.
La expansión de 2026
La investigación en el ámbito de VLA ha seguido apareciendo a un ritmo acelerado durante todo 2026. ABot-M0, que incorpora el aprendizaje de la variedad de acciones; ACE-Brain-0.5, un modelo base unificado para la IA agente encarnada; Kairos, que integra un modelo del mundo con la acción: la investigación se está ampliando más allá del simple "ver y moverse" hacia Modelado, memoria y actuación en el mundo físico de forma integrada. El concepto de VLA se está reposicionando: de una tecnología específica de robótica a un elemento central del marco más amplio de la "IA física".
Dónde termina la evaluación y comienza la operación del robot real
Los resultados de la evaluación comparativa de VLA son mediciones comparativas en condiciones controladas: el robot de entrenamiento, la ubicación de la cámara, la redacción de las instrucciones, el criterio de éxito y el procedimiento de reinicio se mantienen dentro de la definición de la evaluación comparativa. Una tasa de éxito en la evaluación comparativa no puede interpretarse directamente como una garantía de seguridad para otro robot o entorno de trabajo. Antes de la implementación, la acción resultante requiere una capa de supervisión independiente que imponga límites de velocidad, aceleración y articulaciones, y detenga el robot en caso de pérdida de comunicación, tiempo de espera de inferencia agotado o fallo del sensor.
Un fragmento de acción generado por un VLA es una predicción basada en la observación disponible en el momento de la inferencia. Si una persona u objeto se mueve durante el fragmento, ejecutarlo completo sin una nueva observación deja comandos basados en una percepción obsoleta. Sistema. Los bloques más cortos con replanificación más frecuente mejoran la capacidad de respuesta, pero aumentan la carga de inferencia y comunicación. Los bloques más largos pueden ser más eficientes, aunque reaccionan más lentamente a la oclusión o a los cambios de contacto. El paso práctico de la investigación a la operación consiste en medir la distancia de frenado, el período de replanificación y la tasa de recuperación, además del éxito de la tarea.
La distribución de los datos de entrenamiento también es importante. La iluminación, el material, la fricción de las articulaciones y la latencia de la cámara, que difieren de las condiciones de entrenamiento, pueden manifestarse como errores de acción en el robot real. Por lo tanto, la evaluación debe separar las tareas repetidas conocidas de las pruebas con objetos en movimiento, instrucciones parafraseadas, recuperación tras oclusión y comunicación deliberadamente retrasada. Simplemente pedirle a un modelo que vuelva a intentarlo después de un fallo no identifica la causa. Almacene la imagen de entrada, la instrucción, la acción generada, los límites de supervisión y el motivo de la parada en una base de tiempo compartida. Esto facilita distinguir un error de percepción de una falla mecánica o de comunicación, y repetir la misma evaluación después de una actualización del modelo.
Las decisiones de despliegue también deben planificarse cuidadosamente. El éxito en la simulación, una condición de parada que funcione en un laboratorio y la finalización de la tarea en un entorno limitado son diferentes tipos de evidencia. Antes de mover el robot En espacios exteriores o compartidos, pruebe objetos desconocidos, cambios de iluminación, batería baja y pérdida de red. Luego, documente las condiciones para confiar en el modelo y las condiciones para devolver el control a un controlador convencional. Al explicitar este límite, se preserva la flexibilidad de un VLA sin renunciar a la verificabilidad requerida por un sistema de control.
El registro del experimento debe incluir la versión del modelo y de los pesos, la resolución de entrada, el tiempo de inferencia, el período de control y la duración de la retención de la acción. Sin estos campos, volver a ejecutar el mismo modelo no produce un resultado comparable. Incluso el término "éxito" puede tener diferentes significados: colocar un objeto en el objetivo, evitar el contacto o completar una tarea después de que interviniera un limitador. Defina los criterios de éxito e interrupción con anticipación e informe por separado lo que produjo el modelo y lo que permitió la capa de supervisión. Para utilizar los datos de la investigación en una decisión operativa, las condiciones de medición y el rango no medido deben estar registrados en la misma tabla.
En la operación rutinaria, el comportamiento puede cambiar después de reemplazar una cámara o cambiar la iluminación, incluso cuando el modelo en sí no se modifica. Para detectar cambios en la distribución, registre continuamente los indicadores de confianza, las magnitudes de las acciones y el número de Intervenciones de la capa de supervisión. Cuando persisten valores anómalos, cambiar a un modo lento o a una operación manual facilita el diagnóstico en comparación con reintentos automáticos repetidos. Considerar un VLA como un componente de un sistema que separa la observación, la inferencia, la limitación y la detención favorece tanto la reproducibilidad como la seguridad.
¿La aparente comprensión de las instrucciones garantiza una acción segura del robot?
Los límites de acción, las condiciones de ejecución, la detección de fallos y los mecanismos de detención siguen siendo necesarios. El dominio del lenguaje no es prueba de éxito físico.
Referencias
- Vision Language Action Models in Robotic Manipulation: A Systematic Review (arXiv)
- π0: Physical Intelligence Official Blog
- π0.7 Official Announcement
- π0.7 Paper
- [π0.7 Paper] Inteligencia Física
- Manipulación precisa con aprendizaje por refuerzo en línea eficiente (Inteligencia Física)
- Asociaciones Visión-Lenguaje-Acción (VLA) con memoria a largo y corto plazo (Inteligencia Física)
- Cobertura del repositorio openpi de GitHub de Inteligencia Física (The Robot Report)
- Modelos Visión-Lenguaje-Acción (VLA) para Robótica (Blog de Roboflow)
- Un estudio sobre modelos Visión-Lenguaje-Acción: una perspectiva de tokenización de acciones (arXiv)
- Blog oficial de Inteligencia Física
- Forzamiento temporal
- [Forzamiento temporal]( Artículo (arXiv)
- Artículo DriftingVLA (arXiv)
- Artículo AdaVLA (IROS 2026, arXiv)
- Artículo SMILE (arXiv)
Comentarios
Inicia sesión para continuar.
Todavía no hay datos.