Contents — find the section you need
Un modelo del mundo es un término general para un modelo que aprende a predecir cómo cambiará el estado de un entorno cuando un agente realiza una acción a. En robótica y aprendizaje por refuerzo, funciona como un simulador interno para "probar cosas mentalmente antes de actuar en el mundo real"; en el contexto de la IA de generación de vídeo, sirve como base para "no solo generar vídeo de aspecto plausible, sino también simular el entorno mismo según las leyes físicas". Es un concepto que ha atraído una atención cada vez mayor en los últimos años desde ambos lados.
 NVIDIA Cosmos
Imagen: NVIDIA logo, Wikimedia Commons. Aquí se presenta a la empresa que desarrolla la serie Cosmos de Modelos de Fundamentos Mundiales para IA física.

Modelos Mundiales en un Diagrama
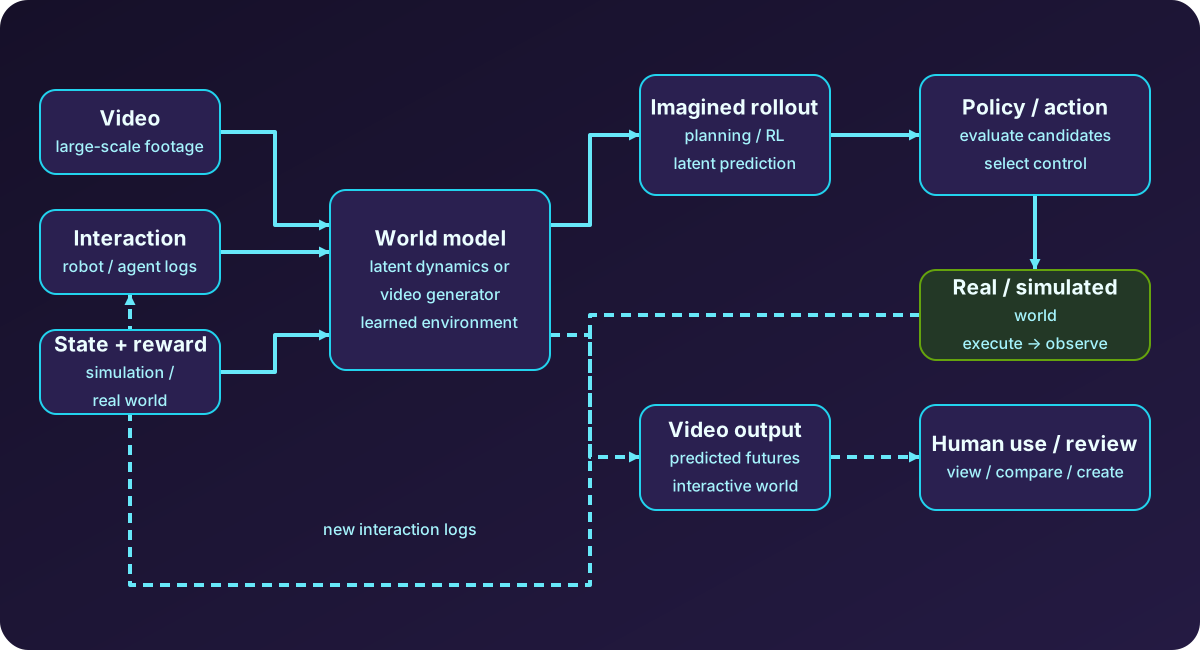
Diagrama: creado por Duskcoil. Un diagrama único y simplificado que combina su uso como simulador interno para el aprendizaje por refuerzo basado en modelos con su uso como modelo de generación de vídeo.
El eje para comprender los Modelos Mundiales se divide en dos preguntas: qué se predice (píxeles de vídeo sin procesar o una representación latente comprimida) y para qué se utiliza (un simulador interno para el aprendizaje de políticas o la generación de vídeo para que lo vea un humano). El mismo término "Modelo del Mundo" puede referirse a un modelo de dinámica latente probabilística que sustenta el aprendizaje de un robot desde la simulación a la realidad, como en Dreamer, o a un modelo de generación de vídeo con decenas de miles de millones de parámetros, como en Sora o Genie. Este es un campo donde las discusiones pueden resultar incomprensibles si no se mantiene el contexto claro.
Origen: Del artículo original de Ha y Schmidhuber a DreamerV3
El punto de partida de la difusión del término "Modelos del Mundo" en su sentido actual se remonta a un artículo de 2018 de David Ha y Jürgen Schmidhuber. En su configuración, un VAE (autoencoder variacional) comprime las observaciones visuales en una representación compacta, y una RNN (LSTM) predice cómo cambia esa representación con el tiempo; demostraron que un agente podía entrenar una política completamente "dentro" de este espacio latente aprendido.
Este diseño se mejoró sustancialmente en PlaNet en 2019, cuyo RSSM (Modelo de Espacio de Estados Recurrente) combinó componentes deterministas y estocásticos para mejorar significativamente la precisión y la consistencia de las predicciones en múltiples pasos. Mientras que PlaNet resolvía un plan en cada paso como control predictivo basado en modelos (MPC), el posterior Dreamer fue más allá, aprendiendo una política (actor) y una función de valor (crítico) directamente mediante retropropagación dentro del modelo del mundo; un diseño que se convirtió en la plantilla básica para la "familia Dreamer" desde entonces. DreamerV2 introdujo representaciones latentes discretas, y DreamerV3, publicado en Nature en 2025, demostró un rendimiento generalizable a diversos dominios, incluyendo la extracción de diamantes en Minecraft, sin necesidad de ajustar hiperparámetros fijos, elevando sustancialmente el nivel de utilidad práctica de los modelos del mundo en el aprendizaje por refuerzo basado en modelos.
Convergencia desde la IA generativa: Sora, Genie, World Labs
Independientemente del linaje del aprendizaje por refuerzo, el término "modelo del mundo" también comenzó a utilizarse en el ámbito de la IA de generación de vídeo. En 2024, OpenAI argumentó en su informe técnico sobre el modelo de generación de vídeo Sora que "escalar los modelos de generación de vídeo es una vía prometedora para construir simuladores de propósito general del mundo físico", citando ejemplos como la persistencia de las pinceladas en un lienzo y las marcas de mordiscos que quedan tras comer una hamburguesa, como prueba de que Sora había aprendido implícitamente algunos aspectos de las leyes físicas y la causalidad.
La serie Genie de Google DeepMind impulsó aún más esta dirección: en diciembre de 2024, Genie 2 demostró que podía generar un entorno 3D controlable a partir de una sola imagen, y en agosto de 2025, Genie 3 podía generar mundos 3D explorables, persistentes y en tiempo real, de varios minutos de duración, a partir de una indicación de texto, a 24 fotogramas por segundo y con una resolución de 720p. DeepMind presenta esta tecnología como una forma escalable de generar datos de entrenamiento para navegación, percepción y razonamiento a largo plazo en robótica. En febrero de 2026, se informó que Waymo la había adoptado para la simulación de conducción autónoma.
World Labs, fundada por Fei-Fei Li de Stanford, anunció su producto comercial Marble en noviembre de 2025. Marble genera entornos 3D persistentes y descargables (exportables como Gaussian Splatting, mallas o vídeo) a partir de fragmentos de texto, imágenes o vídeo. En un ensayo publicado en junio de 2026, Li clasificó funcionalmente los Modelos del Mundo en tres categorías: Renderizador (genera vídeo para visualización humana), Simulador (genera una representación geométrica y físicamente fiel que un programa puede utilizar para cálculos) y Planificador (determina la siguiente acción a partir de observaciones y un objetivo). Los sistemas de generación de vídeo como Sora y Genie se sitúan más cerca del Renderizador, los modelos de dinámica de aprendizaje robótico más cerca del Simulador y el VLA más cerca del Planificador.
NVIDIA Cosmos: Un Modelo Fundamental para la Robótica
Un enfoque que está ganando terreno en la industria robótica es la serie Cosmos de NVIDIA. Cosmos 3, anunciado en junio de 2026, adopta una arquitectura de transformadores mixtos que unifica el razonamiento visual, la generación del mundo y la predicción de acciones en un único modelo, gestionando múltiples modalidades (texto, imagen, vídeo, audio ambiental y acción) dentro de un mismo marco. El objetivo es un sistema de generación de datos: en lugar de realizar miles de horas de pruebas en un brazo robótico real, se generan grandes volúmenes de vídeo simulado de un robot realizando una tarea, se entrena una política con esos datos y, posteriormente, se implementa en hardware real. NVIDIA ha formado la Coalición Cosmos con socios como Agile Robots, Black Forest Labs, Runway y Skild AI, creando un ecosistema abierto para los Modelos de la Fundación Mundial.
Generativo o no: JEPA de LeCun como eje opuesto
Lo que Sora, Genie y Cosmos tienen en común es un diseño que genera píxeles directamente (o una representación similar). Yann LeCun, antiguo científico jefe de IA en Meta AI, siempre ha mantenido una postura escéptica respecto a este enfoque generativo. Su propuesta JEPA (Arquitectura Predictiva de Incrustación Conjunta) es un diseño que marca una clara diferencia al predecir dentro de un espacio de representación abstracto y nunca generar píxeles ni tokens. Se informa que V-JEPA 2, basado en esta filosofía de diseño, alcanzó aproximadamente un 80 % de éxito en tareas de manipulación robótica sin entrenamiento previo, tras un preentrenamiento con cerca de un millón de horas de vídeo de internet y un ajuste fino con tan solo 62 horas de datos de manipulación robótica. LeCun dejó Meta a principios de 2026, fundó AMI Labs en París y recaudó más de mil millones de dólares en financiación inicial para centrarse en la creación de un Modelo Mundial de propósito general. En esta fase, está poniendo a prueba su afirmación de que "los modelos generativos son un callejón sin salida como Modelos Mundiales".
A fecha de 2026, aún no se ha determinado cuál de los enfoques generativos y no generativos (estilo JEPA) es superior. Los modelos generativos tienen la ventaja de producir vídeos que los humanos pueden evaluar directamente a simple vista, mientras que se dice que los enfoques estilo JEPA ofrecen una ventaja en eficiencia computacional y estabilidad de predicción a largo plazo al predecir en una representación abstracta; sin embargo, ninguno de los dos ha demostrado aún una ventaja decisiva en su implementación a gran escala en el mundo real.
Desafíos abiertos: Consistencia física, coherencia a largo plazo y evaluación
Consistencia física: Se han señalado numerosos ejemplos concretos de violaciones de las leyes físicas en el vídeo generado por Sora: objetos que flotan sin tener en cuenta la gravedad, una llama de vela que no se mueve, una hormiga con un número incorrecto de patas, comportamiento antinatural de los fragmentos al romperse un cristal. El análisis ha demostrado que incluso los modelos más potentes fallan en cuanto a la gravedad, la permanencia de los objetos y la coherencia causal. La evaluación neutral en este momento es que, si bien Sora 2 ha aprendido claramente "algo" sobre la estructura 3D y la causalidad física, ese algo no es lo mismo que un motor de física convencional.
Coherencia a largo plazo: Si el estado de un entorno puede mantenerse sin fallar durante periodos superiores a decenas de segundos sigue siendo un desafío sin resolver. Los criterios de evaluación propuestos en 2026, como WorldRoamBench, evalúan la estabilidad a largo plazo en cuatro ejes: fidelidad de la acción, fallos visuales (deriva), consistencia física y consistencia de la memoria (si se recuerdan las ubicaciones y los objetos visitados previamente). Estos criterios señalan que muchos métodos de evaluación existentes solo analizaban ventanas cortas de 5 a 10 segundos.
Dificultad de la evaluación: Todavía no existe consenso sobre cómo medir cuantitativamente un "buen modelo del mundo". La naturalidad visual del vídeo generado y su utilidad en las tareas posteriores de control del robot no siempre coinciden, y dado que la escala semántica de los resultados difiere entre los modelos, se ha señalado que comparar trayectorias de forma justa entre ellos resulta difícil.
Coste computacional: Evaluar y entrenar modelos del mundo a gran escala es costoso; se estima que una sola llamada a la API puede costar más de un dólar. Los modelos que aprenden y evalúan tareas a largo plazo pueden generar cerca de 100 000 tokens en una sola respuesta, lo que se está convirtiendo en una barrera para la reproducibilidad de la investigación.
El punto de conexión con el aprendizaje robótico
Un ejemplo destacado de la aplicación directa de los Modelos del Mundo a la robótica es el Modelo del Mundo en vídeo que 1X Technologies desarrolló para su robot humanoide, NEO (véase «Tendencias tecnológicas en robots humanoides» para más detalles). El diseño, en el que un modelo de generación de vídeo con 14 000 millones de parámetros imagina «un breve vídeo de la tarea completada», que luego se convierte en comandos motores reales mediante un Modelo de Dinámica Inversa, es un ejemplo concreto de cómo conectar un Renderizador (generación de vídeo) directamente con un Planificador (generación de acciones).
En el contexto clásico del aprendizaje por refuerzo, el aprendizaje por refuerzo basado en modelos (MBRL) lleva años abordando este concepto de forma más sólida. El diseño del aprendizaje de un modelo del mundo \hat f_\theta que predice el siguiente estado a partir de un estado s y una acción a, la evaluación de secuencias de acciones candidatas dentro del modelo antes de su implementación en hardware real, cómo se gestiona la acumulación de errores de predicción mediante la aleatorización del dominio y el proceso gradual para pasar de la simulación a la realidad: todo esto se aborda en detalle en "Una introducción al aprendizaje por refuerzo basado en modelos y la transición de la simulación a la realidad". Los modelos del mundo al estilo de la generación de vídeo y los modelos de dinámica latente de MBRL operan en diferentes niveles de resolución de representación, pero comparten la misma idea central: probarlo dentro de un modelo aprendido antes de probarlo todo en hardware real.
Situación actual
- Objetivo: entornos virtuales/de vídeo para que los humanos los visualicen: Modelos generativos del mundo como Sora, Genie 3 y Marble de World Labs. Visualmente atractivo, pero no se garantiza el rigor físico.
- Objetivo: generar datos para el aprendizaje y la evaluación de políticas robóticas: Diseños como NVIDIA Cosmos y el modelo 1X World, que conectan la tecnología de generación de vídeo directamente con la generación de acciones robóticas. Se espera que faciliten la recopilación de datos en hardware real.
- Objetivo: un simulador interno para el aprendizaje por refuerzo basado en modelos: Modelos de dinámica latente de la familia DreamerV3. Son relativamente ligeros computacionalmente y fáciles de integrar directamente en un bucle de aprendizaje de políticas, pero limitados en la complejidad de las observaciones que pueden manejar.
- Objetivo: aprendizaje de representaciones y predicción de propósito general: Enfoques no generativos de la familia V-JEPA. Evitan el coste de la generación de píxeles al tiempo que buscan un rendimiento de transferencia a tareas posteriores.
Todas estas tendencias se basan en el mismo fundamento: internalizar la dinámica de un entorno mediante el aprendizaje, pero se diferencian según lo que generan y para quién (o qué) se generan: un humano, un programa o un bucle de aprendizaje de políticas. Esa es la realidad a partir de 2026.
¿Los vídeos realistas del futuro permiten realizar predicciones físicas precisas?
La plausibilidad visual y la dinámica condicionada por la acción difieren.
Comparar los cambios de estado previstos con las transiciones reales bajo las mismas acciones. ## Referencias - [World Models, artículo original (Ha & Schmidhuber, 2018)](https://worldmodels.github.io/) - [Blog oficial de Dreamer (Google Research)](https://research.google/blog/introducing-dreamer-scalable-reinforcement-learning-using-world-models/) - [Artículo de DreamerV3, "Dominando diversas tareas de control mediante modelos del mundo" (Nature)](https://www.nature.com/articles/s41586-025-08744-2) - [Modelos de generación de vídeo como simuladores del mundo (OpenAI, oficial)](https://openai.com/index/video-generation-models-as-world-simulators/) - [Genie 3: Una nueva frontera para los modelos del mundo (Google DeepMind, oficial)](https://deepmind.google/blog/genie-3-a-new-frontier-for-world-models/) - [Genie 2: Un modelo del mundo fundamental a gran escala (Google DeepMind, oficial)](https://deepmind.google/blog/genie-2-a-large-scale-foundation-world-model/) - [Anuncio de World Labs Marble] (TechCrunch)](https://techcrunch.com/2025/11/12/fei-fei-lis-world-labs-speeds-up-the-world-model-race-with-marble-its-first-commercial-product/) - [Una taxonomía funcional de los modelos del mundo (Fei-Fei Li, blog oficial)](https://drfeifei.substack.com/p/a-functional-taxonomy-of-world-models) - [Anuncio de NVIDIA Cosmos 3 (Sala de prensa de NVIDIA)](https://nvidianews.nvidia.com/news/nvidia-launches-cosmos-3-the-open-frontier-foundation-model-for-physical-ai) - [V-JEPA (Meta AI, oficial)](https://ai.meta.com/blog/v-jepa-yann-lecun-ai-model-video-joint-embedding-predictive-architecture/) - [Artículo de WorldRoamBench (arXiv)](https://arxiv.org/abs/2606.31672) - Para obtener más información sobre el aprendizaje por refuerzo basado en modelos y la simulación a la realidad, consulte también "[Una introducción al aprendizaje por refuerzo basado en modelos y la simulación a la realidad](/es/blog/posts/reinforcement-model-based.html)"
Comentarios
Inicia sesión para continuar.
Todavía no hay datos.