Contents — find the section you need
Un modèle du monde est un terme général désignant un modèle qui apprend à prédire comment l'état d'un environnement évoluera lorsqu'un agent entreprend une action. En robotique et en apprentissage par renforcement, il fonctionne comme un simulateur interne permettant de « tester mentalement des solutions avant d'agir dans le monde réel ». Dans le contexte de l'IA de génération vidéo, il sert de base non seulement pour générer des vidéos d'apparence plausible, mais aussi pour simuler l'environnement lui-même selon les lois physiques. Ce concept a suscité un intérêt croissant ces dernières années.
 NVIDIA Cosmos
Image: NVIDIA logo, Wikimedia Commons. Featured here as the company developing the Cosmos series of World Foundation Models for physical AI.

Modèles du monde en un seul diagramme
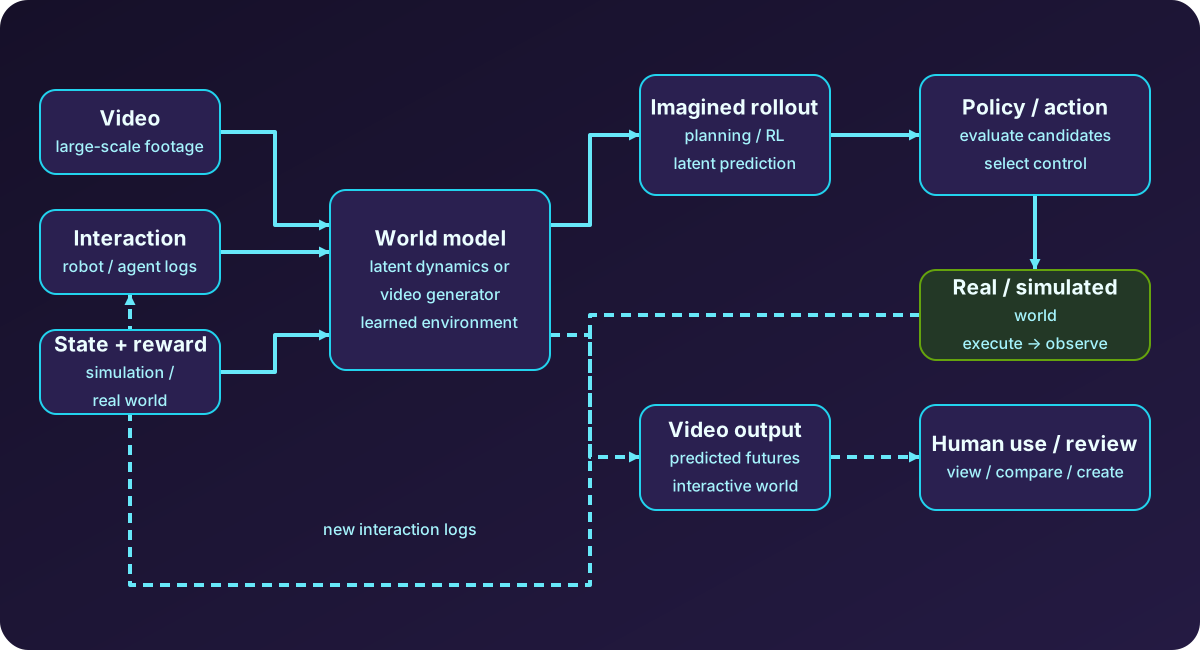
Diagramme : créé par Duskcoil. Un diagramme unique et simplifié combinant l'utilisation comme simulateur interne pour l'apprentissage par renforcement basé sur un modèle et l'utilisation comme modèle de génération vidéo.
L'axe de compréhension des modèles du monde se divise en deux questions : qu'est-ce qui est prédit ? (pixels vidéo bruts ou représentation latente compressée) et à quoi cela sert-il ? (simulateur interne pour l'apprentissage de politiques ou génération vidéo pour un utilisateur). Le terme « Modèle du monde » peut désigner aussi bien un modèle probabiliste de dynamique latente sous-jacent à l'apprentissage d'un robot entre simulation et réalité, comme dans Dreamer, qu'un modèle de génération vidéo comportant des dizaines de milliards de paramètres, comme dans Sora ou Genie. Dans ce domaine, les discussions peuvent vite se heurter à des malentendus si le contexte n'est pas clairement défini.
Origine : De l'article original de Ha et Schmidhuber à DreamerV3
L'essor du terme « Modèles du monde » dans son acception actuelle remonte à un article de 2018 de David Ha et Jürgen Schmidhuber. Dans leur dispositif, un VAE (auto-encodeur variationnel) compresse les observations visuelles en une représentation compacte, et un RNN (LSTM) prédit l'évolution de cette représentation au fil du temps ; ils ont démontré qu'un agent pouvait entraîner une politique entièrement « à l'intérieur » de cet espace latent appris.
Cette conception a été considérablement améliorée dans PlaNet en 2019, dont le modèle RSSM (Recurrent State-Space Model) combinait des composantes déterministes et stochastiques afin d'améliorer significativement la précision et la cohérence des prédictions multi-étapes. Alors que PlaNet résolvait un plan à chaque étape grâce à la commande prédictive par modèle (MPC), Dreamer, qui a suivi, est allé plus loin en apprenant une politique (acteur) et une fonction de valeur (critique) directement par rétropropagation au sein du modèle du monde – une conception qui est devenue depuis le modèle de base de la « famille Dreamer ». DreamerV2 a introduit des représentations latentes discrètes, et DreamerV3, publié dans Nature en 2015, a démontré des performances généralisables à divers domaines – y compris l'extraction de diamants dans Minecraft – sans réglage fixe des hyperparamètres, rehaussant considérablement le niveau d'exigence quant à l'utilité pratique des modèles du monde dans l'apprentissage par renforcement basé sur un modèle.
Convergence du côté de l'IA générative : Sora, Genie, World Labs
Indépendamment de l'apprentissage par renforcement, le terme « modèle du monde » a également commencé à être utilisé du côté de l'IA de génération vidéo. En 2024, OpenAI affirmait dans son rapport technique sur le modèle de génération vidéo Sora que « l'extension des modèles de génération vidéo est une voie prometteuse pour la création de simulateurs généralistes du monde physique », citant des exemples tels que les coups de pinceau persistants sur une toile et les marques de dents restant après la consommation d'un hamburger, comme preuves que Sora avait implicitement appris certains aspects des lois physiques et de la causalité.
La série Genie de Google DeepMind a poussé cette approche plus loin : en décembre 2024, Genie 2 a démontré sa capacité à générer un environnement 3D contrôlable à partir d'une seule image, et en août 2025, Genie 3 pouvait générer des mondes 3D persistants, explorables en temps réel pendant plusieurs minutes, à partir d'une simple commande textuelle, à 24 images par seconde et en résolution 720p. DeepMind présente cette technologie comme un moyen évolutif de générer des données d'entraînement pour la navigation, la perception et le raisonnement à long terme en robotique. En février 2026, il a été annoncé que Waymo l'avait adoptée pour la simulation de conduite autonome.
World Labs, fondée par Fei-Fei Li de Stanford, a annoncé son produit commercial Marble en novembre 2025. Marble génère des environnements 3D persistants et téléchargeables (exportables au format Gaussian Splatting, maillages ou vidéo) à partir de fragments de texte, d'images ou de vidéo. Dans un essai publié en juin 2026, Li a classé les modèles du monde en trois catégories fonctionnelles : Rendu (qui produit une vidéo visible par l'œil humain), Simulateur (qui produit une représentation géométriquement et physiquement fidèle utilisable par un programme pour les calculs) et Planificateur (qui détermine l'action suivante à partir d'observations et d'un objectif). Les systèmes de génération vidéo comme Sora et Genie se rapprochent ainsi du Rendu, les modèles de dynamique d'apprentissage robotique du Simulateur et les VLA du Planificateur.
NVIDIA Cosmos : Un modèle de base pour la robotique
La série Cosmos de NVIDIA est une approche qui gagne en popularité dans le secteur de la robotique. Cosmos 3, annoncé en juin 2026, adopte une architecture hybride de transformateurs qui unifie le raisonnement visuel, la génération d’environnements et la prédiction d’actions au sein d’un modèle unique. Ce modèle gère de multiples modalités (texte, image, vidéo, audio environnemental et action) dans un cadre unique. L’objectif est de créer un pipeline de génération de données : plutôt que d’exécuter des milliers d’heures d’essais sur un bras robotisé réel, il s’agit de générer de grands volumes de vidéos simulées d’un robot effectuant une tâche, d’entraîner une politique sur ces données, puis de la déployer sur du matériel réel. NVIDIA a formé la Cosmos Coalition avec des partenaires tels qu’Agile Robots, Black Forest Labs, Runway et Skild AI, afin de développer un écosystème ouvert pour les modèles de base.
Génératif ou non : JEPA de LeCun comme contre-exemple
Sora, Genie et Cosmos ont en commun une conception qui génère directement des pixels (ou une représentation proche). Yann LeCun, ancien directeur scientifique de l'IA chez Meta AI, a toujours adopté une position sceptique vis-à-vis de cette approche générative. Son architecture JEPA (Joint Embedding Predictive Architecture) propose une approche radicalement différente : elle prédit au sein d'un espace de représentation abstrait sans jamais générer de pixels ni de jetons. V-JEPA 2, basé sur cette philosophie, aurait atteint un taux de réussite d'environ 80 % sur des tâches de manipulation robotique sans exemple d'entraînement, après un pré-entraînement sur près d'un million d'heures de vidéo Internet et un ajustement fin sur seulement 62 heures de données de manipulation robotique. Début 2026, LeCun quitte Meta, fonde AMI Labs à Paris et lève plus d'un milliard de dollars de fonds d'amorçage pour se consacrer à la création d'un modèle du monde à usage général. Il entre ainsi dans une phase où il met à l'épreuve son affirmation selon laquelle « les modèles génératifs sont une impasse en tant que modèles du monde ».
En 2026, la supériorité respective des approches génératives et non génératives (de type JEPA) reste incertaine. Les modèles génératifs ont l'avantage de produire des vidéos directement exploitables visuellement, tandis que les approches de type JEPA sont réputées pour leur efficacité de calcul et la stabilité de leurs prédictions à long terme grâce à une représentation abstraite. Cependant, aucune de ces approches n'a encore démontré d'avantage décisif lors d'un déploiement à grande échelle dans le monde réel.
Défis ouverts : Cohérence physique, cohérence à long terme et évaluation
Cohérence physique : De nombreux exemples concrets de violations des lois physiques ont été relevés dans la vidéo générée par Sora : des objets flottant en ignorant la gravité, une flamme de bougie immobile, une fourmi avec un nombre de pattes incorrect, un comportement anormal des fragments de verre lors de leur bris. L’analyse a montré que même les modèles les plus performants échouent en matière de gravité, de permanence des objets et de cohérence causale. Le constat neutre actuel est que, bien que Sora 2 ait clairement appris « quelque chose » concernant la structure 3D et la causalité physique, cet apprentissage diffère de celui d’un moteur physique conventionnel.
Cohérence à long terme : La capacité à maintenir l’état d’un environnement sans dégradation sur des durées supérieures à plusieurs dizaines de secondes demeure un défi non résolu. Les bancs d'essai d'évaluation proposés en 2026, tels que WorldRoamBench, évaluent la stabilité à long terme selon quatre axes : la fidélité des actions, la dérive visuelle, la cohérence physique et la cohérence de la mémoire (la mémorisation des lieux et objets précédemment visités). Ils soulignent également que de nombreuses méthodes d'évaluation existantes se limitaient initialement à des fenêtres d'observation de 5 à 10 secondes.
Difficulté de l'évaluation : Il n'existe pas encore de consensus sur la manière de mesurer quantitativement un « bon modèle du monde ». Le naturel visuel de la vidéo générée et son utilité pour les tâches de contrôle robotique en aval ne sont pas nécessairement corrélés. De plus, l'échelle sémantique des sorties variant d'un modèle à l'autre, il a été démontré que la comparaison équitable des trajectoires entre les modèles est complexe.
Coût de calcul : L'évaluation et l'entraînement de modèles du monde à grande échelle sont coûteux ; un seul appel d'API peut coûter plus d'un dollar. Les modèles qui apprennent et évaluent des tâches à long terme peuvent générer près de 100 000 jetons en une seule réponse, ce qui constitue un obstacle à la reproductibilité de la recherche.
Le lien avec l'apprentissage robotique
Un exemple éloquent d'application directe des modèles du monde à la robotique est le modèle du monde vidéo développé par 1X Technologies pour son robot humanoïde NEO (voir « Tendances technologiques en robotique humanoïde » pour plus de détails). Ce modèle, composé de 14 milliards de paramètres, imagine une courte vidéo de la réalisation de la tâche, qui est ensuite convertie en commandes motrices via un modèle de dynamique inverse. Il illustre concrètement la connexion directe entre un moteur de rendu (génération vidéo) et un planificateur (génération d'actions).
Dans le contexte classique de l'apprentissage par renforcement, l'apprentissage par renforcement basé sur un modèle (MBRL) traite ce concept de manière plus concrète depuis des années. La conception de l'apprentissage d'un modèle du monde \hat f_\theta qui prédit l'état suivant à partir d'un état s et d'une action a, l'évaluation des séquences d'actions candidates au sein de ce modèle avant leur déploiement sur du matériel réel, la gestion de l'accumulation des erreurs de prédiction par randomisation du domaine, et le processus par étapes pour passer de la simulation au réel — tout cela est traité en détail dans « Introduction à l'apprentissage par renforcement basé sur un modèle et au passage de la simulation au réel ». Les modèles du monde de type génération vidéo et les modèles de dynamique latente de MBRL fonctionnent à différents niveaux de résolution représentationnelle, mais partagent la même idée fondamentale : tester au sein d'un modèle appris avant de tout essayer sur du matériel réel.
État actuel
-
Objectif : environnements vidéo/virtuels pour l'observation humaine : Modèles du monde génératifs comme Sora, Genie 3 et Marble de World Labs. Visuellement convaincant, mais la rigueur physique n'est pas garantie.
-
Objectif : générer des données pour l'apprentissage et l'évaluation des politiques robotiques : Des solutions comme NVIDIA Cosmos et le modèle 1X World Model, qui connectent directement la technologie de génération vidéo à la génération d'actions robotiques, devraient faciliter la collecte de données sur du matériel réel.
-
Objectif : un simulateur interne pour l'apprentissage par renforcement basé sur un modèle : Modèles de dynamique latente de la famille DreamerV3. Relativement légers en termes de calcul et faciles à intégrer directement dans une boucle d'apprentissage de politiques, ils sont cependant limités par la complexité des observations qu'ils peuvent traiter.
-
Objectif : apprentissage de représentations et prédiction à usage général : Approches non génératives de la famille V-JEPA. Elles permettent d'éviter le coût de la génération de pixels tout en optimisant les performances de transfert vers les tâches en aval.
Chacune de ces tendances repose sur le même principe : l'internalisation de la dynamique d'un environnement par l'apprentissage. Elles se différencient cependant selon leurs résultats et leur destinataire : un humain, un programme ou une boucle d'apprentissage de politiques. Voilà la réalité en 2026.
Une vidéo réaliste du futur permet-elle d'établir une prédiction physique précise ?
La plausibilité visuelle et la dynamique conditionnée par l'action diffèrent. Comparer les changements d'état prédits aux transitions réelles pour les mêmes actions.
## Références - [World Models, article original (Ha & Schmidhuber, 2018)](https://worldmodels.github.io/) - [Blog officiel de Dreamer (Google Research)](https://research.google/blog/introducing-dreamer-scalable-reinforcement-learning-using-world-models/) - [Article DreamerV3, « Maîtriser diverses tâches de contrôle grâce aux modèles du monde » (Nature)](https://www.nature.com/articles/s41586-025-08744-2) - [Modèles de génération vidéo comme simulateurs du monde (OpenAI, officiel)](https://openai.com/index/video-generation-models-as-world-simulators/) - [Genie 3 : Une nouvelle frontière pour les modèles du monde (Google DeepMind, officiel)](https://deepmind.google/blog/genie-3-a-new-frontier-for-world-models/) - [Genie 2 : Un modèle du monde fondamental à grande échelle (Google DeepMind, officiel)](https://deepmind.google/blog/genie-2-a-large-scale-foundation-world-model/) - [Annonce de World Labs Marble] (TechCrunch) - Taxonomie fonctionnelle des modèles du monde (Fei-Fei Li, blog officiel) - Annonce de NVIDIA Cosmos 3 (Salle de presse NVIDIA) - V-JEPA (Meta AI, officiel) - Article WorldRoamBench (arXiv) - Pour plus de détails sur l'apprentissage par renforcement basé sur des modèles et la conversion simulation-réel, voir également « Introduction à l'apprentissage par renforcement basé sur des modèles et à la conversion simulation-réel ».
Commentaires
Veuillez vous connecter.
Aucune entrée pour le moment.