Contents — find the section you need
L'exécution d'un modèle de langage complexe sur sa propre machine, sans intervention d'une API cloud (appelée « LLM local »), est devenue possible ces dernières années. Elle résulte de la convergence de deux tendances : l'amélioration des modèles à poids ouverts et la réduction de la taille des modèles grâce aux techniques de quantification.
 Ollama
 Hugging Face
Image : Ollama / Hugging Face logos, Wikimedia Commons


Aperçu de l’inférence locale
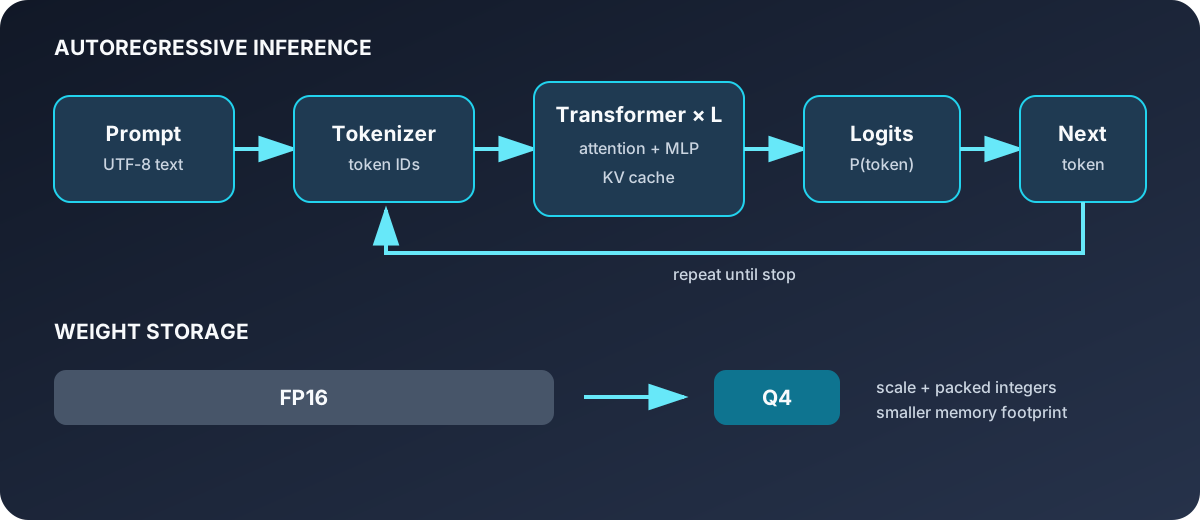
Diagramme : Duskcoil. Le chemin de génération et le rôle de la quantification des poids sont présentés séparément.
Pour comprendre un LLM local, il est essentiel de distinguer la boucle d'inférence répétée de la mémoire nécessaire au modèle. Le texte devient des identifiants de jetons ; le transformateur calcule une distribution pour le jeton suivant ; et le jeton sélectionné est renvoyé à l'entrée. La quantification, quant à elle, modifie principalement la façon dont les poids sont stockés et calculés afin qu'un modèle tienne dans une RAM ou une VRAM limitée. Une comparaison de déploiement pertinente prend donc en compte non seulement le nom du modèle, mais aussi son format de poids, le cache KV qui s'étend avec la longueur du contexte, et les backends CPU/GPU disponibles.
L'essor rapide des modèles à poids ouverts
Le paysage des modèles à poids ouverts, en 2026, évolue constamment à une échelle de quelques mois. DeepSeek mise sur une haute efficacité dans ses versions Flash et Pro ; Qwen, autrefois considéré comme un concurrent sérieux, est désormais reconnu comme une solution de premier plan pour le raisonnement de niveau master, grâce à la grande variété d'options matérielles et de tailles de modèles qu'il propose. Llama 4 de Meta offre une fenêtre de contexte pouvant atteindre 10 millions de jetons pour un modèle ouvert. Plus récemment, GLM-5.2 de Z.ai a réalisé un bond en avant significatif en termes de performances des agents de codage et a été intégré aux frameworks d'agents quelques jours seulement après sa sortie. Kimi K2.7 Code HighSpeed revendique quant à lui une accélération de 6x pour le raisonnement de codage multimodal : le rythme des évolutions est extrêmement rapide.
Les résultats des benchmarks témoignent également d'un changement important. Sur les suites d'évaluation de codage de type SWE Benchmark, l'écart entre les meilleurs modèles open-weight et les principaux modèles commerciaux s'est réduit à quelques points de pourcentage, et certains affirment même que cet écart a quasiment disparu pour les tâches d'ingénierie quotidiennes.
Les Fondements : Le Mécanisme d'Attention
Tous les grands modèles de langage actuels, y compris ceux utilisés par Ollama, reposent sur l'architecture Transformer, dont le cœur est l'auto-attention. À partir des matrices de requête Q, de clé K et de valeur V issues de la séquence d'entrée, le modèle calcule l'attention par produit scalaire normalisé comme suit :
QK^\top représente le degré de similarité entre les tokens. La division par \sqrt{d_k} (la racine carrée de la dimension de la clé) empêche les produits scalaires de devenir trop importants et d'annuler le gradient de la fonction softmax. La répétition de cette opération sur l'ensemble des paramètres et des couches du modèle constitue l'inférence Transformer. La réduction de la taille de ces paramètres (les matrices de poids) est précisément le rôle de la quantification, que nous aborderons ci-après.
La forme de base de la quantification linéaire
L'idée sous-jacente à GGUF, AWQ et GPTQ est la quantification linéaire : la conversion d'un poids à virgule flottante x en un entier de poids faible q.
s représente l'échelle (la largeur réelle de chaque pas) et z le point zéro (où, dans la représentation entière, le zéro réel se situe). Ces deux paramètres d'étalonnage, ainsi que la manière dont chaque méthode détermine ces deux valeurs et la granularité à laquelle elles sont appliquées (modèle entier, par couche, par poids), expliquent les différences de performance observées.
La maturité de la quantification : GGUF, AWQ, GPTQ
Outre l'amélioration des performances du modèle, la quantification – la réduction de la taille du modèle – est devenue tout aussi essentielle. Les méthodes de quantification telles que GGUF, AWQ et GPTQ ont permis de réduire la taille des modèles d'environ 70 % tout en maintenant la perte de précision sous la barre des 2 %. C'est ainsi qu'un modèle à 32 milliards de classes de paramètres tient désormais dans 16 Go de mémoire. L'inférence locale sur du matériel grand public standard atteint maintenant 70 à 85 % de la qualité d'un modèle haut de gamme, sans coût supplémentaire par requête.
Chacun des trois formats présente ses propres atouts. GGUF (anciennement GGML) est le format natif de llama.cpp et de son écosystème (Ollama, LM Studio, etc.), et excelle dans l'inférence hybride CPU+GPU. GPTQ se distingue par sa vitesse d'inférence brute sur les configurations exclusivement GPU, et AWQ est généralement considéré comme la meilleure option en termes de rapport précision/taille avec une quantification sur 4 bits. Pour le développement local courant, GGUF via Ollama est souvent recommandé par défaut.
Différences techniques entre les trois méthodes de quantification
GGUF, AWQ et GPTQ sont des méthodes de quantification qui réduisent la taille des poids du modèle, initialement en virgule flottante 16 ou 32 bits, à environ 4 bits. Cependant, elles y parviennent par des moyens techniques différents.
GPTQ considère la quantification comme un problème d'optimisation. Elle utilise approximativement les informations du second ordre de la fonction de perte (la matrice hessienne) pour déterminer quels poids ont le plus d'impact sur le résultat. Ensuite, à mesure que chaque poids est quantifié, l'erreur résultante est répartie en compensation entre les poids non encore quantifiés de la même ligne. Cette méthode est axée sur les performances d'inférence GPU ; la quantification d'un modèle à 7 milliards de paramètres prend environ 2 à 4 heures sur un seul GPU A100.
AWQ, en revanche, ne se concentre pas sur l'étape de quantification elle-même, mais sur la détermination des poids réellement importants. Il effectue une phase de calibration qui observe les activations réelles du modèle, identifie les poids « saillants » ayant un impact significatif sur la qualité de la sortie, et quantifie de manière intensive tout le reste tout en conservant une haute précision pour ces poids. Il nécessite moins d'échantillons de calibration que GPTQ (environ 128 à 512, contre plus de 2 048 pour GPTQ), ce qui le rend nettement plus rapide : environ 10 à 30 minutes pour un modèle de 7 milliards d'éléments.
GGUF (format natif de llama.cpp) utilise un schéma appelé « K-quants », attribuant une profondeur de bits différente à chaque couche : 6 bits pour une couche à haute importance comme l'attention, 4 bits pour une couche de propagation directe, etc., ce qui permet d'obtenir une qualité par bit supérieure à celle d'une quantification uniforme naïve sur 4 bits. Une configuration représentative, Q4_K_M, conserverait environ 92 % de la qualité du modèle original.
Ces différences techniques déterminent directement le cas d'utilisation le plus approprié à chaque méthode. AWQ est recommandé pour l'inférence haute vitesse exclusivement sur GPU ; GPTQ est privilégié lorsqu'un écosystème GPU mature et une vaste bibliothèque de modèles pré-quantifiés sont essentiels ; GGUF (via Ollama, etc.) est recommandé lorsque la facilité d'utilisation dans un environnement hybride CPU/GPU est la priorité.
llama.cpp : Fonctionnement du moteur d'inférence locale
De nombreux environnements d'exécution LLM locaux, dont Ollama, reposent sur llama.cpp, un moteur d'inférence écrit en C/C++, et GGML, la bibliothèque de tenseurs sous-jacente. GGML est une bibliothèque de calcul de tenseurs légère et peu dépendante, comparable à PyTorch ou TensorFlow, qui représente l'ensemble du calcul d'un modèle sous forme de « graphe de calcul ». Certains tenseurs contiennent des données (comme les poids), tandis que d'autres représentent simplement le résultat d'une opération entre d'autres tenseurs, sans valeur tant que le calcul n'est pas exécuté. Ce graphe de calcul peut être exécuté directement sur le processeur ou traduit en instructions pour un accélérateur (CUDA pour les GPU NVIDIA, Metal pour le matériel Apple). Cette portabilité, permettant d'exécuter le même fichier de modèle sur une large gamme de configurations matérielles, constitue le fondement technique de la popularité du format GGUF.
Les chiffres de cette croissance
La rapidité de cette diffusion se traduit concrètement par des chiffres. Le nombre de téléchargements mensuels d'Ollama est passé de 100 000 au premier trimestre 2023 à 52 millions au premier trimestre 2026, soit une multiplication par 520 en trois ans. Le nombre de modèles au format GGUF sur Hugging Face, formatés pour l'inférence locale, est passé de 200 à 135 000 sur la même période. llama.cpp, le projet à la base de tout cela, a dépassé les 73 000 étoiles sur GitHub.
Panorama des modèles publiés fin 2026
En suivant le blog officiel d'Ollama, on constate que les publications majeures se sont succédé durant le second semestre 2026. Le 10 août, Meta Superintelligence Labs a publié son premier modèle ouvert, un modèle multimodal de 30 milliards de paramètres baptisé « Muse Glimmer », sous licence Apache 2.0. Le lendemain, 11 août, NVIDIA annonçait « Nemotron 3.5 Lightning », un modèle de 30 milliards de paramètres conçu pour les tâches multi-étapes. Le 29 juin, une mise à jour a permis d'améliorer la vitesse d'exécution de Gemma 4 jusqu'à 90 % sur l'environnement d'exécution MLX d'Apple Silicon, poursuivant ainsi l'amélioration de la vitesse d'exécution pour les cas d'utilisation d'agents de programmation. Ollama a annoncé une levée de fonds de 88 millions de dollars le 9 juillet et a fait état de 8,9 millions d'utilisateurs développeurs. L'écosystème des modèles open-weight dépasse le simple cadre de la « publication de modèles » et prend la forme d'une véritable infrastructure commerciale.
À la pointe de la quantification : NVFP4, une nouvelle option
Après GGUF, AWQ et GPTQ, la recherche sur NVFP4 — un format à virgule flottante 4 bits conçu pour l’architecture Blackwell de NVIDIA — s’est rapidement développée jusqu’en 2026 en tant que nouveau format de quantification. Une étude de juin 2026 a révélé qu’une taille de bloc de 16 offre le meilleur compromis précision/stockage. ScaleSweep (mai 2026), qui optimise les valeurs initiales d’échelle des blocs par une recherche par balayage, est l’une des méthodes qui démontrent désormais qu’une quantification même agressive peut préserver plus de 93 % des performances en pleine précision. Des techniques de post-traitement ont également émergé, comme H-Scale (août 2026), qui affine les valeurs d’échelle par groupe à l’aide d’une approximation hessienne du second ordre sans surcharge de temps d’inférence supplémentaire. Ceci indique que la recherche sur la quantification évolue : on ne se concentre plus sur « comment réduire les poids » mais sur « comment récupérer la précision après réduction ».
La compression du cache KV (la zone mémoire stockant les représentations intermédiaires des jetons précédents lors de leur génération, dont la taille augmente considérablement avec la longueur du contexte) progresse également en parallèle. SemKV (août 2026), qui attribue dynamiquement à chaque jeton l'un des deux niveaux de précision en fonction d'un score d'importance, annonce une réduction de stockage de 6 fois tout en évitant le phénomène de « chute brutale de la qualité » – et de 7,9 fois lorsqu'il est associé à un quantificateur optimisé. Pour l'inférence locale sur de longs contextes, la compression du cache KV devient un enjeu aussi important que la quantification des poids elle-même.
L'ajustement des poids en mémoire est-il suffisant pour l'inférence ?
Le cache KV, l'espace de travail et la surcharge d'exécution consomment également de la mémoire. Inclure la longueur du contexte et la concurrence dans l'estimation.
## Références - [Meilleurs LLM à pondération ouverte 2026 : DeepSeek vs Qwen vs Kimi vs GLM vs Llama](https://wavect.io/blog/open-weight-llm-comparison-2026/) - [Explication de la quantification LLM : GGUF vs AWQ vs GPTQ — Le guide complet 2026](https://fungies.io/llm-quantization-gguf-awq-gptq-guide-2026/) - [IA locale en 2026 : Benchmarks Ollama, inférence à 0 $ et fin de la tarification par jeton](https://dev.to/pooyagolchian/local-ai-in-2026-ollama-benchmarks-0-inference-and-the-end-of-per-token-pricing-32e7) - [Guide de quantification LLM : Comparaison GGUF vs AWQ vs GPTQ vs bitsandbytes (2026)](https://www.premai.io/blog/llm-quantization-guide-gguf-vs-awq-vs-gptq-vs-bitsandbytes-compared-2026/) - [llama.cpp GitHub (ggml-org)](https://github.com/ggml-org/llama.cpp) ) - [Blog officiel d'Ollama](https://ollama.com/blog) - [Article sur l'échelle H (arXiv)](https://arxiv.org/abs/2608.28113) - [Article sur ScaleSweep (arXiv)](https://arxiv.org/abs/2606.07618) - [Article sur SemKV (arXiv)](https://arxiv.org/abs/2608.28911)
Commentaires
Veuillez vous connecter.
Aucune entrée pour le moment.