Contents — find the section you need
Menjalankan model bahasa besar di mesin Anda sendiri, tanpa API cloud yang terlibat — "Local LLM" — telah menjadi praktis dalam beberapa tahun terakhir. Ini adalah hasil dari konvergensi dua arus: model bobot terbuka yang lebih baik, dan penyusutan model melalui teknik kuantisasi.
 Ollama
 Wajah Berpelukan
Gambar: Ollama / Hugging Wajah logo, Wikimedia Commons


Inferensi Lokal Sekilas
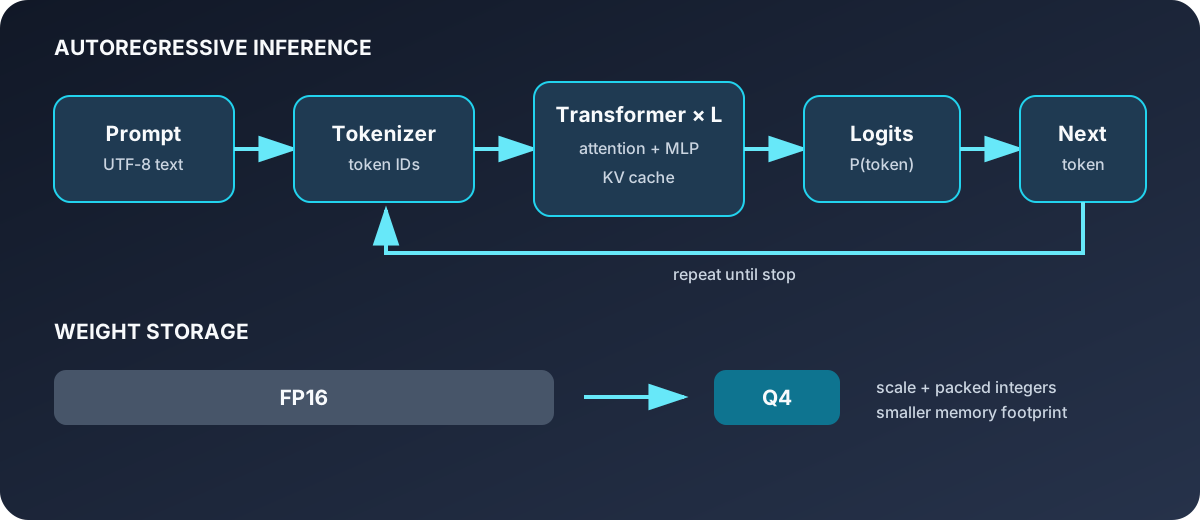
Diagram: Duskcoil. Jalur pembangkitan dan peran kuantisasi bobot ditunjukkan secara terpisah.
Kunci untuk memahami LLM lokal adalah memisahkan loop inferensi berulang dari memori yang dibutuhkan untuk menyimpan model. Teks menjadi ID token; transformer menghitung distribusi untuk token berikutnya; dan token yang dipilih kembali ke input. Sementara itu, kuantisasi terutama mengubah cara bobot disimpan dan dihitung sehingga model sesuai dengan RAM atau VRAM yang terbatas. Oleh karena itu, perbandingan penerapan yang berguna mempertimbangkan tidak hanya nama model, tetapi juga format bobotnya, cache KV yang tumbuh seiring dengan panjang konteks, dan backend CPU/GPU yang tersedia.
Kebangkitan Pesat Model Bobot Terbuka
Lanskap bobot terbuka pada tahun 2026 terus berubah dalam skala waktu bulanan. DeepSeek mendorong efisiensi tinggi di seluruh varian Flash dan Pro-nya; Qwen telah naik dari "pesaing serius" menjadi "tingkat atas dalam penalaran tingkat pascasarjana," berdasarkan seberapa luas pilihan perangkat keras dan ukuran modelnya. Llama 4 dari Meta menghadirkan jendela konteks sepanjang 10 juta token untuk model terbuka. Baru-baru ini, GLM-5.2 dari Z.ai membuat lompatan besar dalam kinerja agen pengkodean dan diintegrasikan ke dalam kerangka kerja agen dalam beberapa hari setelah dirilis, dan Kimi K2.7 Code HighSpeed mengklaim peningkatan kecepatan 6x pada penalaran pengkodean multimodal — laju perubahan sangat cepat.
Hasil benchmark juga menandai pergeseran penting. Pada rangkaian evaluasi pengkodean gaya SWE-bench, kesenjangan antara model open-weight teratas dan model komersial terkemuka telah menyempit menjadi persentase poin satu digit, dan beberapa berpendapat bahwa kesenjangan tersebut secara efektif telah tertutup untuk pekerjaan rekayasa sehari-hari.
Fondasi: Mekanisme Perhatian
Setiap model bahasa besar utama saat ini — termasuk yang dijalankan melalui Ollama — dibangun di atas arsitektur transformer, dan intinya adalah self-attention. Dengan menggunakan matriks query Q, key K, dan value V yang diperoleh dari urutan input, maka perhitungan perhatian dot-product yang diskalakan dilakukan sebagai berikut.
QK^\top merepresentasikan seberapa terkait (seberapa mirip) token satu sama lain, dan pembagian dengan \sqrt{d_k} (akar kuadrat dari dimensi key) mencegah dot product menjadi terlalu besar sehingga gradien softmax menghilang. Pengulangan operasi ini di seluruh parameter dan kedalaman layer model adalah inti dari inferensi transformer — dan seberapa jauh sebagian besar parameter tersebut (matriks bobot) dapat diperkecil adalah peran yang dimainkan oleh kuantisasi, yang akan dibahas selanjutnya.
Bentuk Dasar Kuantisasi Linier
Ide yang mendasari GGUF, AWQ, dan GPTQ adalah kuantisasi linier: mengubah bobot floating-point x menjadi bilangan bulat bit rendah q.
s adalah skala (lebar bilangan riil per langkah) dan z adalah titik nol (di mana, dalam representasi bilangan bulat, nol bilangan riil sebenarnya berada) — kedua parameter kalibrasi ini, dan bagaimana setiap metode menentukan kedua nilai ini, dan pada granularitas apa (seluruh model, per lapisan, per bobot), adalah yang mendorong perbedaan kinerja di antara mereka.
Pematangan Kuantisasi: GGUF, AWQ, GPTQ
Bersamaan dengan peningkatan kinerja model, kuantisasi — pengecilan ukuran model — telah menjadi sama pentingnya. Metode kuantisasi seperti GGUF, AWQ, dan GPTQ telah berhasil mengurangi ukuran model hingga sekitar 70% sambil menjaga kehilangan akurasi di bawah 2%, sehingga model dengan 32 miliar kelas parameter kini dapat muat dalam memori 16 GB. Inferensi lokal pada perangkat keras konsumen umum kini mencapai 70–85% kualitas model kelas atas, tanpa biaya tambahan per permintaan.
Ketiga format tersebut masing-masing memiliki keunggulan tersendiri. GGUF (sebelumnya GGML) adalah format asli untuk llama.cpp dan ekosistemnya (Ollama, LM Studio, dan sejenisnya), yang kuat dalam inferensi hybrid CPU+GPU. GPTQ unggul dalam kecepatan inferensi mentah pada pengaturan GPU saja, dan AWQ umumnya dianggap sebagai pilihan terkuat untuk akurasi per ukuran pada kuantisasi 4-bit. Untuk penggunaan pengembangan lokal secara umum, GGUF melalui Ollama sering direkomendasikan sebagai pilihan default.
Perbedaan Teknis Antara Tiga Metode Kuantisasi
GGUF, AWQ, dan GPTQ adalah metode kuantisasi yang mengecilkan bobot model dari floating point 16-bit/32-bit menjadi sekitar 4 bit, tetapi mereka mencapainya melalui cara teknis yang berbeda.
GPTQ memperlakukan kuantisasi sebagai masalah optimasi. Metode ini secara kasar menggunakan informasi orde kedua dari fungsi kerugian (Hessian) untuk menilai kesalahan pembulatan bobot mana yang paling penting bagi output, kemudian, saat setiap bobot dikuantisasi secara berg順番, mendistribusikan kesalahan yang dihasilkan sebagai kompensasi di seluruh bobot yang belum dikuantisasi dalam baris yang sama. Ini adalah metode yang berfokus pada kinerja inferensi GPU, dan mengkuantisasi model dengan 7B kelas parameter membutuhkan waktu sekitar 2–4 jam pada satu GPU A100.
AWQ, sebaliknya, tidak berfokus pada langkah kuantisasi itu sendiri tetapi pada mencari tahu "bobot mana yang benar-benar penting." Algoritma ini menjalankan fase kalibrasi yang mengamati aktivasi aktual model, mengidentifikasi bobot "penting" yang sangat memengaruhi kualitas output, dan secara agresif mengkuantisasi semua hal lainnya sambil mempertahankan bobot tersebut pada presisi tinggi. Algoritma ini membutuhkan lebih sedikit sampel kalibrasi daripada GPTQ (sekitar 128–512, dibandingkan dengan 2.048+ untuk GPTQ), yang membuatnya jauh lebih cepat — sekitar 10–30 menit untuk model 7B.
GGUF (format asli llama.cpp) menggunakan skema yang disebut "K-quants," menetapkan kedalaman bit yang berbeda per lapisan — 6 bit untuk lapisan yang sangat penting seperti perhatian, 4 bit untuk lapisan umpan maju, dan seterusnya — mencapai kualitas per bit yang lebih tinggi daripada kuantisasi 4-bit seragam yang sederhana. Pengaturan representatif, Q4_K_M, dikatakan mempertahankan sekitar 92% kualitas model asli.
Perbedaan teknis ini secara langsung berkaitan dengan kasus penggunaan mana yang sesuai dengan metode mana. AWQ untuk inferensi berkecepatan tinggi khusus GPU; GPTQ ketika ekosistem GPU yang matang dan pustaka model pra-kuantisasi yang besar menjadi prioritas utama; GGUF (melalui Ollama, dll.) ketika kemudahan penggunaan dalam lingkungan CPU/GPU hibrida menjadi prioritas.
llama.cpp: Cara Kerja Mesin di Balik Inferensi Lokal
Di balik banyak runtime LLM lokal, termasuk Ollama, terdapat llama.cpp — mesin inferensi yang ditulis dalam C/C++ — dan GGML, pustaka tensor di bawahnya. GGML adalah pustaka komputasi tensor ringan dan berketergantungan rendah yang kurang lebih analog dengan PyTorch atau TensorFlow, yang merepresentasikan seluruh komputasi model sebagai "grafik komputasi." Beberapa tensor menyimpan data aktual (seperti bobot), sementara yang lain hanya merepresentasikan hasil operasi antara tensor lain, tidak menyimpan nilai sama sekali sampai komputasi benar-benar dieksekusi. Grafik komputasi ini dapat dijalankan langsung pada CPU, atau diterjemahkan ke dalam instruksi untuk akselerator — CUDA untuk GPU NVIDIA, Metal untuk perangkat keras Apple — dan portabilitas tersebut, menjalankan file model yang sama di berbagai konfigurasi perangkat keras, adalah fondasi teknis yang mendukung popularitas format GGUF.
Angka-angka di Balik Pertumbuhan
Seberapa cepat penyebarannya terlihat dalam angka-angka konkret. Jumlah unduhan bulanan Ollama tumbuh dari 100.000 pada Q1 2023 menjadi 52 juta pada Q1 2026 — peningkatan 520 kali lipat dalam tiga tahun. Jumlah model berformat GGUF di Hugging Face, yang diformat untuk inferensi lokal, tumbuh dari 200 menjadi 135.000 selama periode yang sama. llama.cpp, proyek yang mendukung semua ini, telah melampaui 73.000 bintang di GitHub.
Lanskap Rilis Model di Akhir 2026
Melacak blog resmi Ollama, satu rilis besar telah diikuti oleh rilis besar lainnya hanya dalam paruh kedua tahun 2026. Pada 10 Agustus, Meta Superintelligence Labs merilis model terbuka pertamanya, model multimodal dengan 30 miliar parameter yang disebut "Muse Glimmer," di bawah lisensi Apache 2.0; keesokan harinya, 11 Agustus, NVIDIA mengumumkan "Nemotron 3.5 Lightning," model 30B yang dirancang untuk tugas-tugas agenik multi-langkah. Pada 29 Juni, pembaruan dirilis yang membuat Gemma 4 hingga 90% lebih cepat pada runtime MLX Apple Silicon, melanjutkan dorongan pada kecepatan eksekusi untuk kasus penggunaan agen pengkodean. Ollama sendiri mengumumkan putaran pendanaan $88 juta pada 9 Juli dan melaporkan telah mencapai 8,9 juta pengguna pengembang. Ekosistem model terbuka bergerak melampaui sekadar "merilis model" dan mengambil bentuk infrastruktur komersial yang sesungguhnya.
Terobosan Kuantisasi: NVFP4 sebagai Opsi Baru
Setelah GGUF, AWQ, dan GPTQ, penelitian tentang NVFP4 — format floating-point 4-bit yang dirancang untuk arsitektur Blackwell NVIDIA — telah berkembang pesat hingga tahun 2026 sebagai format kuantisasi baru. Sebuah studi Juni 2026 melaporkan bahwa ukuran blok 16 menawarkan trade-off akurasi/penyimpanan terbaik, dan ScaleSweep (Mei 2026), yang mengoptimalkan nilai skala blok awal melalui pencarian sweep, adalah salah satu dari beberapa metode yang sekarang melaporkan bahwa bahkan kuantisasi agresif dapat mempertahankan lebih dari 93% kinerja presisi penuh. Teknik pasca-pemrosesan juga telah muncul, seperti H-Scale (Agustus 2026), yang menyempurnakan nilai skala per grup menggunakan aproksimasi berbasis Hessian orde kedua tanpa tambahan overhead waktu inferensi — sebuah tanda bahwa penelitian kuantisasi itu sendiri bergeser dari "seberapa banyak bobot dapat dipotong" menuju "bagaimana memulihkan akurasi setelah memotongnya."
Kompresi cache KV (wilayah memori yang menyimpan representasi sementara token masa lalu selama generasi, yang membengkak dengan konteks yang lebih panjang) juga berkembang secara paralel. SemKV (Agustus 2026), yang secara dinamis menetapkan salah satu dari dua tingkat presisi per token berdasarkan skor kepentingan, melaporkan pengurangan penyimpanan 6,0x sambil menghindari fenomena "jurang kualitas" di mana kualitas menurun secara tiba-tiba — dan 7,9x bila dipasangkan dengan kuantisasi yang dioptimalkan. Untuk inferensi lokal pada konteks yang panjang, kompresi cache KV menjadi fokus praktis yang sama pentingnya dengan kuantisasi bobot itu sendiri.
Apakah menyesuaikan bobot dalam memori cukup untuk inferensi?
Cache KV, ruang kerja, dan overhead runtime juga mengkonsumsi memori.
Sertakan panjang konteks dan konkurensi dalam estimasi.Referensi
- LLM Open-Weight Terbaik 2026: DeepSeek vs Qwen vs Kimi vs GLM vs Llama
- Penjelasan Kuantisasi LLM: GGUF vs AWQ vs GPTQ — Panduan Lengkap 2026
- AI Lokal di 2026: Tolok Ukur Ollama, Inferensi $0, dan Akhir dari Penetapan Harga Per-Token
- Panduan Kuantisasi LLM: Perbandingan GGUF vs AWQ vs GPTQ vs bitsandbytes (2026)
- llama.cpp GitHub (ggml-org)
- Blog resmi Ollama
- Makalah Skala H (arXiv)
- Makalah ScaleSweep (arXiv)
- Makalah SemKV (arXiv)
Komentar
Silakan masuk terlebih dahulu.
Belum ada data.