Contents — find the section you need
Segmentasi semantik adalah tugas untuk memberikan label kategori pada setiap piksel dalam sebuah gambar. Jika deteksi objek adalah tugas lokalisasi kasar pada tingkat kotak pembatas (bounding box), segmentasi melakukan pembagian wilayah yang lebih halus pada tingkat piksel. Pada tahun 2026, dua arus berjalan paralel: penyempurnaan melalui metode berbasis transformer, dan pergeseran ke arah model dasar yang dapat memisahkan target arbitrer dari sebuah perintah.
Artikel ini berfokus pada tren penelitian dan secara singkat memperkenalkan konsep-konsep penting terlebih dahulu.
 Meta AI
Gambar: Logo Meta AI, Wikimedia Commons
.svg)
Dua Masalah Segmentasi Sekilas
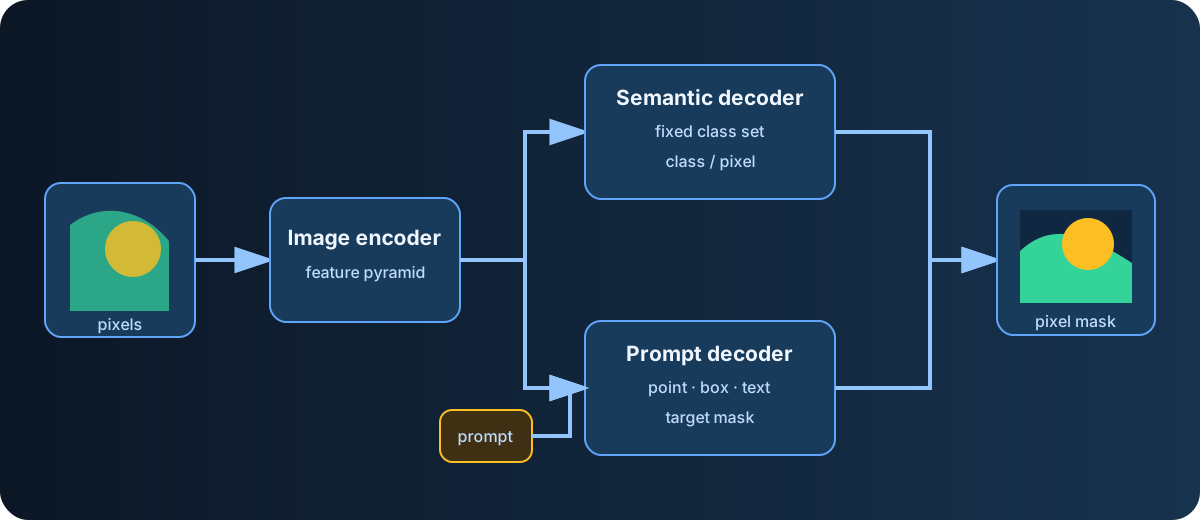
Diagram: Duskcoil. Ini menyederhanakan perbedaan antara pelabelan kelas tetap dan ekstraksi yang dikondisikan oleh prompt.
Masker tingkat piksel yang sama dapat menjawab dua pertanyaan berbeda. Segmentasi semantik menetapkan setiap piksel ke kelas yang tetap selama pelatihan. Segmentasi yang dapat diberi prompt Mengekstraksi target yang ditentukan oleh titik, kotak, atau teks. Perbedaan ini menjaga agar garis keturunan yang bersaing pada mIoU kelas tetap terpisah dari garis keturunan Segment Anything yang memprioritaskan transfer fleksibel ke target baru.
Metrik Evaluasi: mIoU
Akurasi segmentasi secara konvensional dievaluasi dengan mIoU (mean Intersection over Union), yang memperluas IoU deteksi objek ke basis per kelas. Untuk kelas tertentu c, IoU dihitung dari tumpang tindih antara wilayah kebenaran dasar G_c dan wilayah prediksi P_c, kemudian dirata-ratakan di semua kelas C.
Saat melatih ini sebagai masalah klasifikasi per piksel, fungsi kerugian yang umum digunakan adalah entropi silang per piksel, dirata-ratakan dan dijumlahkan di semua piksel.
Di sini y_{n,c} adalah label kebenaran sebenarnya — 1 jika piksel n benar-benar termasuk dalam kelas c, 0 jika tidak — dan \hat{y}_{n,c} adalah probabilitas prediksi model bahwa piksel n termasuk dalam kelas c.
Titik Akhir Metode Berbasis Transformer: SegFormer dan Mask2Former
Yang menjadi arus utama sebagai pengganti metode berbasis CNN (FCN, U-Net, dan sejenisnya) adalah metode yang dibangun di sekitar transformer. SegFormer menggabungkan struktur hierarkis CNN dengan kemampuan pemodelan global transformer, menggunakan encoder transformer hierarkis yang dipasangkan dengan decoder MLP ringan. Ini dianggap sebagai metode yang andal dan akurat di seluruh citra fisheye dan standar.
Mask2Former melangkah lebih jauh, merumuskan segmentasi sebagai klasifikasi mask berbasis kueri. Masalah ini. Ia menggabungkan dekoder piksel yang mempertahankan informasi spasial resolusi tinggi dengan dekoder transformer yang mempelajari sejumlah kueri tetap, di mana setiap kueri memperhatikan wilayah yang relevan untuk memprediksi mask dan kategorinya. Dibangun di atas backbone Swin-L, ia mencapai kinerja terbaik di ketiga jenis segmentasi — panoptik, instans, dan semantik — dan pengenalan perhatian bertopeng membuatnya konvergen 8x lebih cepat daripada Mask R-CNN.
Mengapa "Perhatian Bertopeng" Mask2Former Cepat
Inti teknis di balik Mask2Former yang menggabungkan konvergensi cepat dengan akurasi tinggi adalah perhatian bertopeng: di mana dekoder transformer standar menghitung perhatian silang terhadap seluruh gambar, Mask2Former membatasi perhatian setiap kueri hanya pada wilayah latar depan dari mask yang diprediksi pada lapisan sebelumnya. Alih-alih memeriksa ulang seluruh gambar setiap kali, mempersempit hanya ke "wilayah yang relevan secara lokal" yang tersirat oleh prediksi sebelumnya mengurangi komputasi yang terbuang sambil mengekstrak fitur lokal dengan lebih akurat.
Arsitektur keseluruhan terdiri dari Ekstraktor fitur utama, dekoder piksel yang mempertahankan informasi spasial resolusi tinggi, dan dekoder transformer 9 lapis (menampung 100 kueri yang dapat dipelajari). Untuk menangani objek kecil, ia juga menggunakan strategi multi-skala, memasukkan piramida fitur yang dihasilkan dekoder piksel (tiga tingkat resolusi — 1/8, 1/16, 1/32) ke dalam lapisan dekoder transformer secara berurutan dalam mode round-robin. Desain ini mencapai kinerja yang kuat di ketiga jenis segmentasi — panoptik, instans, dan semantik — dan konvergen 8x lebih cepat daripada Mask R-CNN.
Pergeseran Berbasis Prompt: Garis Keturunan Segment Anything
Arus utama lainnya adalah segmentasi "berbasis prompt", yang tidak dibatasi oleh daftar kategori tetap yang telah ditentukan sebelumnya. Model Segment Anything (SAM), yang dirilis oleh Meta pada tahun 2023, mengambil berbagai prompt sebagai input — sebuah titik, kotak pembatas, masker kasar — dan menghasilkan masker segmentasi berkualitas tinggi darinya. Pergeseran ini — mengukir target arbitrer Berdasarkan sebuah perintah, alih-alih memprediksi dari daftar kelas tetap — memberikan dorongan besar menuju pemodelan dasar visi komputer.
Penerusnya, SAM 2, menggantikan ViT skala tunggal dengan Hiera, sebuah Vision Transformer hierarkis multi-skala yang dilatih sebelumnya melalui autoencoding bertopeng, dan menambahkan dukungan untuk segmentasi video. Ia berjalan pada 130 FPS di 37 dataset zero-shot sambil mempertahankan akurasi tinggi (mIoU 58,9/81,7).
Kemudian pada tahun 2026 muncul SAM 3 dari Meta, yang dapat mendeteksi, mensegmentasi, dan melacak "konsep visual" yang ditentukan oleh perintah teks atau contoh gambar. Ini adalah langkah selanjutnya ke arah yang sama — segmentasi berbasis perintah, tujuan umum — yang didorong satu tingkat lebih jauh, hingga menentukan konsep dalam teks.
SAM 3 Mencapai Penerapan di Dunia Nyata: Hasil dari Kompetisi Segmentasi Video
Sejak awal tahun 2026, penelitian terapan yang dibangun di atas SAM 3 telah muncul dengan cepat di berbagai bidang. Ciri khas SAM 3—menentukan konsep melalui perintah teks—telah berulang kali diterapkan ke domain khusus: pengawasan maritim (MariSat, kumpulan data maritim yang membangun SAM 3 menjadi pipeline anotasi semi-otomatis) dan inspeksi menara komunikasi (memisahkan komponen dari citra udara UAV yang berantakan), di antara lainnya.
Hasil dari jalur MOSEv2 pada Tantangan LSVOS ke-8, yang diadakan di ECCV 2026, menawarkan tolok ukur yang berguna tentang seberapa jauh segmentasi video telah berkembang. SAM3Dual, metode tanpa pelatihan yang dibangun di atas SAM 3 yang menggabungkan dua cabang memori temporal—satu untuk frame terbaru, satu untuk konteks historis—menempati posisi ketiga dengan skor J&F 64,37. Competitive Memory Readout, yang menempati posisi kedua dalam kompetisi yang sama, secara eksplisit memasukkan bukti tentang objek "kompetitor" kelas yang sama saat mengambil informasi target dari memori, mencapai skor metrik utama 66,20. Kedua hasil tersebut menggarisbawahi pentingnya mempertahankan identitas objek. Kemampuan untuk melacak objek yang sama sebagai target yang sama sepanjang urutan video (terus melacak objek yang sama sebagai target yang sama) tetap menjadi tantangan utama dalam menentukan seberapa baik kinerja model keluarga SAM sebenarnya.
Contoh Konkret Pengurangan Bobot dan Adaptasi Few-Shot
Upaya untuk meningkatkan efisiensi keluarga SegFormer/Mask2Former juga terus berlanjut. DPNeXt (Juli 2026), decoder ringan untuk prediksi padat berbasis ViT (segmentasi ditambah pekerjaan multi-tugas seperti estimasi kedalaman), mengurangi parameter yang dapat dilatih sebesar 78,6% dibandingkan dengan DPT (Dense Prediction Transformer) standar sambil mempertahankan kinerja tingkat canggih pada benchmark Cityscapes dan NYUv2. TraceCLIP (Juli 2026), metode yang sepenuhnya bebas pelatihan yang memulihkan informasi semantik lokal dengan mengisolasi kontribusi individual setiap patch terhadap perhatian token CLS CLIP, melaporkan peningkatan mIoU sebesar 1,3 hingga 4,5 poin dibandingkan metode sebelumnya yang terkuat di delapan zero-shot. tolok ukur segmentasi semantik.
Sebagai contoh konkret adaptasi few-shot, ada HASTE (Juli 2026), sebuah platform untuk menilai kerusakan bangunan pascabencana secara cepat dari citra satelit. Dengan memanfaatkan embedding model dasar, ia menyamai akurasi baseline ResNet-50 yang sepenuhnya diawasi (yang dilatih pada label untuk seluruh dataset) sambil hanya menggunakan seperduapuluh jumlah label, dan telah mendukung lebih dari 30 respons bencana dunia nyata — gempa bumi, badai, kebakaran hutan — sejak 2023. Ini adalah perwujudan konkret dari apa yang dituju segmentasi di era model dasar: akurasi tingkat produksi dengan sebagian kecil biaya pelabelan.
Kapan Menggunakan Metode Mana
Rincian praktisnya saat ini adalah: untuk tugas tetap di mana kategori sudah diketahui sebelumnya (mobil, pejalan kaki, rambu-rambu di jalan, misalnya), metode berbasis transformer dalam keluarga SegFormer/Mask2Former memiliki keunggulan baik dalam akurasi maupun efisiensi. efisiensi; untuk situasi yang membutuhkan penanganan target yang tidak dikenal atau kasus dengan sedikit tembakan, model dasar berbasis prompt keluarga SAM menunjukkan kekuatannya — dan pembagian kerja tersebut terus menguat.
Apakah mIoU keseluruhan yang tinggi menjamin segmentasi rintangan kecil yang baik?
Rata-rata dapat menyembunyikan kelemahan spesifik kelas atau ukuran. Periksa kelas, batas, positif palsu, dan wilayah yang terlewatkan yang relevan.
Referensi
- Makalah Evaluasi Komparatif SegFormer/Mask2Former (MDPI)
- Dari SAM ke SAM 2: Menjelajahi Peningkatan dalam Model Segment Anything Meta (arXiv)
- Dokumentasi Resmi SAM 3 (Ultralytics)
- Benchmark Baru untuk Segmentasi Semantik Few-Shot di Era Model Dasar (arXiv)
- Makalah SAM3Dual (MOSEv2, Tantangan LSVOS) (arXiv)
- Pembacaan Memori Kompetitif untuk Segmentasi Objek Video yang Kuat (arXiv)
- Makalah DPNeXt (arXiv)
- Makalah TraceCLIP (arXiv)
- Makalah HASTE (arXiv)
Komentar
Silakan masuk terlebih dahulu.
Belum ada data.