Contents — find the section you need
La segmentación semántica consiste en asignar una etiqueta de categoría a cada píxel de una imagen. Mientras que la detección de objetos es una tarea de localización aproximada a nivel de cuadro delimitador, la segmentación realiza una división de regiones más precisa a nivel de píxel. En 2026, coexistían dos tendencias: el refinamiento mediante métodos basados en transformadores y la evolución hacia modelos fundamentales capaces de definir un objetivo arbitrario a partir de una indicación.
Este artículo se centra en las tendencias de investigación y presenta brevemente los conceptos esenciales.
 Meta AI
Imagen: Logotipo de Meta AI, Wikimedia Commons
.svg)
Dos problemas de segmentación en resumen
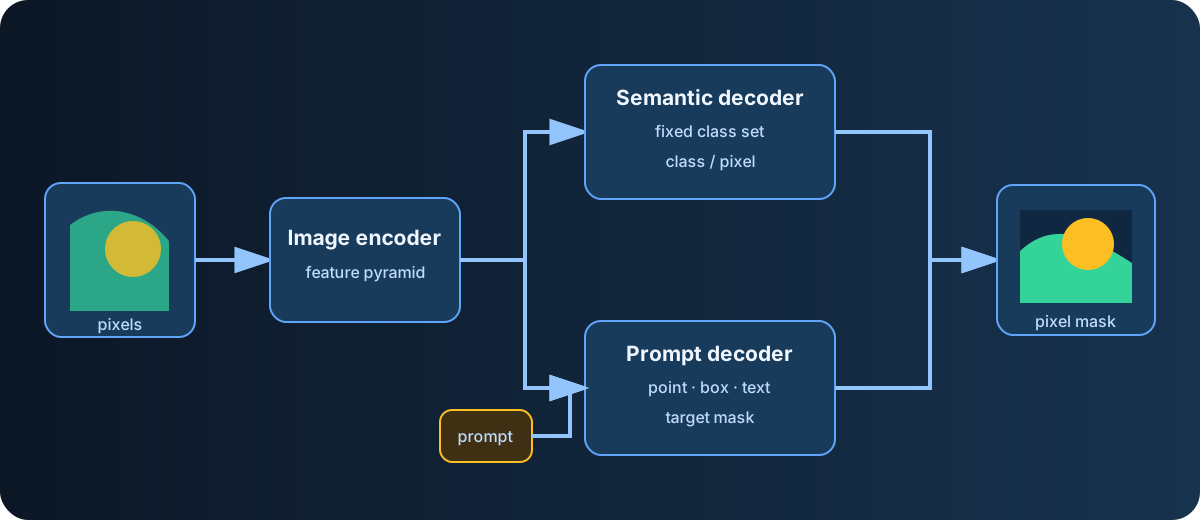
Diagrama: Duskcoil. Simplifica la distinción entre el etiquetado de clase fija y la extracción condicionada por texto de entrada.
La misma máscara a nivel de píxel puede responder a dos preguntas diferentes. La segmentación semántica asigna cada píxel a una clase fija durante el entrenamiento. Segmentación con indicaciones. La segmentación extrae el objetivo especificado por un punto, un recuadro o un texto. Esta distinción mantiene separada la línea de algoritmos que compite en mIoU de clase fija de la línea de algoritmos Segment Anything, que prioriza la transferencia flexible a nuevos objetivos.
Métrica de evaluación: mIoU
La precisión de la segmentación se evalúa convencionalmente con mIoU (Intersección media sobre Unión), que extiende el IoU de la detección de objetos a una base por clase. Para una clase dada c, el IoU se calcula a partir de la superposición entre la región real G_c y la región predicha P_c, y luego se promedia en todas las clases C.
Al entrenar esto como un problema de clasificación por píxel, la función de pérdida comúnmente utilizada es la entropía cruzada por píxel, promediada y sumada en todos los píxeles.
Aquí y_{n,c} es la etiqueta de referencia (1 si el píxel n pertenece a la clase c, 0 en caso contrario) y \hat{y}_{n,c} es la probabilidad predicha por el modelo de que el píxel n pertenezca a la clase c.
El punto final de los métodos basados en transformadores: SegFormer y Mask2Former
Los métodos basados en transformadores se han popularizado en lugar de los basados en CNN (FCN, U-Net, etc.). SegFormer combina la estructura jerárquica de una CNN con la capacidad de modelado global de un transformador, utilizando un codificador de transformador jerárquico junto con un decodificador MLP ligero. Se considera un método fiable y de alta precisión tanto para imágenes ojo de pez como para imágenes estándar.
Mask2Former va un paso más allá, formulando la segmentación como una clasificación de máscaras basada en consultas. Problema. Combina un decodificador de píxeles que preserva la información espacial de alta resolución con un decodificador transformador que aprende un número fijo de consultas, donde cada consulta se centra en una región relevante para predecir una máscara y su categoría. Basado en una arquitectura Swin-L, logra un rendimiento de vanguardia en los tres tipos de segmentación (panóptica, de instancia y semántica), y la introducción de la atención enmascarada permite una convergencia 8 veces más rápida que Mask R-CNN.
Por qué la "Atención Enmascarada" de Mask2Former es rápida
El núcleo técnico que permite a Mask2Former combinar una convergencia rápida con una alta precisión es la atención enmascarada: mientras que un decodificador transformador estándar calcula la atención cruzada sobre toda la imagen, Mask2Former restringe la atención de cada consulta únicamente a la región de primer plano de la máscara predicha en la capa anterior. En lugar de reexaminar toda la imagen cada vez, limitarse a la "región localmente relevante" implícita en la predicción inmediatamente anterior reduce el desperdicio computacional al tiempo que extrae información local. Características con mayor precisión.
La arquitectura general consta de un extractor de características principal, un decodificador de píxeles que conserva información espacial de alta resolución y un decodificador transformador de 9 capas (con capacidad para 100 consultas de aprendizaje). Para manejar objetos pequeños, también utiliza una estrategia multiescala, alimentando la pirámide de características que produce el decodificador de píxeles (tres niveles de resolución: 1/8, 1/16 y 1/32) a capas sucesivas de decodificadores transformadores de forma rotativa. Este diseño logra un rendimiento sólido en los tres tipos de segmentación (panóptica, de instancia y semántica) y converge 8 veces más rápido que Mask R-CNN.
El cambio basado en indicaciones: El linaje de Segment Anything
Otra tendencia importante es la segmentación basada en indicaciones, sin restricciones de ninguna lista de categorías fija predeterminada. El modelo Segment Anything (SAM), lanzado por Meta en 2023, toma como entrada diversas indicaciones (un punto, un cuadro delimitador, una máscara aproximada) y Genera una máscara de segmentación de alta calidad a partir de ellas. Este cambio —definir un objetivo arbitrario basado en una indicación, en lugar de predecir a partir de una lista de clases fija— impulsó significativamente el modelado fundamental de la visión artificial.
Su sucesor, SAM 2, reemplazó el ViT de escala única con Hiera, un Vision Transformer jerárquico multiescala preentrenado mediante autoencoder enmascarado, y añadió soporte para la segmentación de vídeo. Funciona a 130 FPS en 37 conjuntos de datos de entrenamiento sin entrenamiento previo, manteniendo una alta precisión (mIoU 58,9/81,7).
En 2026, Meta lanzó SAM 3, capaz de detectar, segmentar y rastrear un "concepto visual" especificado mediante una indicación de texto o una imagen de ejemplo. Representa el siguiente paso en la misma dirección —segmentación de propósito general basada en indicaciones—, llevando la especificación del concepto en texto un nivel más allá.
SAM 3: Implementación en el mundo real: Resultados de competiciones de segmentación de vídeo
Desde el inicio de En 2026, la investigación aplicada basada en SAM 3 ha proliferado rápidamente en diversos campos. La característica distintiva de SAM 3 —la especificación de un concepto mediante una solicitud de texto— se ha aplicado repetidamente en ámbitos especializados: vigilancia marítima (MariSat, un conjunto de datos marítimos que integra SAM 3 en un proceso de anotación semiautomático) e inspección de torres de comunicación (extracción de componentes de imágenes aéreas de UAV con gran cantidad de información), entre otros.
Los resultados de la pista MOSEv2 del 8.º Desafío LSVOS, celebrado en ECCV 2026, ofrecen una útil referencia del progreso de la segmentación de vídeo. SAM3Dual, un método sin entrenamiento basado en SAM 3 que combina dos ramas de memoria temporal —una para fotogramas recientes y otra para el contexto histórico—, obtuvo el tercer puesto con una puntuación J&F de 64,37. Competitive Memory Readout, que quedó en segundo lugar en la misma competición, incorpora explícitamente información sobre objetos "competidores" de la misma clase al recuperar información del objetivo de la memoria, logrando así una segmentación primaria. Puntuación métrica de 66,20. Ambos resultados subrayan que preservar la identidad de los objetos a lo largo del tiempo en vídeo (seguir el mismo objeto como el mismo objetivo durante toda una secuencia) sigue siendo el principal desafío para determinar el rendimiento real de los modelos de la familia SAM.
Ejemplos concretos de optimización y adaptación con pocos ejemplos
Los esfuerzos por mejorar aún más la eficiencia de la familia SegFormer/Mask2Former continúan. DPNeXt (julio de 2026), un decodificador ligero para predicción densa basada en ViT (segmentación más tareas múltiples como la estimación de profundidad), reduce los parámetros entrenables en un 78,6 % en comparación con un DPT (Dense Prediction Transformer) estándar, manteniendo un rendimiento de vanguardia en los conjuntos de datos Cityscapes y NYUv2. TraceCLIP (julio de 2026), un método totalmente independiente del entrenamiento que recupera información semántica local aislando la contribución individual de cada parche a la atención de tokens CLS de CLIP, informa de Mejoras de mIoU de 1,3 a 4,5 puntos con respecto a los métodos previos más robustos en ocho conjuntos de datos de referencia de segmentación semántica sin ejemplos previos.
Como ejemplo concreto de adaptación con pocos ejemplos, tenemos HASTE (julio de 2026), una plataforma para evaluar rápidamente los daños en edificios tras un desastre a partir de imágenes satelitales. Al aprovechar las incrustaciones del modelo base, iguala la precisión de una red de referencia ResNet-50 totalmente supervisada (entrenada con etiquetas para todo el conjunto de datos) utilizando solo una vigésima parte de las etiquetas, y ha sido compatible con más de 30 respuestas a desastres reales (terremotos, huracanes, incendios forestales) desde 2023. Es una materialización concreta de lo que la segmentación busca en la era del modelo base: precisión de nivel de producción a una fracción del coste de etiquetado.
Cuándo usar cada método actual
El desglose práctico en este punto es: para una tarea fija donde las categorías ya se conocen de antemano (por ejemplo, coches, peatones, señales en una escena vial), los métodos basados en transformadores en el La familia SegFormer/Mask2Former destaca por su precisión y eficiencia; en situaciones que requieren el manejo de objetivos desconocidos o casos con pocos ejemplos, los modelos de base basados en indicaciones de la familia SAM demuestran su fortaleza, y esta división del trabajo se consolida cada vez más.
¿Un mIoU general alto garantiza una buena segmentación de obstáculos pequeños?
Los promedios pueden ocultar debilidades específicas de clase o tamaño. Inspecciona las clases relevantes, los límites, los falsos positivos y las regiones omitidas.
Referencias
- SegFormer/Mask2Former Comparative Evaluation Paper (MDPI)
- From SAM to SAM 2: Exploring Improvements in Meta's Segment Anything Model (arXiv)
- SAM 3 Official Documentation (Ultralytics)
- Un nuevo benchmark para la segmentación semántica con pocos ejemplos en la era de los modelos base (arXiv)
- Artículo sobre SAM3Dual (MOSEv2, LSVOS Challenge) (arXiv)
- Artículo sobre lectura de memoria competitiva para la segmentación robusta de objetos de vídeo (arXiv)
- Artículo sobre DPNeXt (arXiv)
- Artículo sobre TraceCLIP (arXiv)
- Artículo sobre HASTE (arXiv)
Comentarios
Inicia sesión para continuar.
Todavía no hay datos.