Contents — find the section you need
La segmentazione semantica è il compito di assegnare un'etichetta di categoria a ogni singolo pixel di un'immagine. Mentre il rilevamento di oggetti è un'attività di localizzazione approssimativa, a livello di bounding box, la segmentazione esegue una divisione di regioni più precisa, a livello di pixel. Nel 2026, due filoni di ricerca procedevano in parallelo: il perfezionamento tramite metodi basati su transformer e un passaggio a modelli di base in grado di individuare un target arbitrario a partire da un input.
Questo articolo si concentra sulle tendenze di ricerca e introduce brevemente i concetti essenziali.
 Meta AI
Immagine: Logo di Meta AI, Wikimedia Commons
.svg)
Due problemi di segmentazione in sintesi
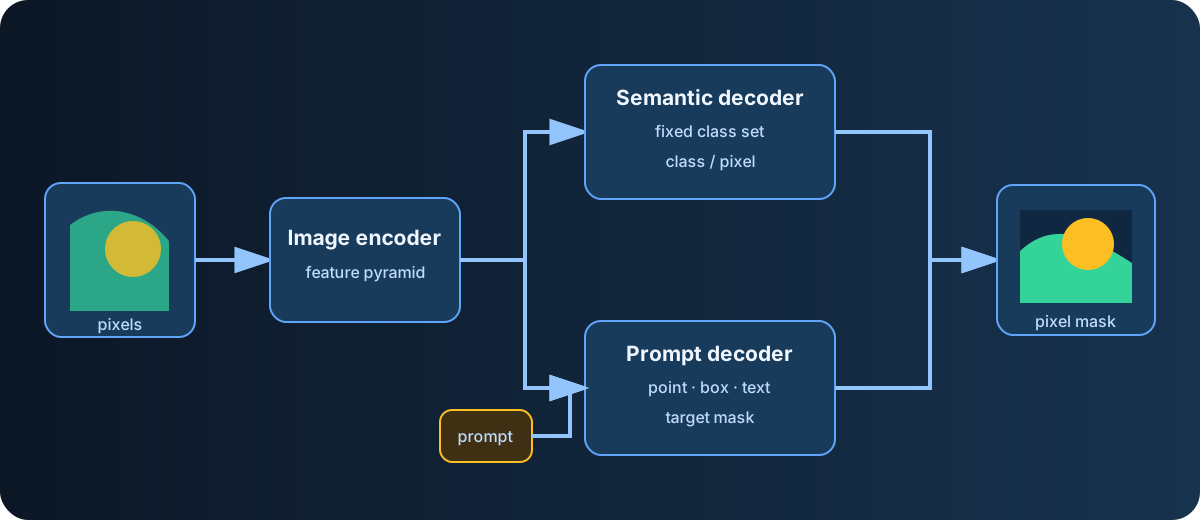
Diagramma: Duskcoil. Semplifica la distinzione tra etichettatura a classe fissa ed estrazione condizionata dal prompt.
La stessa maschera a livello di pixel può rispondere a due domande diverse. La segmentazione semantica assegna ogni pixel a una La classe è fissa durante l'addestramento. La segmentazione su richiesta estrae l'oggetto specificato da un punto, un riquadro o un testo. Questa distinzione mantiene separata la linea evolutiva che compete sulla mIoU a classe fissa dalla linea evolutiva Segment Anything che privilegia il trasferimento flessibile a nuovi oggetti.
Metrica di valutazione: mIoU
L'accuratezza della segmentazione viene convenzionalmente valutata con la mIoU (mean Intersection over Union), che estende l'IoU del rilevamento degli oggetti a una base per classe. Per una data classe c, l'IoU viene calcolata dalla sovrapposizione tra la regione di riferimento G_c e la regione prevista P_c, quindi mediata su tutte le C classi.
Quando si addestra questo come un problema di classificazione per pixel, la funzione di perdita comunemente utilizzata è l'entropia incrociata per pixel, mediata e sommata su tutte le C classi. pixel.
Qui y_{n,c} è l'etichetta di verità — 1 se il pixel n appartiene effettivamente alla classe c, 0 altrimenti — e \hat{y}_{n,c} è la probabilità prevista dal modello che il pixel n appartenga alla classe c.
Il punto di forza dei metodi basati su Transformer: SegFormer e Mask2Former
Ciò che è diventato mainstream al posto dei metodi basati su CNN (FCN, U-Net e simili) sono i metodi basati su un Transformer. SegFormer combina la struttura gerarchica di una CNN con la capacità di modellazione globale di un Transformer, utilizzando un encoder Transformer gerarchico abbinato a un decoder MLP leggero. È considerato un metodo affidabile e ad alta precisione in entrambi i casi. Immagini fisheye e standard.
Mask2Former fa un ulteriore passo avanti, formulando la segmentazione come un problema di classificazione di maschere basato su query. Abbina un decodificatore di pixel che preserva le informazioni spaziali ad alta risoluzione con un decodificatore transformer che apprende un numero fisso di query, dove ogni query si concentra su una regione rilevante per predire una maschera e la sua categoria. Basato su un'architettura Swin-L, raggiunge prestazioni all'avanguardia in tutti e tre i tipi di segmentazione: panottica, di istanza e semantica. L'introduzione dell'attenzione mascherata gli consente di convergere 8 volte più velocemente di Mask R-CNN.
Perché l'attenzione mascherata di Mask2Former è veloce
Il nucleo tecnico alla base della rapida convergenza di Mask2Former, che unisce un'elevata precisione all'alta velocità di convergenza, è l'attenzione mascherata: mentre un decodificatore transformer standard calcola l'attenzione incrociata sull'intera immagine, Mask2Former limita l'attenzione di ogni query solo alla regione in primo piano della maschera predetta al livello precedente. Invece di riesaminare l'intera immagine ogni volta, restringendo l'attenzione solo alla regione rilevante della maschera predetta al livello precedente, Mask2Former non è in grado di gestire l'intera immagine. La "regione localmente rilevante" implicita nella predizione immediatamente precedente riduce i calcoli superflui estraendo al contempo le caratteristiche locali con maggiore precisione.
L'architettura complessiva è composta da un estrattore di caratteristiche principale, un decodificatore di pixel che preserva le informazioni spaziali ad alta risoluzione e un decodificatore transformer a 9 strati (contenente 100 query apprendibili). Per gestire oggetti di piccole dimensioni, utilizza anche una strategia multiscala, alimentando la piramide di caratteristiche prodotta dal decodificatore di pixel (tre livelli di risoluzione: 1/8, 1/16, 1/32) in successivi strati transformer-decoder in modo ciclico. Questa progettazione raggiunge prestazioni elevate in tutti e tre i tipi di segmentazione: panottica, di istanza e semantica, e converge 8 volte più velocemente di Mask R-CNN.
Il passaggio alla segmentazione basata su prompt: la linea evolutiva di Segment Anything
Un'altra importante tendenza è la segmentazione "basata su prompt", non vincolata da alcun elenco di categorie fisse predeterminate. Il Segment Anything Model (SAM), rilasciato da Meta nel 2023, accetta una varietà di prompt Il sistema prende in input un punto, un riquadro di delimitazione o una maschera approssimativa e genera da essi una maschera di segmentazione di alta qualità. Questo cambiamento – la creazione di un target arbitrario basato su un prompt, anziché sulla previsione da un elenco di classi predefinito – ha dato un forte impulso alla modellazione di base della visione artificiale.
Il suo successore, SAM 2, ha sostituito il Vision Transformer (ViT) a scala singola con Hiera, un Vision Transformer gerarchico multiscala pre-addestrato tramite autoencoder con maschera, e ha aggiunto il supporto per la segmentazione video. Funziona a 130 FPS su 37 dataset zero-shot mantenendo un'elevata precisione (mIoU 58,9/81,7).
Nel 2026 è arrivato SAM 3 di Meta, in grado di rilevare, segmentare e tracciare un "concetto visivo" specificato da un prompt testuale o da un'immagine di esempio. Rappresenta il passo successivo nella stessa direzione – segmentazione generica basata su prompt – spinta un livello oltre, fino alla specifica di un concetto tramite testo.
SAM 3: i suoi limiti Applicazione nel mondo reale: risultati delle competizioni di segmentazione video
Dall'inizio del 2026, la ricerca applicata basata su SAM 3 è emersa rapidamente in una vasta gamma di settori. La caratteristica distintiva di SAM 3, ovvero la specificazione di un concetto tramite un prompt di testo, è stata ripetutamente applicata a domini specializzati: sorveglianza marittima (MariSat, un dataset marittimo che integra SAM 3 in una pipeline di annotazione semiautomatica) e ispezione di torri di comunicazione (estrazione di componenti da immagini aeree disordinate acquisite da droni), tra gli altri.
I risultati della traccia MOSEv2 dell'8a LSVOS Challenge, tenutasi all'ECCV 2026, offrono un utile indicatore dei progressi compiuti dalla segmentazione video. SAM3Dual, un metodo senza addestramento basato su SAM 3 che combina due rami di memoria temporale, uno per i fotogrammi recenti e uno per il contesto storico, si è classificato terzo con un punteggio J&F di 64,37. Competitive Memory Readout, che si è classificato secondo nella stessa competizione, integra esplicitamente in evidenza riguardo a oggetti "competitori" della stessa classe durante il recupero delle informazioni target dalla memoria, ottenendo un punteggio metrico primario di 66,20. Entrambi i risultati sottolineano che preservare l'identità dell'oggetto nel tempo nei video (continuare a tracciare lo stesso oggetto come target per tutta la sequenza) rimane la sfida principale che determina le prestazioni effettive dei modelli della famiglia SAM.
Esempi concreti di alleggerimento e adattamento a pochi scatti
Continuano anche gli sforzi per spingere ulteriormente l'efficienza della famiglia SegFormer/Mask2Former. DPNeXt (luglio 2026), un decoder leggero per la predizione densa basata su ViT (segmentazione più lavoro multi-task come la stima della profondità), riduce i parametri addestrabili del 78,6% rispetto a un DPT (Dense Prediction Transformer) standard, mantenendo prestazioni all'avanguardia sia sui benchmark Cityscapes che NYUv2. TraceCLIP (luglio 2026), un metodo completamente senza addestramento che recupera informazioni locali Le informazioni semantiche, ottenute isolando il contributo individuale di ciascuna patch all'attenzione del token CLS di CLIP, riportano miglioramenti mIoU da 1,3 a 4,5 punti rispetto ai metodi precedenti più efficaci su otto benchmark di segmentazione semantica zero-shot.
Per un esempio concreto di adattamento few-shot, c'è HASTE (luglio 2026), una piattaforma per la valutazione rapida dei danni agli edifici post-disastro da immagini satellitari. Sfruttando gli embedding del modello di base, raggiunge l'accuratezza di un modello di riferimento ResNet-50 completamente supervisionato (addestrato su etichette per l'intero dataset) utilizzando solo un ventesimo delle etichette, e ha supportato oltre 30 interventi di risposta a disastri reali (terremoti, uragani, incendi boschivi) dal 2023. È una concreta incarnazione di ciò a cui la segmentazione mira nell'era del modello di base: accuratezza di livello produttivo a una frazione del costo dell'etichettatura.
Quando usare quale corrente
La suddivisione pratica a questo punto è: per un compito fisso in cui il Quando le categorie sono già note in anticipo (ad esempio, auto, pedoni, segnali stradali), i metodi basati su transformer della famiglia SegFormer/Mask2Former offrono un vantaggio sia in termini di accuratezza che di efficienza; per le situazioni che richiedono la gestione di target sconosciuti o casi con pochi esempi, i modelli di base basati su prompt della famiglia SAM dimostrano la loro forza, e questa divisione del lavoro continua a consolidarsi.
Un mIoU complessivo elevato garantisce una buona segmentazione di piccoli ostacoli?
Le medie possono nascondere debolezze specifiche per classe o dimensione. Esamina le classi rilevanti, i confini, i falsi positivi e le regioni non rilevate.
Riferimenti
- Documento di valutazione comparativa SegFormer/Mask2Former (MDPI)
- [Da SAM a SAM 2: Esplorazione dei miglioramenti in Modello Segment Anything di Meta (arXiv)
- Documentazione ufficiale di SAM 3 (Ultralytics)
- Un nuovo benchmark per la segmentazione semantica a pochi esempi nell'era dei modelli di base (arXiv)
- Articolo su SAM3Dual (MOSEv2, LSVOS Challenge) (arXiv)
- Articolo sulla lettura competitiva della memoria per una segmentazione robusta degli oggetti video (arXiv)
- Articolo su DPNeXt (arXiv)
- Articolo su TraceCLIP (arXiv) )
- Articolo HASTE (arXiv)
Commenti
Accedi per continuare.
Nessun dato disponibile.