Contents — find the section you need
Il rilevamento di oggetti è il compito di stimare simultaneamente la posizione di un oggetto (bounding box) e la sua categoria a partire da un'immagine. La famiglia YOLO è stata a lungo la scelta preferita per l'uso in produzione, ma entro il 2026 i rilevatori basati su transformer avranno raggiunto un livello tale da minacciare seriamente questa posizione.
Questo articolo si concentra sulle tendenze della ricerca e introduce brevemente i concetti essenziali.
 Rilevamento di oggetti
Non è stato possibile trovare un logo ufficiale di YOLO/Ultralytics libero da diritti d'autore, quindi è stata creata una semplice icona che rappresenta il rilevamento di bounding box.
La distinzione tra i diversi design dei rilevatori in sintesi
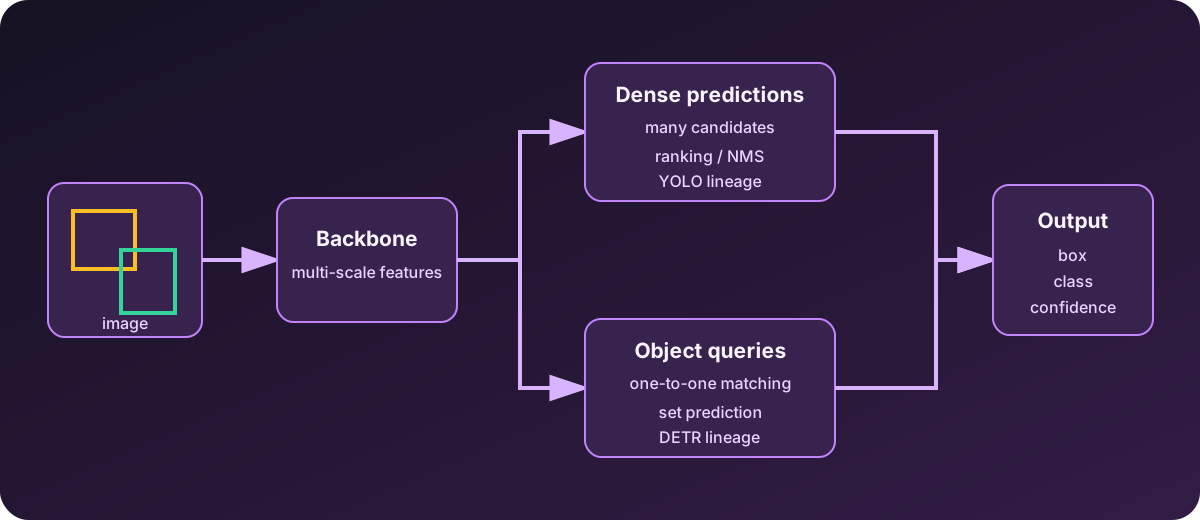
Diagramma: Duskcoil. Evidenzia la principale distinzione tra la predizione densa e la predizione a insiemi.
Ogni rilevatore di oggetti trasforma un'immagine di input in caratteristiche e restituisce infine posizione, categoria e confidenza. La principale differenza La questione è se crea molti candidati e rimuove i duplicati in seguito, oppure se abbina le query di oggetti appresi uno a uno con la verità di base e predice direttamente un set con poche duplicazioni. Questa scelta si propaga nella necessità di NMS, nell'obiettivo di addestramento, nella velocità e nel comportamento in scene affollate.
Dove si trova la famiglia YOLO: Senza NMS
L'NMS tradizionale è una fase di post-elaborazione che riduce diverse caselle candidate prodotte per lo stesso oggetto a un rilevamento finale, scartando qualsiasi casella la cui sovrapposizione (IoU: Intersection over Union, l'area di sovrapposizione tra due caselle divisa per la loro area di unione) con un'altra superi una soglia.
Questa post-elaborazione viene eseguita come una fase indipendente al di fuori della rete e comporta degli svantaggi: la messa a punto empirica di dove impostare la soglia e la tendenza a scartare erroneamente oggetti realmente distinti e vicini. YOLO26, l'ultima generazione di YOLO, adotta un'architettura senza NMS che non necessita più di soppressione non massima, Fase di post-elaborazione standard da anni. NMS tende a rappresentare un collo di bottiglia sia per i costi computazionali che per la latenza nella pipeline di inferenza, e la sua rimozione mira a migliorare sia la velocità di inferenza che la semplicità di implementazione. Sul fronte del throughput puro, anche la parte più leggera e veloce dello spettro rimane ben fornita: RTMDet, ad esempio, supera i 300 FPS.
L'ascesa dei rilevatori basati su Transformer: RF-DETR e RT-DETRv2
Un'altra importante tendenza è rappresentata dalla famiglia DETR (DEtection TRansformer) che sta raggiungendo la maturità pratica. RT-DETR/RT-DETRv2 combinano una CNN con un transformer e, come la famiglia YOLO, sono progettati per produrre direttamente i rilevamenti finali senza NMS.
Il grande evento del 2026 è stato l'arrivo di RF-DETR, presentato all'ICLR 2026. È descritto come il primo modello in tempo reale a superare i 60 mAP sul benchmark COCO ed è anche leader Il benchmark RF100-VL valuta il trasferimento di dominio. La sua licenza è Apache 2.0, permissiva per l'uso commerciale, a differenza di YOLO26/YOLOv12, che ha licenza AGPL.
Rilevamento di vocabolario aperto tramite prompt di testo
Un altro importante trend è il "rilevamento di vocabolario aperto", ovvero il rilevamento di categorie su cui il modello non è mai stato addestrato. YOLO-World e Grounding DINO possono rilevare una categoria arbitraria a partire da un semplice prompt di testo, senza bisogno di dati di addestramento aggiuntivi. Si tratta di un cambio di mentalità rispetto al rilevamento vincolato a un elenco di classi fisso, e si adatta bene a casi d'uso in cui le categorie del mondo reale non possono essere completamente enumerate in anticipo, come ad esempio il riconoscimento di oggetti per un robot generico.
Il meccanismo tecnico alla base dell'eliminazione del NMS
Il passaggio di YOLO26 al rilevamento senza NMS non è solo una questione di saltare una fase di post-elaborazione, ma deriva da un cambiamento del metodo di addestramento stesso. Il design tradizionale di YOLO tollerava più box predetti per oggetto durante l'addestramento (assegnazione uno-a-molti), con il presupposto che NMS avrebbe ridotto i duplicati dopo l'inferenza. YOLO26 riprogetta la testa di predizione, passando all'assegnazione uno-a-uno, dove un singolo box definitivo per istanza di oggetto viene prodotto a partire dall'addestramento stesso. Sostituisce inoltre l'approccio basato sulla distribuzione utilizzato per la regressione del bounding box (Distribution Focal Loss) con una parametrizzazione più leggera e più adatta all'hardware, eliminando le operazioni che tendono ad essere instabili tra compilatori e runtime. Il risultato è un'inferenza fino al 43% più veloce sulla CPU, insieme a un'implementazione di post-elaborazione complessivamente più semplice.
RF-DETR è anch'esso privo di NMS, ma tramite un meccanismo diverso da YOLO26. RF-DETR utilizza un Vision Transformer pre-addestrato, DINOv2, come base, estrae caratteristiche multi-risoluzione e le passa attraverso un decoder che lavora con query apprendibili (rappresentazioni astratte che sostituiscono gli oggetti candidati). Ogni strato del decoder è costituito da autoattenzione (cattura le relazioni tra le query), deformabile L'attenzione incrociata (che si concentra solo su un piccolo insieme di punti di campionamento appresi all'interno delle caratteristiche dell'immagine) e una rete feed-forward che affina la previsione. Questa attenzione deformabile, che "considera solo un piccolo numero di punti appresi", mantiene i costi computazionali inferiori rispetto all'attenzione incrociata standard del trasformatore, producendo al contempo previsioni uniche basate su insiemi, che è esattamente il motivo per cui l'NMS diventa superfluo.
Cosa mostrano realmente i confronti tra generazioni: YOLOv8/v11/v26
Sono inoltre emersi dati che mettono in discussione l'ipotesi che "generazione più recente = accuratezza uniformemente superiore". Un benchmark dell'agosto 2026, che ha coinvolto tre generazioni di YOLO e cinque scale di modello, mirato a strutture a grana fine (rami, frutti, altri piccoli oggetti) nel rilevamento di frutteti e nella segmentazione di istanze, ha rilevato che il mAP@50:95 più alto non è stato stabilito da YOLOv26, bensì da YOLOv11s-960 (mAP@50:95 di 0,402 per la maschera, box di 0,426 per la scatola). mAP@50:95). YOLOv26s-960, nel frattempo, ha raggiunto un'accuratezza pressoché comparabile con soli 10,37 milioni di parametri. Il quadro che emerge è quindi il seguente: i miglioramenti in termini di accuratezza non si presentano in modo uniforme con ogni nuova generazione, ma l'efficienza dei parametri – ovvero la capacità di eguagliare l'accuratezza con una potenza di calcolo nettamente inferiore – sta progredendo costantemente.
Anche il rilevamento di piccoli oggetti rimane una sfida reale e irrisolta. Una valutazione dell'agosto 2026 che confrontava sei varianti di YOLO e due varianti di DETR nel rilevamento di veicoli militari ha riscontrato un modello coerente: i modelli più grandi offrono prestazioni migliori, gli approcci basati su DETR si dimostrano promettenti e la messa a punto migliora le prestazioni aria-terra (A2G), ma ogni singolo modello fatica ancora a rilevare piccoli oggetti nello scenario A2G. Né il design senza NMS di YOLO26 né l'elevato mAP di RF-DETR hanno risolto completamente questo problema degli "oggetti piccoli e distanti".
Progressi del rilevamento a vocabolario aperto: valori AP concreti
La generazione di vocabolario aperto I rilevatori che seguono YOLO-World/Grounding DINO hanno anche ottenuto costanti miglioramenti di precisione fino al 2026. FlowOVD (maggio 2026), che utilizza un flusso rettificato generativo per trasformare query indipendenti dal testo in query guidate dal testo, riporta 49,5 AP su COCO e 31,5 AP su LVIS, con miglioramenti rispettivamente di +1,2 AP (un +2,5% relativo) e +4,1 AP (un +15,0% relativo) rispetto a Grounding DINO. OPUS, pubblicato nell'agosto 2026, gestisce più tipi di prompt (testo, visivo (interattivo/generico) e misto) all'interno di un unico framework unificato e, nonostante un design più semplice che evita la fusione cross-modale complessa, registra valori all'avanguardia di 68,1/69,2/54,7 AP sui benchmark COCO, LVIS-minival e ODinW35. Il rilevamento del vocabolario aperto non è più solo una vittoria qualitativa: la capacità di gestire sconosciuti categorie: sta diventando quantitativamente competitivo anche con i rilevatori a classe fissa.
Il panorama al 2026
Oggi il rilevamento di oggetti è in gran parte inquadrato lungo due assi: architetture a trasformatore a stadio singolo, senza NMS, e la famiglia YOLO con il suo consolidato ecosistema. Il lato dei trasformatori si sta sviluppando rapidamente, ma la famiglia YOLO rimane la spina dorsale degli ambienti di produzione in tempo reale, grazie alla sua comprovata esperienza e alla vastità dei suoi strumenti. Suddivisa per caso d'uso:
- Precisione prima di tutto: RF-DETR
- Comprovata esperienza ed ecosistema sono fondamentali: YOLO26/YOLOv12
- Velocità assoluta: RTMDet
- Necessità di gestire categorie sconosciute: YOLO-World / Grounding DINO
Questa è l'attuale divisione del lavoro.
Commenti
Accedi per continuare.
Nessun dato disponibile.