Contents — find the section you need
La détection d'objets consiste à estimer simultanément la position (boîte englobante) et la catégorie d'un objet dans une image. La famille YOLO a longtemps été la référence en production, mais d'ici 2026, les détecteurs basés sur les transformeurs représenteront une réelle menace.
Cet article se concentre sur les tendances de la recherche et présente brièvement les concepts essentiels.
 Détection d'objets
Aucun logo officiel libre de droits pour YOLO/Ultralytics n'ayant été trouvé, une simple icône représentant la détection de boîtes englobantes a été créée à la place.
Aperçu de la conception des détecteurs
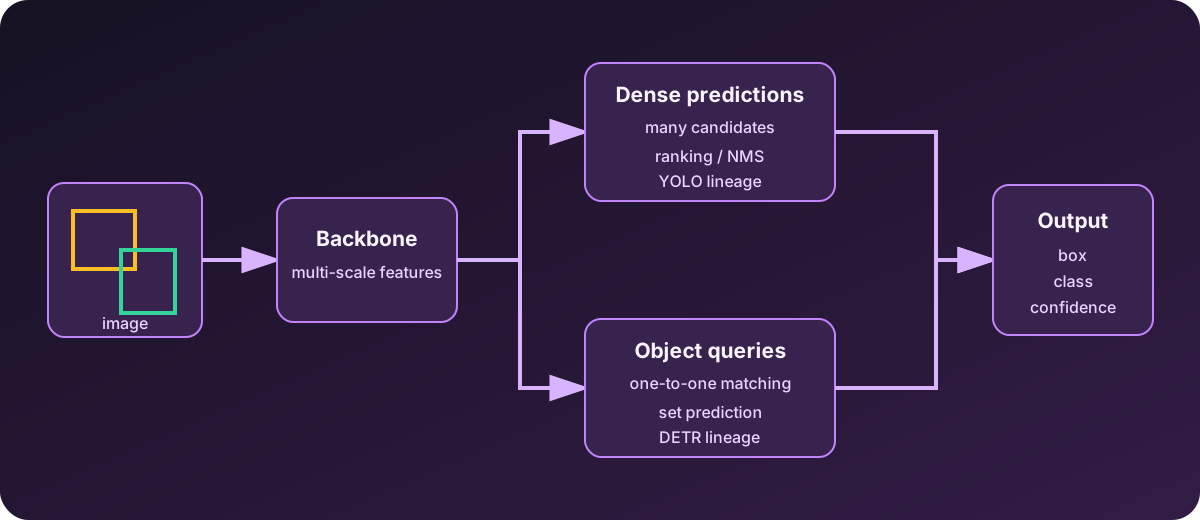
Diagramme : Duskcoil. Il illustre la conception représentative divisée entre la prédiction dense et la prédiction par ensembles.
Chaque détecteur d'objets transforme une image d'entrée en caractéristiques et renvoie finalement la position, la catégorie et le niveau de confiance. La principale distinction réside dans la création ou non de nombreux candidats et la suppression des doublons. Ensuite, le modèle peut associer les requêtes d'objets appris un à un à la vérité terrain et prédire directement un ensemble à faible duplication. Ce choix influe sur le besoin de suppression des non-maximums (NMS), l'objectif d'entraînement, la vitesse et le comportement dans les scènes encombrées.
Où se situe la famille YOLO : Vers une architecture sans NMS
La NMS traditionnelle est une étape de post-traitement qui réduit le nombre de boîtes candidates pour un même objet à une détection finale, en éliminant toute boîte dont le chevauchement (IoU : Intersection sur Union, la surface de chevauchement entre deux boîtes divisée par leur union) avec une autre dépasse un seuil.
Ce post-traitement s'exécute indépendamment du réseau et présente des inconvénients : un réglage empirique du seuil et une tendance à éliminer par erreur des objets réellement distincts et très proches les uns des autres. YOLO26, la dernière génération de YOLO, adopte une architecture sans NMS qui ne nécessite plus la suppression des non-maximums, l'étape de post-traitement standard depuis des années. Il s'agit souvent d'un goulot d'étranglement, tant pour le coût de calcul que pour la latence du pipeline d'inférence. Le supprimer vise à améliorer la vitesse d'inférence et la simplicité d'implémentation. Côté débit pur, les solutions légères et rapides restent bien fournies : RTMDet, par exemple, dépasse les 300 images par seconde.
L'essor des détecteurs basés sur les transformeurs : RF-DETR et RT-DETRv2
Autre tendance majeure : la lignée DETR (DEtection TRansformer) atteint sa maturité pratique. RT-DETR/RT-DETRv2 combinent un CNN avec un transformeur et, comme la famille YOLO, sont conçus pour fournir directement les détections finales sans NMS.
L'événement marquant de 2026 a été l'arrivée de RF-DETR, présenté à ICLR 2026. Décrit comme le premier modèle temps réel à dépasser les 60 mAP sur le benchmark COCO, il domine également le benchmark RF100-VL, qui évalue le transfert de domaine. Sa licence est Apache. 2.0 — Autorisé pour un usage commercial — contrairement à YOLO26/YOLOv12, sous licence AGPL.
Détection à vocabulaire ouvert via des invites textuelles
Une autre tendance importante est la « détection à vocabulaire ouvert » : la détection de catégories sur lesquelles le modèle n'a jamais été entraîné. YOLO-World et Grounding DINO peuvent détecter une catégorie arbitraire à partir d'une simple invite textuelle, sans données d'entraînement supplémentaires. Il s'agit d'un changement de perspective par rapport à une détection limitée à une liste de classes fixe, et cela convient parfaitement aux cas d'utilisation où les catégories du monde réel ne peuvent pas être entièrement énumérées à l'avance — la reconnaissance d'objets pour un robot polyvalent, par exemple.
Le mécanisme technique derrière l'absence de NMS
Le passage de YOLO26 à une détection sans NMS ne consiste pas simplement à supprimer une étape de post-traitement ; il résulte d'un changement de la méthode d'entraînement elle-même. La conception traditionnelle de YOLO tolérait plusieurs boîtes prédites par objet pendant l'entraînement (association un-à-plusieurs), en supposant que le NMS éliminerait les catégories superflues. Les doublons après l'inférence. YOLO26 repense la tête de prédiction en adoptant une association un-à-un, où une seule boîte englobante définitive par instance d'objet est générée dès l'entraînement. Il remplace également l'approche basée sur la distribution utilisée pour la régression des boîtes englobantes (Distribution Focal Loss) par une paramétrisation plus légère et plus adaptée au matériel, éliminant ainsi les opérations souvent instables selon les compilateurs et les environnements d'exécution. Il en résulte une inférence jusqu'à 43 % plus rapide sur CPU, ainsi qu'une implémentation de post-traitement globalement simplifiée.
RF-DETR est également sans NMS, mais par un mécanisme différent de celui de YOLO26. RF-DETR utilise un Vision Transformer pré-entraîné, DINOv2, comme base, extrait des caractéristiques multi-résolution et les transmet à un décodeur qui fonctionne avec des requêtes apprenables (représentations abstraites remplaçant les objets candidats). Chaque couche du décodeur comprend une auto-attention (capturant les relations entre les requêtes), une attention croisée déformable (se concentrant uniquement sur un petit ensemble appris de points d'échantillonnage au sein des caractéristiques de l'image), et un réseau à propagation avant qui affine la prédiction. Cette attention déformable, qui « ne se concentre que sur un petit nombre de points appris », maintient le coût de calcul inférieur à celui de l'attention croisée standard des transformateurs, tout en produisant des prédictions uniques et basées sur des ensembles — ce qui explique précisément pourquoi la sélection de nombres non linéaires (NMS) devient superflue.
Que montrent réellement les comparaisons intergénérationnelles : YOLOv8/v11/v26
Des données récentes remettent en question l'hypothèse selon laquelle « nouvelle génération = précision systématiquement supérieure ». Un test de performance réalisé en août 2026, portant sur trois générations de YOLO et cinq échelles de modèle — ciblant les structures fines (branches, fruits, autres petits objets) dans la détection de vergers et la segmentation d'instances — a révélé que le meilleur mAP@50:95 n'était pas obtenu par YOLOv26, mais par YOLOv11s-960 (0,402 mAP@50:95 pour le masque, 0,426 mAP@50:95 pour la boîte). YOLOv26s-960, quant à lui, a atteint des résultats globalement comparables. Précision avec seulement 10,37 millions de paramètres. Le constat est le suivant : les gains de précision brute ne sont pas uniformes à chaque nouvelle génération, mais l’efficacité des paramètres – obtenir la même précision avec une puissance de calcul bien moindre – progresse régulièrement.
La détection de petits objets demeure un véritable défi. Une évaluation réalisée en août 2026, comparant six variantes de YOLO et deux variantes de DETR pour la détection de véhicules militaires, a mis en évidence une tendance constante : les modèles plus grands sont plus performants, les approches basées sur DETR sont prometteuses et l’ajustement fin améliore les performances air-sol (A2G). Cependant, aucun modèle ne parvient encore à détecter les petits objets dans ce contexte. Ni la conception sans NMS de YOLO26, ni la mAP élevée de RF-DETR n’ont entièrement résolu ce problème de détection de « petits objets distants ».
Progrès de la détection à vocabulaire ouvert : chiffres concrets de précision
La génération de détecteurs à vocabulaire ouvert succédant à YOLO-World/Grounding DINO a également enregistré des gains de précision constants jusqu’en 2026. FlowOVD (mai) Grounding DINO (2026), qui utilise un flux rectifié génératif pour transformer les requêtes agnostiques au texte en requêtes guidées par le texte, affiche un score AP de 49,5 sur COCO et de 31,5 sur LVIS, soit des améliorations respectives de +1,2 AP (soit +2,5 % en relatif) et de +4,1 AP (soit +15 % en relatif) par rapport à Grounding DINO. OPUS, publié en août 2026, gère plusieurs types d'invites (textuelles, visuelles [interactives/génériques] et mixtes) au sein d'un cadre unifié. Malgré une conception plus simple qui évite la fusion intermodale complexe, il atteint des performances de pointe de 68,1/69,2/54,7 AP sur les benchmarks COCO, LVIS-minival et ODinW35. La détection à vocabulaire ouvert n'est plus seulement un avantage qualitatif (la capacité à gérer des catégories inconnues) ; elle commence également à devenir quantitativement compétitive avec les détecteurs à classes fixes.
Le paysage actuel 2026
La détection d'objets s'articule aujourd'hui autour de deux axes principaux : les architectures de transformateurs mono-étage sans NMS et la famille YOLO avec son écosystème établi. Si les transformateurs évoluent rapidement, la famille YOLO demeure la pierre angulaire des environnements de production en temps réel, grâce à sa fiabilité éprouvée et à la richesse de ses outils. Répartition par cas d'utilisation :
-
Précision avant tout : RF-DETR
-
Expérience et écosystème primordiaux : YOLO26/YOLOv12
-
Vitesse pure : RTMDet
-
Gestion des catégories inconnues : YOLO-World / Grounding DINO
Telle est la répartition actuelle des tâches.
Le mAP suffit-il à lui seul pour sélectionner un détecteur en temps réel ?
Comparez la latence et la qualité à résolution, données et matériel identiques. Temps d'inférence sans pré- et sans…
Le post-traitement n'est pas lié à la latence de bout en bout. ## Références - [Démystifier RF-DETR (Towards AI)](https://pub.towardsai.net/demystifying-rf-detr-iclr-2026-a-real-time-transformer-pushing-the-limits-of-object-detection-f4d0a9617fdd) - [Article RT-DETRv2 (arXiv)](https://arxiv.org/pdf/2407.17140) - [Article DETR sur la détection d'objets en temps réel : la supériorité de YOLO sur DETR (arXiv)](https://arxiv.org/pdf/2304.08069) - [Meilleurs modèles de détection d'objets 2026 (Blog Roboflow)](https://blog.roboflow.com/best-object-detection-models/) - [YOLO26 : Analyse d'un cadre de bout en bout sans NMS pour la détection d'objets en temps réel (arXiv)](https://arxiv.org/pdf/2601.12882) - [Article RF-DETR (ICLR 2026, arXiv)](https://arxiv.org/pdf/2511.09554) - [RF-DETR GitHub] (roboflow)](https://github.com/roboflow/rf-detr) - [Optimisation intergénérationnelle de YOLOv26, YOLOv11 et YOLOv8 (article arXiv)](https://arxiv.org/abs/2608.23636) - [Étude comparative des technologies prêtes à l'emploi pour la détection et la reconnaissance automatiques de cibles (article arXiv)](https://arxiv.org/abs/2608.17917) - [FlowOVD (article arXiv)](https://arxiv.org/abs/2606.00782) - [OPUS (article arXiv)](https://arxiv.org/abs/2608.30247)
Commentaires
Veuillez vous connecter.
Aucune entrée pour le moment.