Contents — find the section you need
目标检测的任务是从图像中同时估计目标的位置(边界框)和类别。YOLO 系列算法长期以来一直是生产环境中的首选,但到 2026 年,基于 Transformer 的检测器已经发展到足以真正威胁其地位的程度。
本文重点关注研究趋势,并首先简要介绍一些基本概念。
 目标检测
由于找不到 YOLO/Ultralytics 的免版权官方 logo,因此我们创建了一个简单的图标来表示边界框检测。
检测器设计划分概览
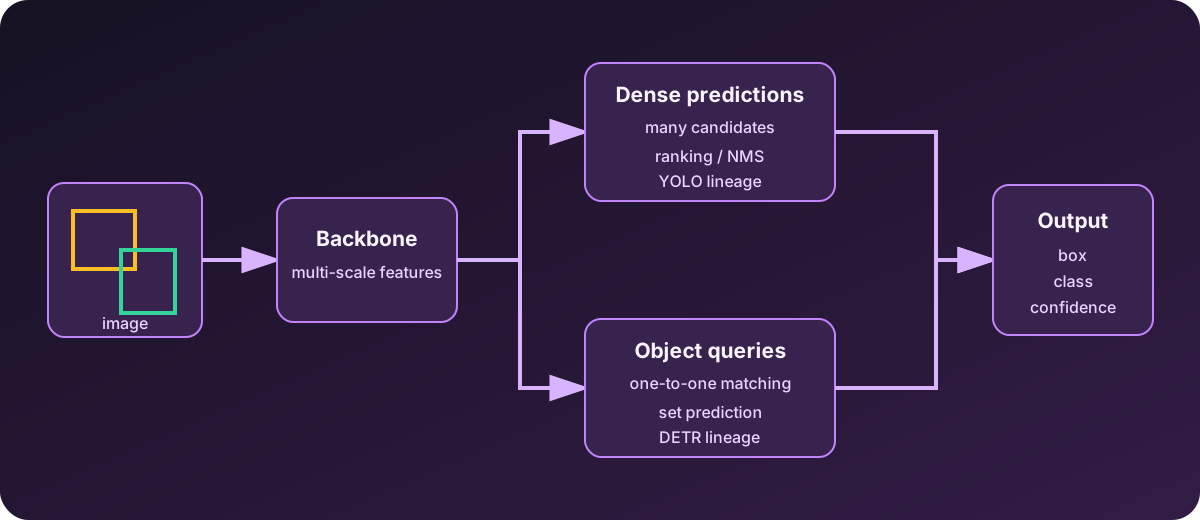
图表:Duskcoil。它突出了密集预测和集合预测之间的典型设计划分。
每个目标检测器都会将输入图像转换为特征,并最终返回位置、类别和置信度。主要区别在于它是生成大量候选框还是过滤掉不合适的候选框。之后,重复项会被剔除,或者学习到的对象查询会与真实值一一匹配,并直接预测一个低重复性集合。这种选择会影响到非极大值抑制(NMS)的需求、训练目标、速度以及在拥挤场景中的表现。
YOLO 系列的现状:摆脱 NMS
传统的 NMS 是一种后处理步骤,它将针对同一对象生成的多个候选框缩小到最终检测结果,方法是丢弃任何与其他框重叠度(IoU:交并比,即两个框的重叠面积除以它们的并集面积)超过阈值的框。
这种后处理步骤在网络之外独立运行,但它也存在一些问题:阈值的设置需要经验性调整,并且容易错误地丢弃真正不同的、紧密排列的对象。最新一代的 YOLO26 采用了一种无需 NMS 的架构,不再需要非极大值抑制,而 NMS 一直是 YOLO 系列的标准后处理步骤。多年来,NMS(非极大值抑制)一直是推理流水线中计算成本和延迟的瓶颈,移除NMS旨在提高推理速度并简化实现。在纯吞吐量方面,轻量级、高速的算法仍然非常丰富——例如,RTMDet 的帧率超过 300 FPS。
基于 Transformer 的检测器的崛起:RF-DETR 和 RT-DETRv2
另一个主要趋势是 DETR(检测变换器)系列算法逐渐走向成熟。RT-DETR/RT-DETRv2 将 CNN 与 Transformer 相结合,并且与 YOLO 系列算法一样,旨在直接输出最终检测结果,而无需 NMS。
2026 年的重大事件是 RF-DETR 的问世,该算法在 ICLR 2026 上发布。它被誉为首个在 COCO 基准测试中 mAP 突破 60 的实时模型,并且在 RF100-VL 基准测试中也名列前茅。评估域转移。其许可证为 Apache 2.0——允许商业用途——这与采用 AGPL 许可证的 YOLO26/YOLOv12 形成对比。
通过文本提示进行开放词汇检测
另一个重要的发展趋势是“开放词汇检测”——检测模型从未训练过的类别。YOLO-World 和 Grounding DINO 仅凭文本提示即可检测任意类别,无需额外的训练数据。这标志着检测思路的转变,不再局限于固定的类别列表,并且非常适合那些无法预先完全枚举现实世界类别的应用场景——例如,通用机器人的物体识别。
实现无 NMS 检测的技术机制
YOLO26 实现无 NMS 检测并非仅仅是跳过一个后处理步骤——而是源于训练方法本身的改变。传统的 YOLO 设计允许在训练过程中对每个对象进行多个预测框的生成。 YOLO26 重新设计了预测头,采用一对多分配,并假设 NMS 会在推理后去除重复项。YOLO26 则改为一对一分配,即从训练开始就为每个对象实例输出一个明确的边界框。它还用更轻量级、更适合硬件的参数化方法替换了用于边界框回归的基于分布的方法(分布焦点损失),从而减少了在不同编译器和运行时环境中不稳定的操作。最终,CPU 推理速度提升高达 43%,并且整体后处理实现也更加简单。
RF-DETR 同样不使用 NMS,但其机制与 YOLO26 不同。RF-DETR 使用预训练的 Vision Transformer DINOv2 作为骨干网络,提取多分辨率特征,并将其传递给一个解码器,该解码器处理可学习查询(代表候选对象的抽象表示)。每个解码器层都包含自注意力机制(用于捕获查询之间的关系)和可变形交叉注意力机制(仅关注查询之间的关系)。它使用一个可变形注意力机制,该机制仅关注图像特征中少量已学习的采样点,并使用一个前馈网络来优化预测结果。这种“仅关注少量已学习点”的可变形注意力机制,在保持计算成本低于标准Transformer交叉注意力机制的同时,还能生成独特的、基于集合的预测结果——这正是NMS机制不再必要的原因。
跨代比较的实际结果:YOLOv8/v11/v26
一些数据也对“新一代模型=更高精度”的假设提出了质疑。一项2026年8月的基准测试涵盖了三代YOLO模型和五个模型尺度,目标是果园检测和实例分割中的细粒度结构(树枝、果实和其他小物体)。测试发现,最高的mAP@50:95并非由YOLOv26创造,而是由YOLOv11s-960创造(掩码mAP@50:95为0.402,框内mAP@50:95为0.426)。 mAP@50:95)。与此同时,YOLOv26s-960 仅用 1037 万个参数就达到了大致相当的精度。由此可见:原始精度提升并非每一代模型都同步实现,但参数效率——即在计算量大幅减少的情况下达到相同精度——正在稳步提升。
小目标检测仍然是一个尚未解决的难题。2026 年 8 月的一项评估比较了六种 YOLO 变体和两种 DETR 变体在军用车辆检测方面的性能,发现了一个一致的规律:模型越大,性能越好;基于 DETR 的方法展现出潜力;微调可以提高空对地 (A2G) 性能——但所有模型在 A2G 场景下检测小目标仍然面临挑战。YOLO26 的无 NMS 设计以及 RF-DETR 的高 mAP 都未能完全解决“远距离小目标”检测问题。
开放词汇检测的进展:具体的 AP 数据
开放词汇的生成遵循 YOLO-World/Grounding DINO 的检测器在 2026 年也取得了稳步的准确率提升。FlowOVD(2026 年 5 月发布)使用生成式修正流将与文本无关的查询转换为文本引导的查询,在 COCO 和 LVIS 数据集上分别取得了 49.5 AP 和 31.5 AP 的成绩——分别比 Grounding DINO 提高了 1.2 AP(相对提升 2.5%)和 4.1 AP(相对提升 15.0%)。OPUS(2026 年 8 月发布)在一个统一的框架内处理多种提示类型——文本、视觉(交互式/通用)和混合型——尽管其设计更为简洁,避免了繁重的跨模态融合,但在 COCO、LVIS-minival 和 ODinW35 基准测试中,其 AP 分别达到了 68.1/69.2/54.7 的顶尖水平。开放词汇检测不再仅仅是一种定性方法。胜利——即处理未知类别的能力——正开始在数量上与固定类别检测器展开竞争。
2026 年展望
如今,目标检测主要围绕两个方面展开:单阶段、无 NMS 的 Transformer 架构,以及拥有成熟生态系统的 YOLO 系列。Transformer 架构发展迅速,但凭借其丰富的生产经验和强大的工具集,YOLO 系列仍然是实时生产环境的基石。按应用场景划分:
-
精度至上:RF-DETR
-
经验和生态系统至关重要:YOLO26/YOLOv12
-
追求极致速度:RTMDet
-
需要处理未知类别:YOLO-World / Grounding DINO
以上是当前的分工。
仅凭 mAP 能否选择实时检测器?
在分辨率、数据和硬件匹配的情况下比较延迟和质量。未进行预处理和后处理的推理时间并非端到端延迟。
评论
请先登录。
暂无数据。