Contents — find the section you need
语义分割的任务是为图像中的每个像素分配一个类别标签。目标检测是一种粗略的、边界框级别的定位任务,而分割则执行精细的、像素级别的区域划分。截至2026年,两种研究方向并行发展:一是基于Transformer方法的精细化研究,二是转向能够从提示信息中分割出任意目标的基础模型。
本文着重探讨研究趋势,并首先简要介绍一些基本概念。
 Meta AI
图片:Meta AI logo,Wikimedia Commons
.svg)
两种分割问题概览
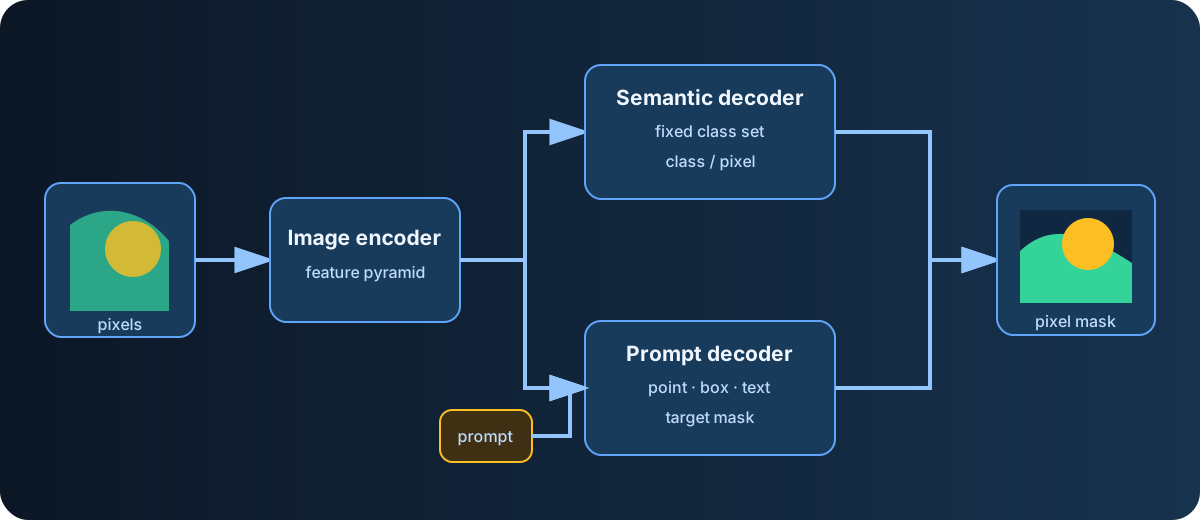
图:Duskcoil。它简化了固定类别标注和提示条件提取之间的区别。
同一个像素级掩码可以回答两个不同的问题。语义分割将每个像素分配到训练期间固定的类别。提示条件分割分割提取由点、框或文本指定的目标。这种区别使得基于固定类别平均交并比 (mIoU) 的算法谱系与优先考虑灵活迁移到新目标的“任意分割”算法谱系区分开来。
评估指标:mIoU
分割准确率通常使用 mIoU(平均交并比)进行评估,它将目标检测的 IoU 扩展到了基于类别的层面。对于给定的类别 c,IoU 由真实区域 G_c 和预测区域 P_c 之间的重叠部分计算得出,然后对所有 C 个类别取平均值。
当将其作为逐像素分类问题进行训练时,常用的损失函数是逐像素交叉熵,对所有像素取平均值并求和。
此处y_{n,c} 是真实标签——如果像素 n 确实属于类别 c,则为 1,否则为 0——而 \hat{y}_{n,c} 是模型预测像素 n 属于类别 c 的概率。
基于 Transformer 的方法的终点:SegFormer 和 Mask2Former
取代基于 CNN 的方法(例如 FCN、U-Net 等)的主流方法是基于 Transformer 构建的方法。SegFormer 将 CNN 的层级结构与 Transformer 的全局建模能力相结合,使用层级 Transformer 编码器和轻量级 MLP 解码器。它被认为是一种可靠且高精度的分割方法,适用于鱼眼图像和标准图像。
Mask2Former 更进一步,将分割问题建模为基于查询的掩码分类问题。它将保留高分辨率空间信息的像素解码器与学习固定数量查询的Transformer解码器相结合,其中每个查询关注一个相关区域,以预测掩码及其类别。基于Swin-L骨干网络,它在全景分割、实例分割和语义分割这三种分割类型上均达到了最先进的性能,并且引入掩码注意力机制使其收敛速度比Mask R-CNN快8倍。
Mask2Former的“掩码注意力机制”为何如此快速
Mask2Former之所以能够兼顾快速收敛和高精度,其技术核心在于掩码注意力机制:标准的Transformer解码器会针对整幅图像计算交叉注意力,而Mask2Former则将每个查询的注意力限制在前一层预测的掩码的前景区域。与其每次都重新检查整幅图像,不如将范围缩小到紧邻前一个预测所暗示的“局部相关区域”,这样既减少了计算浪费,又能更准确地提取局部特征。
整体架构由骨干网络和特征组成。该模型包含一个提取器、一个保留高分辨率空间信息的像素解码器和一个9层Transformer解码器(可容纳100个可学习查询)。为了处理小目标,它还采用了一种多尺度策略,将像素解码器生成的特征金字塔(三个分辨率级别——1/8、1/16和1/32)以循环方式输入到连续的Transformer解码器层中。这种设计在所有三种分割类型(全景分割、实例分割和语义分割)上都取得了优异的性能,并且收敛速度比Mask R-CNN快8倍。
基于提示的转变:任意分割模型的传承
另一个主要趋势是“基于提示”的分割,它不受任何预先设定的固定类别列表的限制。Meta公司于2023年发布的任意分割模型(SAM)以各种提示作为输入——例如一个点、一个边界框、一个粗略的掩码——并从中生成高质量的分割掩码。这种转变——基于提示来分割任意目标——与其基于固定的类别列表进行预测,不如采用更灵活的方式——这极大地推动了计算机视觉基础建模的发展。
其后续版本 SAM 2 用 Hiera 取代了单尺度 ViT。Hiera 是一个多尺度分层视觉 Transformer,通过掩码自编码进行预训练,并增加了对视频分割的支持。它在 37 个零样本数据集上以 130 FPS 的帧率运行,同时保持了较高的准确率(mIoU 为 58.9/81.7)。
2026 年,Meta 公司推出了 SAM 3,它可以检测、分割和跟踪由文本提示或示例图像指定的“视觉概念”。这是基于提示的通用分割方向的下一步发展,并将分割能力提升到了更高的层次,即能够用文本指定概念。
SAM 3 迈向实际应用:视频分割竞赛成果
自 2026 年初以来,基于 SAM 3 的应用研究成果在各个领域迅速涌现。 SAM 3 的核心特性——通过文本提示指定概念——已被反复应用于多个专业领域,例如:海上监视(MariSat,一个将 SAM 3 构建成半自动标注流程的海事数据集)和通信塔巡检(从杂乱的无人机航拍图像中提取组件)等等。
在 ECCV 2026 上举办的第八届 LSVOS 挑战赛 MOSEv2 赛道的比赛结果,可以很好地衡量视频分割技术的发展程度。SAM3Dual 是一种基于 SAM 3 的无需训练的方法,它结合了两个时间记忆分支——一个用于最近帧,一个用于历史上下文——以 64.37 的 J&F 得分位列第三。在同一比赛中获得第二名的 Competitive Memory Readout,在从记忆中检索目标信息时,会明确地将同类“竞争对手”对象的信息纳入考量,其主要指标得分达到了 66.20。这两个结果都强调了在时间维度上保持对象身份的重要性。在视频中(在整个序列中持续跟踪同一目标物体)仍然是决定 SAM 系列模型实际性能的核心挑战。
轻量级和少样本自适应的具体示例
进一步提升 SegFormer/Mask2Former 系列模型效率的努力也在持续进行。DPNeXt(2026 年 7 月)是一个基于 ViT 的密集预测(分割加上深度估计等多任务处理)的轻量级解码器,与标准的 DPT(密集预测 Transformer)相比,其可训练参数减少了 78.6%,同时在 Cityscapes 和 NYUv2 基准测试中保持了最先进的性能。TraceCLIP(2026 年 7 月)是一种完全无需训练的方法,它通过隔离每个图像块对 CLIP 的 CLS-token 注意力机制的贡献来恢复局部语义信息,在八个零样本语义数据集上,其 mIoU 值比之前最强的方法提高了 1.3 到 4.5 个百分点。分割基准测试。
HASTE(2026 年 7 月)就是一个少样本自适应的具体例子。它是一个利用卫星图像快速评估灾后建筑损坏的平台。通过利用基础模型嵌入,HASTE 仅使用二十分之一的标签,就达到了与全监督 ResNet-50 基线模型(使用整个数据集的标签进行训练)相同的精度。自 2023 年以来,HASTE 已支持超过 30 次真实世界的灾害响应,包括地震、飓风和野火。它具体体现了基础模型时代分割技术的目标:以极低的标注成本获得生产级精度。
何时使用哪种方法
目前的实际应用场景如下:对于类别已知的固定任务(例如,道路场景中的汽车、行人、标志),基于 Transformer 的方法(例如 SegFormer/Mask2Former 系列)在精度和效率方面都更胜一筹;对于其他情况,例如……对于处理未知目标或样本量较小的情况,基于 SAM 系列提示的基础模型展现了其优势——而且这种分工还在不断巩固。
较高的总体 mIoU 是否能保证良好的小障碍物分割?
平均值可能会掩盖特定类别或尺寸的弱点。检查相关类别、边界、误报和漏检区域。
评论
请先登录。
暂无数据。