Contents — find the section you need
La segmentation sémantique consiste à attribuer une étiquette de catégorie à chaque pixel d'une image. Alors que la détection d'objets est une tâche de localisation grossière, au niveau des boîtes englobantes, la segmentation effectue une division fine des régions, au niveau du pixel. En 2026, deux tendances coexistent : le raffinement par des méthodes basées sur les transformeurs et l'évolution vers des modèles de base capables d'identifier une cible arbitraire à partir d'une séquence donnée.
Cet article se concentre sur les tendances de la recherche et présente brièvement les concepts essentiels.
 Meta AI
Image : Logo Meta AI, Wikimedia Commons
.svg)
Deux problèmes de segmentation en un coup d'œil
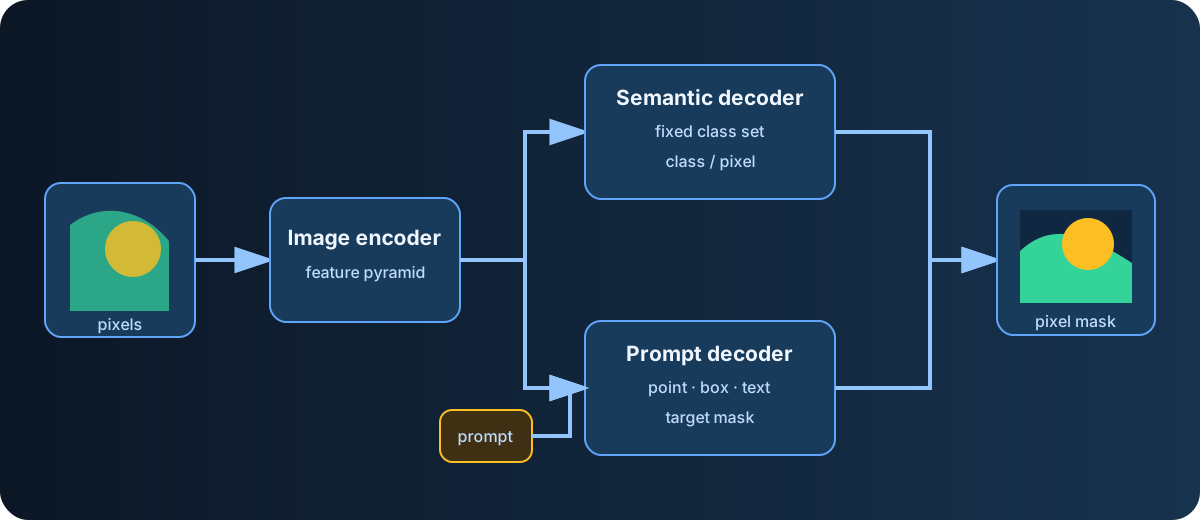
Diagramme : Duskcoil. Il simplifie la distinction entre l'étiquetage à classe fixe et l'extraction conditionnée par une invite.
Un même masque au niveau du pixel peut répondre à deux questions différentes. La segmentation sémantique attribue chaque pixel à une classe fixée lors de l'entraînement. La segmentation extrait la cible spécifiée par un point, un rectangle ou du texte. Cette distinction permet de séparer la lignée qui utilise le mIoU (Intersection moyenne sur Union) pour des classes fixes de celle qui privilégie la segmentation flexible vers de nouvelles cibles.
Métrique d'évaluation : mIoU
La précision de la segmentation est généralement évaluée avec le mIoU, qui étend l'IoU de la détection d'objets à une base par classe. Pour une classe donnée c, l'IoU est calculé à partir du chevauchement entre la région de référence G_c et la région prédite P_c, puis moyenné sur toutes les classes C.
Lors de l'entraînement de ce modèle comme un problème de classification par pixel, la fonction de perte couramment utilisée est l'entropie croisée par pixel, moyennée et sommée sur tous les pixels.
Ici y_{n,c} est l'étiquette de référence (1 si le pixel n appartient effectivement à la classe c, 0 sinon) et \hat{y}_{n,c} est la probabilité prédite par le modèle que le pixel n appartienne à la classe c.
Le point d'aboutissement des méthodes basées sur les transformeurs : SegFormer et Mask2Former
Les méthodes basées sur les CNN (FCN, U-Net, etc.) se sont généralisées au profit des méthodes construites autour d'un transformeur. SegFormer combine la structure hiérarchique d'un CNN avec la capacité de modélisation globale d'un transformeur, en utilisant un encodeur transformeur hiérarchique associé à un décodeur MLP léger. Cette méthode est considérée comme fiable et très précise, aussi bien pour les images fisheye que pour les images standard.
Mask2Former va plus loin en formulant la segmentation comme un problème de classification de masques basé sur une requête. Il associe un pixel à un autre. Un décodeur préservant les informations spatiales haute résolution grâce à un décodeur Transformer apprenant un nombre fixe de requêtes. Chaque requête se concentre sur une région pertinente pour prédire un masque et sa catégorie. Basé sur une architecture Swin-L, il atteint des performances de pointe pour les trois types de segmentation (panoptique, instance et sémantique). L'introduction de l'attention masquée lui permet de converger huit fois plus vite que Mask R-CNN.
Pourquoi l'« attention masquée » de Mask2Former est-elle si rapide ?
Le secret de la rapidité de convergence et de la haute précision de Mask2Former réside dans l'attention masquée : contrairement à un décodeur Transformer standard qui calcule l'attention croisée sur l'ensemble de l'image, Mask2Former limite l'attention de chaque requête à la seule région de premier plan du masque prédit par la couche précédente. Plutôt que de réexaminer l'image entière à chaque fois, se concentrer sur la « région pertinente locale » induite par la prédiction précédente réduit les calculs inutiles tout en extrayant les caractéristiques locales avec une plus grande précision.
L'architecture globale se compose d'un Un extracteur de caractéristiques de base, un décodeur de pixels préservant les informations spatiales haute résolution et un décodeur Transformer à 9 couches (contenant 100 requêtes apprenables). Pour traiter les petits objets, il utilise également une stratégie multi-échelle, alimentant les couches successives de décodeur Transformer avec la pyramide de caractéristiques produite par le décodeur de pixels (trois niveaux de résolution : 1/8, 1/16 et 1/32), selon un principe de round-robin. Cette conception offre d'excellentes performances pour les trois types de segmentation (panoptique, instance et sémantique) et converge 8 fois plus vite que Mask R-CNN.
Le changement basé sur les invites : la lignée de Segment Anything
Une autre tendance majeure est la segmentation « basée sur les invites », affranchie de toute liste de catégories prédéfinie. Le modèle Segment Anything (SAM), publié par Meta en 2023, prend en entrée diverses invites (un point, une boîte englobante, un masque approximatif) et génère un masque de segmentation de haute qualité. Ce changement consiste à créer un masque de segmentation plus précis. La segmentation arbitraire basée sur une consigne, plutôt que sur une liste de classes fixe, a donné une impulsion majeure à la modélisation fondamentale de la vision par ordinateur.
Son successeur, SAM 2, a remplacé ViT (Virtual Transformor) à échelle unique par Hiera, un Vision Transformer hiérarchique multi-échelle pré-entraîné par auto-encodage masqué, et a ajouté la prise en charge de la segmentation vidéo. Il fonctionne à 130 images par seconde sur 37 jeux de données sans exemple, tout en conservant une précision élevée (mIoU 58,9/81,7).
En 2026, Meta a lancé SAM 3, capable de détecter, segmenter et suivre un « concept visuel » spécifié par une consigne textuelle ou une image d'exemple. Il s'agit de la prochaine étape dans la même direction : la segmentation à usage général basée sur une consigne, poussée plus loin en permettant la spécification d'un concept par du texte.
SAM 3 : Déploiement concret : Résultats des compétitions de segmentation vidéo
Depuis début 2026, les recherches appliquées basées sur SAM 3 se sont rapidement développées dans divers domaines. La caractéristique principale de SAM 3 — la spécification d'un concept par invite textuelle — a été maintes fois reprise dans des domaines spécialisés : la surveillance maritime (MariSat, un jeu de données maritimes qui intègre SAM 3 dans un pipeline d'annotation semi-automatique) et l'inspection des tours de communication (extraction de composants à partir d'images aériennes UAV complexes), entre autres.
Les résultats de la catégorie MOSEv2 du 8e défi LSVOS, qui s'est tenu à ECCV 2026, offrent un bon aperçu des progrès réalisés en segmentation vidéo. SAM3Dual, une méthode sans entraînement basée sur SAM 3 et combinant deux branches de mémoire temporelle — l'une pour les images récentes, l'autre pour le contexte historique — s'est classée troisième avec un score J&F de 64,37. Competitive Memory Readout, qui a pris la deuxième place lors de cette même compétition, intègre explicitement les informations relatives aux objets « concurrents » de même classe lors de la récupération des informations cibles en mémoire, atteignant un score de 66,20 sur la métrique principale. Ces deux résultats soulignent l'importance de préserver l'identité des objets au fil du temps. Le suivi vidéo (le suivi continu du même objet comme cible tout au long d'une séquence) demeure le principal défi déterminant les performances réelles des modèles de la famille SAM.
Exemples concrets d'allègement et d'adaptation à partir de quelques exemples
Les efforts visant à améliorer encore l'efficacité de la famille SegFormer/Mask2Former se poursuivent. DPNeXt (juillet 2026), un décodeur léger pour la prédiction dense basée sur ViT (segmentation et tâches multiples telles que l'estimation de profondeur), réduit de 78,6 % le nombre de paramètres entraînables par rapport à un DPT (Dense Prediction Transformer) standard, tout en conservant des performances de pointe sur les benchmarks Cityscapes et NYUv2. TraceCLIP (juillet 2026), une méthode entièrement sans entraînement qui récupère les informations sémantiques locales en isolant la contribution individuelle de chaque patch à l'attention CLS-token de CLIP, affiche des améliorations du mIoU de 1,3 à 4,5 points par rapport aux meilleures méthodes précédentes sur huit segmentations sémantiques sans exemple. Points de référence.
Pour un exemple concret d'adaptation à partir de peu d'exemples, citons HASTE (juillet 2026), une plateforme d'évaluation rapide des dommages aux bâtiments après une catastrophe, à partir d'images satellites. Grâce à l'utilisation d'embeddings issus d'un modèle de base, elle atteint la précision d'un modèle ResNet-50 entièrement supervisé (entraîné sur l'ensemble des données étiquetées) tout en utilisant vingt fois moins d'étiquettes. Depuis 2023, elle a été utilisée pour plus de 30 interventions d'urgence suite à des catastrophes réelles (séismes, ouragans, feux de forêt). Elle illustre parfaitement l'objectif de la segmentation à l'ère des modèles de base : une précision optimale pour un coût d'étiquetage considérablement réduit.
Quand utiliser quelle méthode ?
En pratique, voici le constat : pour une tâche fixe où les catégories sont connues à l'avance (voitures, piétons, panneaux de signalisation, par exemple), les méthodes basées sur les transformeurs de la famille SegFormer/Mask2Former sont plus performantes en termes de précision et d'efficacité ; pour les situations nécessitant la gestion de cibles inconnues… Pour les cas où les exemples sont peu nombreux, les modèles de base de la famille SAM, basés sur des invites, démontrent leur efficacité – et cette division du travail ne cesse de se consolider.
Un mIoU global élevé garantit-il une bonne segmentation des petits obstacles ?
Les moyennes peuvent masquer des faiblesses spécifiques à une classe ou à une taille. Examinez les classes pertinentes, les frontières, les faux positifs et les régions non segmentées.
Commentaires
Veuillez vous connecter.
Aucune entrée pour le moment.