Contents — find the section you need
Semantische Segmentierung ist die Aufgabe, jedem einzelnen Pixel eines Bildes eine Kategorie zuzuordnen. Während die Objekterkennung eine grobe Lokalisierungsaufgabe auf Begrenzungsrahmenebene darstellt, führt die Segmentierung eine feinere, pixelgenaue Bereichsaufteilung durch. Ab 2026 verlaufen zwei Forschungsrichtungen parallel: die Verfeinerung durch transformatorbasierte Methoden und die Hinwendung zu Basismodellen, die aus einer vorgegebenen Eingabe ein beliebiges Zielobjekt extrahieren können.
Dieser Artikel konzentriert sich auf Forschungstrends und stellt zunächst kurz die wichtigsten Konzepte vor.
 Meta AI
Bild: Meta AI Logo, Wikimedia Commons
.svg)
Zwei Segmentierungsprobleme im Überblick
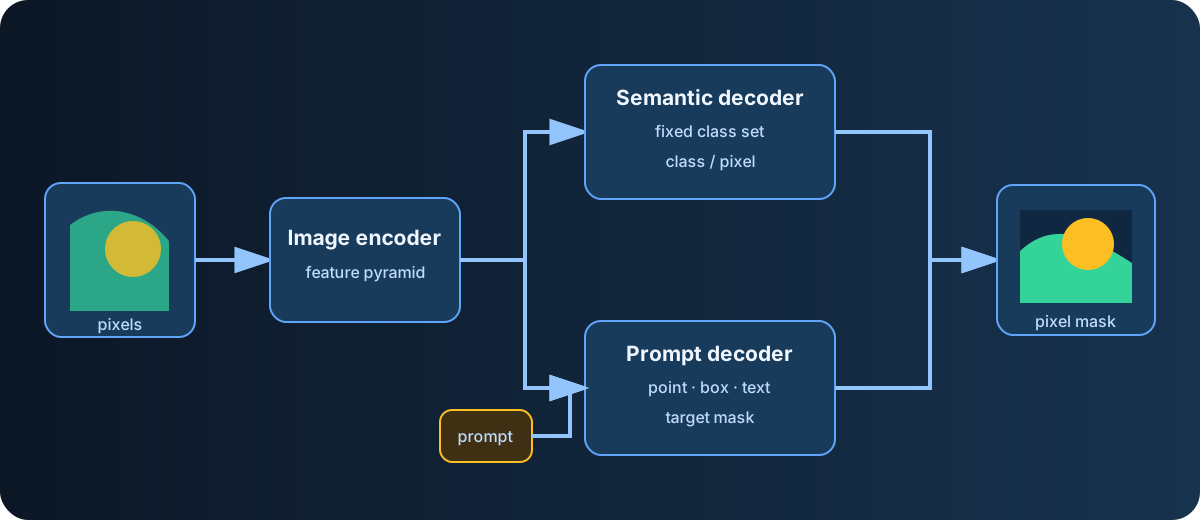
Diagramm: Duskcoil. Es vereinfacht die Unterscheidung zwischen der Kennzeichnung mit fester Klasse und der promptbedingten Extraktion.
Dieselbe Maske auf Pixelebene kann zwei verschiedene Fragen beantworten. Die semantische Segmentierung ordnet jedem Pixel eine während des Trainings festgelegte Klasse zu. Die Promptable-Segmentierung extrahiert das durch einen Punkt, ein Rechteck oder Text angegebene Ziel. Diese Unterscheidung trennt die Segmentierungsmethode, die auf fester Klassengenauigkeit basiert, von der Methode „Segment Anything“, die flexible Übertragung auf neue Ziele priorisiert.
Bewertungsmetrik: mIoU
Die Segmentierungsgenauigkeit wird üblicherweise mit mIoU (mittlere Schnittmenge über Vereinigung) bewertet, welches die IoU der Objekterkennung auf Klassenbasis erweitert. Für eine gegebene Klasse c wird die IoU aus der Überlappung zwischen dem tatsächlichen Bereich G_c und dem vorhergesagten Bereich P_c berechnet und anschließend über alle C Klassen gemittelt.
Beim Training als pixelgenaues Klassifizierungsproblem wird üblicherweise die pixelgenaue Kreuzentropie als Verlustfunktion verwendet, gemittelt und summiert über alle Pixel.
Hierbei ist y_{n,c} die tatsächliche Klassenbezeichnung – 1, wenn Pixel n tatsächlich zur Klasse c gehört, 0 sonst – und \hat{y}_{n,c} die vom Modell vorhergesagte Wahrscheinlichkeit, dass Pixel n zur Klasse c gehört.
Der Endpunkt transformatorbasierter Methoden: SegFormer und Mask2Former
Anstelle von CNN-basierten Methoden (FCN, U-Net usw.) haben sich transformatorbasierte Verfahren etabliert. SegFormer kombiniert die hierarchische Struktur eines CNN mit der globalen Modellierungsfähigkeit eines Transformers. Dazu wird ein hierarchischer Transformer-Encoder mit einem ressourcenschonenden MLP-Decoder verwendet. Es gilt als zuverlässiges und hochpräzises Verfahren für Fisheye- und Standardbilder.
Mask2Former geht noch einen Schritt weiter und formuliert die Segmentierung als abfragebasiertes Verfahren. Mask2Former löst das Problem der Maskenklassifizierung. Es kombiniert einen Pixeldecoder, der hochauflösende räumliche Informationen erhält, mit einem Transformerdecoder, der eine feste Anzahl von Anfragen lernt. Jede Anfrage konzentriert sich dabei auf einen relevanten Bereich, um eine Maske und ihre Kategorie vorherzusagen. Basierend auf einem Swin-L-Backbone erzielt es Bestleistungen bei allen drei Segmentierungstypen – panoptisch, instanzbezogen und semantisch. Durch die Einführung von Masked Attention konvergiert es achtmal schneller als Mask R-CNN.
Warum Mask2Formers „Masked Attention“ so schnell ist
Der technische Kern von Mask2Former, der schnelle Konvergenz mit hoher Genauigkeit verbindet, ist Masked Attention: Während ein Standard-Transformerdecoder die Cross-Attention auf das gesamte Bild berechnet, beschränkt Mask2Former die Aufmerksamkeit jeder Anfrage auf den Vordergrundbereich der in der vorherigen Schicht vorhergesagten Maske. Anstatt jedes Mal das gesamte Bild erneut zu untersuchen, reduziert die Beschränkung auf den „lokal relevanten Bereich“, der durch die unmittelbar vorhergehende Vorhersage impliziert wird, unnötige Rechenleistung und extrahiert gleichzeitig mehr lokale Merkmale. Genau.
Die Gesamtarchitektur besteht aus einem Feature-Extraktor als Basis, einem Pixel-Decoder, der hochauflösende räumliche Informationen erhält, und einem 9-schichtigen Transformer-Decoder (mit 100 lernbaren Abfragen). Zur Verarbeitung kleiner Objekte wird eine Multi-Scale-Strategie verwendet, bei der die vom Pixel-Decoder erzeugte Feature-Pyramide (drei Auflösungsstufen – 1/8, 1/16, 1/32) nacheinander in die Transformer-Decoder-Schichten eingespeist wird. Dieses Design erzielt eine hohe Leistung bei allen drei Segmentierungstypen – panoptisch, instanzbezogen und semantisch – und konvergiert 8-mal schneller als Mask R-CNN.
Der Prompt-basierte Wandel: Die Segment Anything-Linie
Ein weiterer wichtiger Trend ist die „promptbasierte“ Segmentierung, die nicht durch eine vorgegebene, feste Kategorienliste eingeschränkt ist. Das Segment Anything Model (SAM), das 2023 von Meta veröffentlicht wurde, verwendet verschiedene Eingabeparameter – einen Punkt, einen Begrenzungsrahmen, eine grobe Maske – und generiert ein Hochwertige Segmentierungsmasken werden aus ihnen extrahiert. Dieser Wandel – die Auswahl eines beliebigen Ziels anhand einer Eingabeaufforderung anstatt der Vorhersage anhand einer festen Klassenliste – gab der Grundlagenmodellierung der Computer Vision einen entscheidenden Schub.
Sein Nachfolger, SAM 2, ersetzte den einskaligen ViT durch Hiera, einen mehrskaligen hierarchischen Vision Transformer, der mittels maskiertem Autoencoding vortrainiert wurde, und fügte Unterstützung für Videosegmentierung hinzu. Er läuft mit 130 FPS auf 37 Zero-Shot-Datensätzen bei gleichzeitig hoher Genauigkeit (mIoU 58,9/81,7).
2026 brachte Meta dann SAM 3 heraus, das ein durch eine Texteingabeaufforderung oder ein Beispielbild spezifiziertes „visuelles Konzept“ erkennen, segmentieren und verfolgen kann. Es ist der nächste Schritt in dieselbe Richtung – eingabeaufforderungsbasierte, universelle Segmentierung – und geht noch einen Schritt weiter, indem es ein Konzept in Text spezifiziert.
SAM 3 erreicht den realen Einsatz: Ergebnisse von Videosegmentierungswettbewerben
Seit Beginn von Seit 2026 hat die angewandte Forschung auf Basis von SAM 3 in verschiedensten Bereichen rasant zugenommen. Das charakteristische Merkmal von SAM 3 – die Spezifizierung eines Konzepts per Texteingabe – wurde wiederholt in spezialisierte Domänen übertragen: maritime Überwachung (MariSat, ein maritimer Datensatz, der SAM 3 in eine halbautomatische Annotationspipeline integriert) und Inspektion von Kommunikationstürmen (Hervorhebung von Komponenten aus unübersichtlichen UAV-Luftbildern), um nur einige zu nennen.
Die Ergebnisse des MOSEv2-Tracks der 8. LSVOS Challenge, die im Rahmen der ECCV 2026 stattfand, bieten einen guten Anhaltspunkt für den Fortschritt der Videosegmentierung. SAM3Dual, eine trainingsfreie Methode auf Basis von SAM 3, die zwei temporale Speicherzweige kombiniert – einen für aktuelle Frames und einen für den historischen Kontext –, belegte mit einem J&F-Score von 64,37 den dritten Platz. Competitive Memory Readout, das im selben Wettbewerb den zweiten Platz erreichte, bezieht explizit Informationen über Objekte derselben Klasse („Konkurrenten“) beim Abruf von Zielinformationen aus dem Speicher ein und erzielt dadurch eine Der primäre Metrikwert liegt bei 66,20. Beide Ergebnisse unterstreichen, dass die Erhaltung der Objektidentität über die Zeit in Videos (die kontinuierliche Verfolgung desselben Objekts als Zielobjekt innerhalb einer Sequenz) weiterhin die zentrale Herausforderung für die Leistungsfähigkeit von SAM-Modellen darstellt.
Konkrete Beispiele für Lightweighting und Few-Shot-Adaptation
Auch die Bemühungen zur weiteren Effizienzsteigerung der SegFormer/Mask2Former-Familie werden fortgesetzt. DPNeXt (Juli 2026), ein Lightweight-Decoder für ViT-basierte dichte Vorhersage (Segmentierung plus Multitasking-Aufgaben wie Tiefenschätzung), reduziert die trainierbaren Parameter im Vergleich zu einem Standard-DPT (Dense Prediction Transformer) um 78,6 % und erzielt dabei Bestleistungen auf den Cityscapes- und NYUv2-Benchmarks. TraceCLIP (Juli 2026), eine vollständig trainingsfreie Methode, die lokale semantische Informationen durch die Isolierung des individuellen Beitrags jedes Patches zur CLS-Token-Aufmerksamkeit von CLIP wiederherstellt, berichtet Verbesserungen des mIoU-Werts um 1,3 bis 4,5 Punkte gegenüber den bisher besten Methoden in acht Zero-Shot-Benchmarks für semantische Segmentierung.
Ein konkretes Beispiel für die Anpassung an wenige Beispiele ist HASTE (Juli 2026), eine Plattform zur schnellen Bewertung von Gebäudeschäden nach Katastrophen anhand von Satellitenbildern. Durch die Nutzung von Foundation-Model-Embeddings erreicht sie die Genauigkeit eines vollständig überwachten ResNet-50-Baseline-Modells (das mit den Labels des gesamten Datensatzes trainiert wurde) bei nur einem Zwanzigstel der Anzahl der Labels. Seit 2023 hat HASTE über 30 reale Katastropheneinsätze – Erdbeben, Hurrikane, Waldbrände – unterstützt. Es ist ein konkretes Beispiel dafür, was die Segmentierung im Foundation-Model-Zeitalter anstrebt: Genauigkeit auf Produktionsniveau bei einem Bruchteil der Labeling-Kosten.
Wann welche Methode verwenden?
Die praktische Aufschlüsselung ist derzeit folgende: Für eine feste Aufgabe, bei der die Kategorien bereits bekannt sind (z. B. Autos, Fußgänger, Verkehrsschilder), Transformerbasierte Methoden der SegFormer/Mask2Former-Familie sind hinsichtlich Genauigkeit und Effizienz überlegen. Bei Situationen, die die Verarbeitung unbekannter Ziele oder Fälle mit wenigen Beispielen erfordern, spielen die promptbasierten Modelle der SAM-Familie ihre Stärken aus – und diese Arbeitsteilung festigt sich weiter.
Garantiert ein hoher Gesamt-mIoU eine gute Segmentierung kleiner Hindernisse?
Mittelwerte können klassen- oder größenspezifische Schwächen verschleiern. Untersuchen Sie relevante Klassen, Grenzen, falsch-positive Ergebnisse und nicht erfasste Bereiche.
Referenzen
- SegFormer/Mask2Former Comparative Evaluation Paper (MDPI)
- From SAM to SAM 2: Exploring Improvements in Meta's Segment Anything Model (arXiv)
- SAM 3 Official Dokumentation (Ultralytics)
- Ein neuartiger Benchmark für die semantische Segmentierung mit wenigen Beispielen im Zeitalter der Foundation Models (arXiv)
- SAM3Dual (MOSEv2, LSVOS Challenge) Paper (arXiv)
-
Competitive Memory Readout for Robust Video Object Segmentation Paper (arXiv)
Kommentare
Bitte zuerst anmelden.
Noch keine Einträge.