Contents — find the section you need
Objekterkennung ist die Aufgabe, gleichzeitig die Position (Begrenzungsrahmen) und die Kategorie eines Objekts in einem Bild zu bestimmen. Die YOLO-Familie war lange Zeit die erste Wahl für den Produktiveinsatz, doch bis 2026 werden transformatorbasierte Detektoren diese Position ernsthaft gefährden.
Dieser Artikel konzentriert sich auf Forschungstrends und stellt zunächst kurz die wichtigsten Konzepte vor.
 Objekterkennung
Da kein lizenzfreies offizielles Logo für YOLO/Ultralytics gefunden werden konnte, wurde stattdessen ein einfaches Symbol für die Begrenzungsrahmenerkennung erstellt.
Die Aufteilung des Detektordesigns auf einen Blick
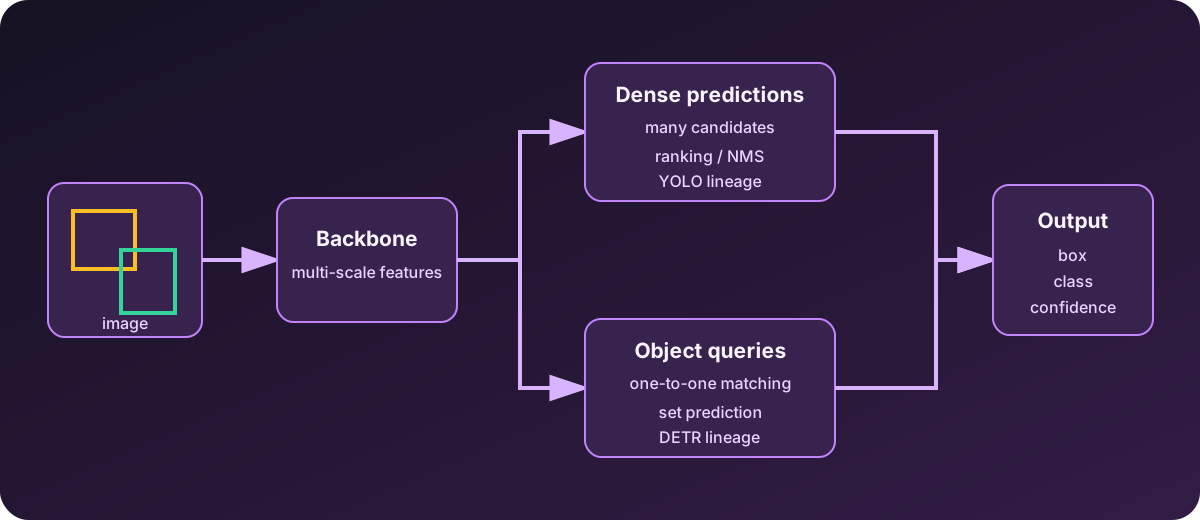
Diagramm: Duskcoil. Es verdeutlicht die repräsentative Aufteilung des Designs zwischen dichter Vorhersage und Set-Vorhersage.
Jeder Objektdetektor wandelt ein Eingabebild in Merkmale um und gibt letztendlich Position, Kategorie und Konfidenzwerte zurück. Der Hauptunterschied besteht darin, ob er viele Kandidaten generiert und überflüssige entfernt. Duplikate werden anschließend entfernt, oder gelernte Objektabfragen werden eins zu eins mit den tatsächlichen Objekten abgeglichen, und es wird direkt eine Menge mit geringer Duplikathäufigkeit vorhergesagt. Diese Entscheidung beeinflusst die Notwendigkeit von NMS, das Trainingsziel, die Geschwindigkeit und das Verhalten in überfüllten Szenen.
Wo steht die YOLO-Familie? Weg von NMS
Das traditionelle NMS ist ein Nachbearbeitungsschritt, der mehrere Kandidatenboxen für dasselbe Objekt auf eine endgültige Erkennung reduziert, indem alle Boxen verworfen werden, deren Überlappung (IoU: Intersection over Union, die Überlappungsfläche zweier Boxen geteilt durch ihre Vereinigungsfläche) mit einer anderen einen Schwellenwert überschreitet.
Diese Nachbearbeitung läuft als unabhängiger Schritt außerhalb des Netzwerks und bringt Nachteile mit sich: die empirische Optimierung des Schwellenwerts und die Tendenz, tatsächlich unterschiedliche, dicht beieinander liegende Objekte fälschlicherweise zu verwerfen. YOLO26, die neueste Generation von YOLO, verwendet eine NMS-freie Architektur, die keine Non-Maximum Suppression mehr benötigt, den bisher standardmäßigen Nachbearbeitungsschritt. Seit Jahren stellt NMS (Network Message Support) einen Engpass hinsichtlich Rechenkosten und Latenz in der Inferenzpipeline dar. Die Entfernung von NMS zielt darauf ab, sowohl die Inferenzgeschwindigkeit als auch die Implementierungsvereinfachung zu verbessern. Auch im Bereich des reinen Durchsatzes ist das Spektrum an ressourcenschonenden und schnellen Lösungen weiterhin gut besetzt – RTMDet beispielsweise erreicht über 300 FPS.
Der Aufstieg transformatorbasierter Detektoren: RF-DETR und RT-DETRv2
Ein weiterer wichtiger Trend ist die zunehmende Praxistauglichkeit der DETR-Technologie (DEtection TRANSformer). RT-DETR/RT-DETRv2 kombinieren ein CNN mit einem Transformer und sind, wie die YOLO-Familie, darauf ausgelegt, die endgültigen Detektionen direkt ohne NMS auszugeben.
Das wichtigste Ereignis des Jahres 2026 war die Vorstellung von RF-DETR auf der ICLR 2026. Es gilt als erstes Echtzeitmodell, das im COCO-Benchmark über 60 mAP erreicht hat und führt auch den RF100-VL-Benchmark an, der … Domainübertragung. Die Lizenz ist Apache 2.0 – erlaubt die kommerzielle Nutzung – im Gegensatz zu YOLO26/YOLOv12, das unter der AGPL lizenziert ist.
Erkennung mit offenem Vokabular durch Texteingaben
Ein weiterer wichtiger Trend ist die „Erkennung mit offenem Vokabular“ – die Erkennung von Kategorien, mit denen das Modell nie trainiert wurde. YOLO-World und Grounding DINO können anhand einer Texteingabe ohne zusätzliche Trainingsdaten eine beliebige Kategorie erkennen. Dies bedeutet einen Paradigmenwechsel weg von der Erkennung anhand einer festen Klassenliste und eignet sich gut für Anwendungsfälle, in denen die realen Kategorien nicht vollständig im Voraus erfasst werden können – beispielsweise die Objekterkennung für einen Allzweckroboter.
Der technische Mechanismus hinter dem Verzicht auf NMS
Der Wechsel von YOLO26 zur NMS-freien Erkennung besteht nicht nur im Wegfall eines Nachbearbeitungsschritts – er beruht auf einer Änderung der Trainingsmethode selbst. Das traditionelle YOLO-Design tolerierte während des Trainings mehrere vorhergesagte Boxen pro Objekt. YOLO26 verwendet eine Eins-zu-Viele-Zuordnung, wobei angenommen wird, dass NMS Duplikate nach der Inferenz entfernt. YOLO26 überarbeitet den Vorhersagekopf und verwendet nun eine Eins-zu-Eins-Zuordnung, bei der ab dem Training pro Objektinstanz ein eindeutiger Begrenzungsrahmen ausgegeben wird. Der bisherige verteilungsbasierte Ansatz für die Begrenzungsrahmenregression (Distribution Focal Loss) wird durch eine schlankere, hardwarefreundlichere Parametrisierung ersetzt. Dadurch werden Operationen vermieden, die häufig zu Instabilitäten zwischen verschiedenen Compilern und Laufzeitumgebungen führen. Das Ergebnis ist eine bis zu 43 % schnellere Inferenz auf der CPU sowie eine insgesamt einfachere Nachbearbeitung.
RF-DETR ist ebenfalls NMS-frei, verwendet aber einen anderen Mechanismus als YOLO26. RF-DETR nutzt einen vortrainierten Vision Transformer, DINOv2, als Basis, extrahiert Merkmale mit unterschiedlichen Auflösungen und verarbeitet diese mithilfe eines Decoders, der mit lernbaren Anfragen (abstrakten Repräsentationen von Kandidatenobjekten) arbeitet. Jede Decoderschicht besteht aus Selbstaufmerksamkeit (zur Erfassung von Beziehungen zwischen Anfragen) und deformierbaren Funktionen. Cross-Attention (die sich nur auf eine kleine, gelernte Menge von Abtastpunkten innerhalb der Bildmerkmale konzentriert) und ein Feedforward-Netzwerk, das die Vorhersage verfeinert. Diese deformierbare Aufmerksamkeit, die sich nur auf eine kleine Anzahl gelernter Punkte konzentriert, hält den Rechenaufwand geringer als die standardmäßige Transformer-Cross-Attention und liefert gleichzeitig einzigartige, mengenbasierte Vorhersagen – genau deshalb wird NMS von vornherein überflüssig.
Was generationsübergreifende Vergleiche tatsächlich zeigen: YOLOv8/v11/v26
Es sind auch Daten aufgetaucht, die die Annahme widerlegen, dass „neuere Generation = durchgehend höhere Genauigkeit“ bedeutet. Ein Benchmark vom August 2026, der drei YOLO-Generationen und fünf Modellgrößen umfasste und auf die Erkennung feinkörniger Strukturen (Äste, Früchte, andere kleine Objekte) in Obstplantagen und die Instanzsegmentierung abzielte, ergab, dass der höchste mAP@50:95-Wert gar nicht von YOLOv26, sondern von YOLOv11s-960 (0,402 Masken-mAP@50:95, 0,426) erzielt wurde. YOLOv26s-960 erreichte unterdessen mit nur 10,37 Millionen Parametern eine vergleichbare Genauigkeit (mAP@50:95). Daraus ergibt sich: Genauigkeitsgewinne sind nicht mit jeder neuen Generation gleichmäßig zu erwarten, die Parametereffizienz – also die Erreichung gleicher Genauigkeit mit deutlich weniger Rechenaufwand – verbessert sich jedoch stetig.
Die Erkennung kleiner Objekte bleibt weiterhin eine ungelöste Herausforderung. Eine im August 2026 durchgeführte Evaluierung, in der sechs YOLO-Varianten und zwei DETR-Varianten zur Erkennung militärischer Fahrzeuge verglichen wurden, ergab ein einheitliches Bild: Größere Modelle schneiden besser ab, DETR-basierte Ansätze sind vielversprechend, und die Feinabstimmung verbessert die Leistung im Luft-Boden-Einsatz (A2G) – doch alle Modelle haben nach wie vor Schwierigkeiten, kleine Objekte im A2G-Szenario zu erkennen. Weder das NMS-freie Design von YOLO26 noch die hohe mAP von RF-DETR haben dieses Problem der Erkennung „kleiner, entfernter Objekte“ vollständig gelöst.
Fortschritte bei der Open-Vocabulary-Erkennung: Konkrete AP-Zahlen
Die Generation von Open-Vocabulary-Detektoren folgt YOLO-World/Grounding DINO konnte seine Genauigkeit bis 2026 kontinuierlich verbessern. FlowOVD (Mai 2026), das einen generativen, korrigierten Datenfluss nutzt, um textunabhängige Anfragen in textbasierte umzuwandeln, erreicht 49,5 AP auf COCO und 31,5 AP auf LVIS – Verbesserungen von +1,2 AP (relativ +2,5 %) bzw. +4,1 AP (relativ +15,0 %) gegenüber Grounding DINO. OPUS, veröffentlicht im August 2026, verarbeitet verschiedene Eingabeaufforderungstypen – Text, visuelle (interaktive/generische) und gemischte – in einem einheitlichen Framework. Trotz eines einfacheren Designs, das aufwändige multimodale Fusion vermeidet, erzielt es Spitzenwerte von 68,1/69,2/54,7 AP auf den Benchmarks COCO, LVIS-minival und ODinW35. Die Erkennung offener Vokabulare ist nicht mehr nur ein qualitativer Vorteil – die Fähigkeit, unbekannte Wörter zu verarbeiten, ist ein weiterer wichtiger Aspekt. Kategorien – sie werden zunehmend auch quantitativ konkurrenzfähig mit Detektoren mit festen Klassen.
Die Landschaft im Jahr 2026
Die Objekterkennung basiert heute im Wesentlichen auf zwei Säulen: einstufige, NMS-freie Transformatorarchitekturen und die YOLO-Familie mit ihrem etablierten Ökosystem. Der Transformatorbereich entwickelt sich rasant, doch die YOLO-Familie bleibt aufgrund ihrer bewährten Produktionsergebnisse und der umfassenden Tool-Vielfalt das Rückgrat von Echtzeit-Produktionsumgebungen. Aufgeschlüsselt nach Anwendungsfall:
- Höchste Genauigkeit: RF-DETR
- Bewährte Ergebnisse und Ökosystem sind entscheidend: YOLO26/YOLOv12
- Höchste Geschwindigkeit: RTMDet
- Verarbeitung unbekannter Kategorien: YOLO-World / Grounding DINO
Das ist die aktuelle Arbeitsteilung.
Kann mAP allein einen Echtzeitdetektor auswählen?
Vergleichen Latenz und Qualität bei gleicher Auflösung, Daten und Hardware. Die Inferenzzeit ohne Vor- und Nachbearbeitung entspricht nicht der End-to-End-Latenz.
Referenzen
- Demystifying RF-DETR (Towards AI)
- RT-DETRv2 Paper (arXiv)
- DETRs Beat YOLOs on Real-time Object Detection Paper (arXiv)
-
YOLO26: An Analysis of NMS-Free End to End Framework for Real-Time Object Detection (arXiv)
- RF-DETR GitHub (roboflow)
- Generationenübergreifende Optimierung von YOLOv26, YOLOv11 und YOLOv8 (arXiv)
- Vergleichende Studie von Out-of-the-Box-Technologien zur automatischen Zielerkennung (arXiv)
- FlowOVD (arXiv)
- OPUS (arXiv)
Kommentare
Bitte zuerst anmelden.
Noch keine Einträge.