Contents — find the section you need
A detecção de objetos é a tarefa de estimar simultaneamente a localização (caixa delimitadora) e a categoria de um objeto a partir de uma imagem. A família YOLO tem sido, por muito tempo, a escolha preferida para uso em produção, mas, até 2026, os detectores baseados em transformadores atingiram um ponto em que representam uma ameaça real a essa posição.
Este artigo se concentra nas tendências de pesquisa e apresenta brevemente os conceitos essenciais.
 Detecção de Objetos
Não foi possível encontrar um logotipo oficial livre de direitos autorais para YOLO/Ultralytics, então um ícone simples representando a detecção de caixas delimitadoras foi criado em seu lugar.
A Divisão do Design do Detector em Resumo
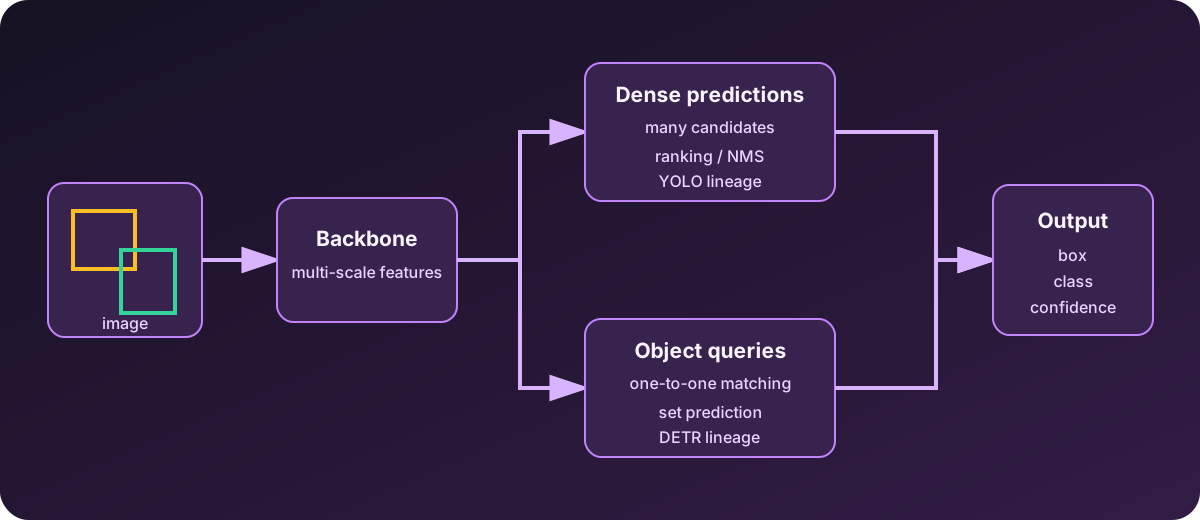
Diagrama: Duskcoil. Ele destaca a divisão de design representativa entre previsão densa e previsão de conjunto.
Todo detector de objetos transforma uma imagem de entrada em características e, por fim, retorna localização, categoria e confiança. A principal distinção é se ele cria muitos candidatos e remove duplicatas posteriormente ou compara consultas de objetos aprendidas uma a uma com a verdade fundamental e prevê diretamente um conjunto com baixa duplicação. Essa escolha se reflete na necessidade de NMS (Supressão Não Máxima), no objetivo do treinamento, na velocidade e no comportamento em cenas congestionadas.
O Posicionamento da Família YOLO: Sem NMS
A NMS tradicional é uma etapa de pós-processamento que reduz várias caixas candidatas produzidas para o mesmo objeto a uma detecção final, descartando qualquer caixa cuja sobreposição (IoU: Interseção sobre União, a área de sobreposição entre duas caixas dividida pela sua área de união) com outra exceda um limite.
Esse pós-processamento é executado como uma etapa independente fora da rede e traz consigo desvantagens: ajuste empírico de onde definir o limite e uma tendência a descartar erroneamente objetos genuinamente distintos e próximos uns dos outros. O YOLO26, a geração mais recente do YOLO, adota uma arquitetura sem NMS que não precisa mais de supressão não máxima, a etapa de pós-processamento. Isso já é padrão há anos. O NMS tende a ser um gargalo tanto para o custo computacional quanto para a latência no pipeline de inferência, e sua remoção visa melhorar a velocidade de inferência e a simplicidade de implementação. No quesito taxa de transferência pura, a extremidade leve e de alta velocidade do espectro também continua bem abastecida — o RTMDet, por exemplo, ultrapassa 300 FPS.
A Ascensão dos Detectores Baseados em Transformers: RF-DETR e RT-DETRv2
Outra tendência importante é a linhagem DETR (DEtection TRansformer) atingindo a maturidade prática. O RT-DETR/RT-DETRv2 combina uma CNN com um transformer e, assim como a família YOLO, são projetados para gerar detecções finais diretamente, sem NMS.
O grande evento de 2026 foi a chegada do RF-DETR, apresentado na ICLR 2026. Ele é descrito como o primeiro modelo em tempo real a ultrapassar 60 mAP no benchmark COCO e também lidera o RF100-VL. O YOLO-World é um benchmark que avalia a transferência de domínio. Sua licença é Apache 2.0 — permissiva para uso comercial — em contraste com o YOLO26/YOLOv12, licenciado sob AGPL.
Detecção de Vocabulário Aberto via Prompts de Texto
Outra tendência importante é a "detecção de vocabulário aberto" — a detecção de categorias para as quais o modelo nunca foi treinado. O YOLO-World e o Grounding DINO conseguem detectar uma categoria arbitrária a partir de um único prompt de texto, sem a necessidade de dados de treinamento adicionais. Trata-se de uma mudança de mentalidade, afastando-se da detecção vinculada a uma lista fixa de classes, e se encaixa bem em casos de uso onde as categorias do mundo real não podem ser totalmente enumeradas antecipadamente — reconhecimento de objetos para um robô de uso geral, por exemplo.
O Mecanismo Técnico por Trás da Eliminação do NMS
A mudança do YOLO26 para a detecção sem NMS não se resume a pular uma etapa de pós-processamento — ela decorre da mudança do próprio método de treinamento. O design tradicional do YOLO tolerava múltiplas caixas delimitadoras previstas por objeto durante o treinamento. (atribuição um-para-muitos), com a suposição de que o NMS eliminaria os duplicados após a inferência. O YOLO26 redesenha a camada de predição, mudando para atribuição um-para-um, onde uma única caixa delimitadora definitiva por instância de objeto é gerada desde o treinamento. Ele também substitui a abordagem baseada em distribuição usada para regressão de caixa delimitadora (Distribution Focal Loss) por uma parametrização mais leve e amigável ao hardware, eliminando operações que tendem a ser instáveis entre compiladores e ambientes de execução. O resultado é uma inferência até 43% mais rápida na CPU, juntamente com uma implementação de pós-processamento mais simples no geral.
O RF-DETR também é livre de NMS, mas por um mecanismo diferente do YOLO26. O RF-DETR usa um Vision Transformer pré-treinado, o DINOv2, como base, extrai características multirresolução e as passa por um decodificador que trabalha com consultas treináveis (representações abstratas que substituem os objetos candidatos). Cada camada do decodificador consiste em autoatenção (capturando relações entre as consultas), deformável A atenção cruzada (que considera apenas um pequeno conjunto aprendido de pontos de amostragem dentro das características da imagem) e uma rede feed-forward refinam a previsão. Essa atenção deformável, que "considera apenas um pequeno número de pontos aprendidos", mantém o custo computacional menor do que a atenção cruzada padrão do Transformer, ao mesmo tempo que produz previsões únicas baseadas em conjuntos — exatamente por isso que o NMS se torna desnecessário.
O que as comparações entre gerações realmente mostram: YOLOv8/v11/v26
Também surgiram dados que contestam a suposição de que "geração mais recente = precisão uniformemente maior". Um benchmark de agosto de 2026, abrangendo três gerações do YOLO e cinco escalas de modelo — com foco em estruturas de grãos finos (galhos, frutas, outros objetos pequenos) na detecção de pomares e segmentação de instâncias — descobriu que o maior mAP@50:95 não foi obtido pelo YOLOv26, mas sim pelo YOLOv11s-960 (mAP@50:95 de 0,402). 0,426 box mAP@50:95). O YOLOv26s-960, por sua vez, alcançou uma precisão aproximadamente comparável com apenas 10,37 milhões de parâmetros. Assim, o quadro que emerge é o seguinte: os ganhos brutos de precisão não chegam uniformemente a cada nova geração, mas a eficiência de parâmetros — igualando a precisão com muito menos poder computacional — está avançando constantemente.
A detecção de objetos pequenos também permanece um desafio real e não resolvido. Uma avaliação de agosto de 2026, comparando seis variantes do YOLO e duas variantes do DETR na detecção de veículos militares, encontrou um padrão consistente: modelos maiores têm melhor desempenho, abordagens baseadas em DETR mostram-se promissoras e o ajuste fino melhora o desempenho ar-solo (A2G) — mas todos os modelos ainda têm dificuldades para detectar objetos pequenos no cenário A2G. Nem o design sem NMS do YOLO26 nem o alto mAP do RF-DETR resolveram completamente esse problema de "objetos pequenos e distantes".
Progresso da Detecção de Vocabulário Aberto: Números Concretos de AP
A geração de Os detectores de vocabulário aberto que seguem o YOLO-World/Grounding DINO também apresentaram ganhos constantes de precisão até 2026. O FlowOVD (maio de 2026), que usa um fluxo retificado generativo para transformar consultas agnósticas ao texto em consultas guiadas por texto, apresenta AP de 49,5 no COCO e 31,5 no LVIS — melhorias de +1,2 AP (um aumento relativo de 2,5%) e +4,1 AP (um aumento relativo de 15,0%) em relação ao Grounding DINO, respectivamente. O OPUS, publicado em agosto de 2026, lida com múltiplos tipos de prompts — texto, visual (interativo/genérico) e misto — dentro de uma única estrutura unificada e, apesar de um design mais simples que evita a fusão multimodal complexa, apresenta números de última geração de 68,1/69,2/54,7 AP nos benchmarks COCO, LVIS-minival e ODinW35. A detecção de vocabulário aberto não é mais apenas uma vitória qualitativa. — a capacidade de lidar com categorias desconhecidas — está começando a se tornar quantitativamente competitiva também com detectores de classe fixa.
O Panorama em 2026
A detecção de objetos hoje é amplamente definida por dois eixos: arquiteturas de transformadores de estágio único e sem NMS (Sistema de Gerenciamento de Rede) e a família YOLO com seu ecossistema estabelecido. O lado dos transformadores está se desenvolvendo rapidamente, mas a família YOLO continua sendo a espinha dorsal dos ambientes de produção em tempo real, graças ao seu histórico de produção e à abrangência de suas ferramentas. Detalhado por caso de uso:
- Precisão acima de tudo: RF-DETR
- Histórico e ecossistema são o que mais importam: YOLO26/YOLOv12
- Velocidade pura: RTMDet
- Necessidade de lidar com categorias desconhecidas: YOLO-World / Grounding DINO
Essa é a divisão de trabalho atual.
O mAP sozinho consegue selecionar um detector em tempo real?
Compare a latência e a qualidade com resolução, dados e hardware equivalentes. O tempo de inferência sem pré e pós-processamento não é a latência de ponta a ponta.
Referências
- Desmistificando o RF-DETR (Rumo à IA)
- Artigo sobre RT-DETRv2 (arXiv)
- DETRs superam YOLOs em detecção de objetos em tempo real (arXiv)
- Melhores modelos de detecção de objetos de 2026 (Blog Roboflow)
- YOLO26: Uma análise de uma estrutura de ponta a ponta sem NMS para detecção de objetos em tempo real (arXiv)
- Artigo RF-DETR (ICLR 2026, arXiv)
- RF-DETR GitHub (roboflow)
- Otimização de Geração Cruzada de YOLOv26, YOLOv11 e YOLOv8 (arXiv)
- Estudo Comparativo de Tecnologia Pronta para Uso para Detecção e Reconhecimento Automático de Alvos (arXiv)
- Artigo FlowOVD (arXiv)
- Artigo OPUS (arXiv)
Comentários
Entre na sua conta para continuar.
Ainda não há dados.