Contents — find the section you need
A segmentação semântica é a tarefa de atribuir um rótulo de categoria a cada pixel de uma imagem. Enquanto a detecção de objetos é uma tarefa de localização grosseira, em nível de caixa delimitadora, a segmentação realiza uma divisão de regiões refinada, em nível de pixel. Em 2026, duas correntes de pesquisa coexistiam: o refinamento por meio de métodos baseados em transformadores e uma mudança em direção a modelos fundamentais que podem extrair um alvo arbitrário a partir de um estímulo.
Este artigo se concentra nas tendências de pesquisa e apresenta brevemente os conceitos essenciais.
 Meta AI
Imagem: Logotipo da Meta AI, Wikimedia Commons
.svg)
Dois Problemas de Segmentação em Resumo
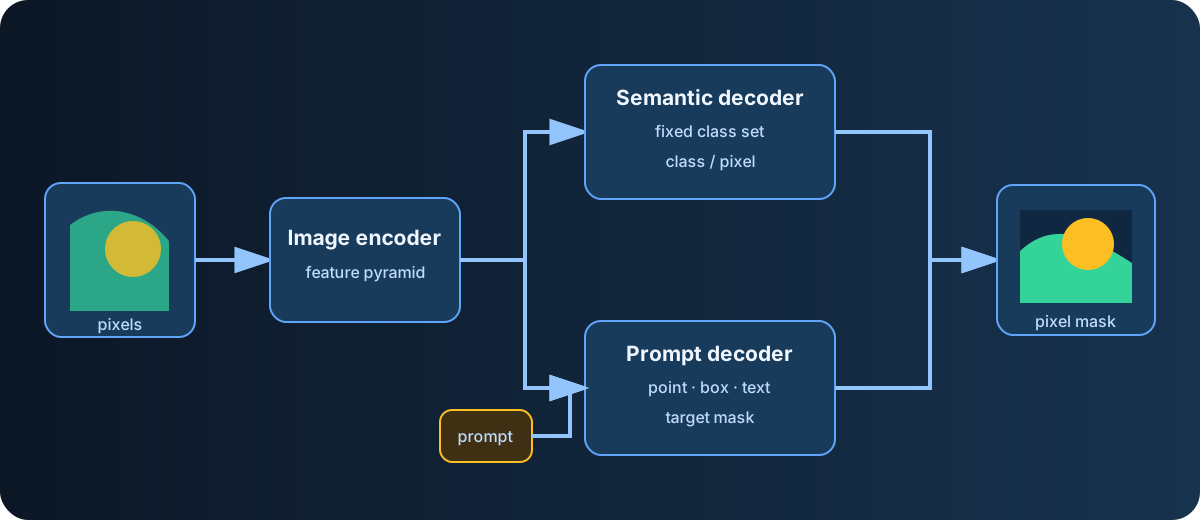
Diagrama: Duskcoil. Simplifica a distinção entre rotulagem de classe fixa e extração condicionada por prompt.
A mesma máscara em nível de pixel pode responder a duas perguntas diferentes. A segmentação semântica atribui cada pixel a uma classe fixa durante o treinamento. A segmentação condicionada por prompt é condicionada por prompt. A segmentação extrai o alvo especificado por um ponto, caixa ou texto. Essa distinção mantém a linhagem que compete com base no mIoU de classe fixa separada da linhagem "Segment Anything" que prioriza a transferência flexível para novos alvos.
Métrica de Avaliação: mIoU
A precisão da segmentação é convencionalmente avaliada com mIoU (interseção média sobre união), que estende o IoU da detecção de objetos para uma base por classe. Para uma determinada classe c, o IoU é calculado a partir da sobreposição entre a região real G_c e a região prevista P_c, e então calculado a média em todas as classes C.
Ao treinar isso como um problema de classificação por pixel, a função de perda comumente usada é a entropia cruzada por pixel, calculada a média e somada em todos os pixels.
Aqui, y_{n,c} é o rótulo de verdade fundamental — 1 se o pixel n realmente pertence à classe c, 0 caso contrário — e \hat{y}_{n,c} é a probabilidade prevista pelo modelo de que o pixel n pertença à classe c.
O Ponto Final dos Métodos Baseados em Transformers: SegFormer e Mask2Former
O que se tornou comum em substituição aos métodos baseados em CNN (FCN, U-Net e similares) foram os métodos construídos em torno de um Transformer. O SegFormer combina a estrutura hierárquica de uma CNN com a capacidade de modelagem global de um Transformer, usando um codificador Transformer hierárquico emparelhado com um decodificador MLP leve. É considerado um método confiável e de alta precisão em ambos os casos. Imagens olho de peixe e padrão.
O Mask2Former vai um passo além, formulando a segmentação como um problema de classificação de máscaras baseado em consultas. Ele combina um decodificador de pixels que preserva informações espaciais de alta resolução com um decodificador Transformer que aprende um número fixo de consultas, onde cada consulta se concentra em uma região relevante para prever uma máscara e sua categoria. Construído sobre uma arquitetura Swin-L, ele alcança desempenho de última geração em todos os três tipos de segmentação — panóptica, de instância e semântica — e a introdução da atenção mascarada faz com que ele convirja 8 vezes mais rápido que o Mask R-CNN.
Por que a "Atenção Mascarada" do Mask2Former é Rápida
O núcleo técnico por trás da combinação de convergência rápida com alta precisão do Mask2Former é a atenção mascarada: enquanto um decodificador Transformer padrão calcula a atenção cruzada em toda a imagem, o Mask2Former restringe a atenção de cada consulta apenas à região de primeiro plano da máscara prevista na camada anterior. Em vez de reexaminar toda a imagem a cada vez, Ao restringir a segmentação apenas à "região localmente relevante" implícita na previsão imediatamente anterior, reduz-se o desperdício de computação e, ao mesmo tempo, extrai-se características locais com maior precisão.
A arquitetura geral consiste em um extrator de características principal, um decodificador de pixels que preserva informações espaciais de alta resolução e um decodificador Transformer de 9 camadas (com capacidade para 100 consultas treináveis). Para lidar com objetos pequenos, utiliza-se também uma estratégia multiescala, alimentando a pirâmide de características produzida pelo decodificador de pixels (três níveis de resolução — 1/8, 1/16, 1/32) em camadas sucessivas do decodificador Transformer em um esquema de rodízio. Esse design alcança um desempenho robusto em todos os três tipos de segmentação — panóptica, de instância e semântica — e converge 8 vezes mais rápido que o Mask R-CNN.
A Mudança para a Segmentação Baseada em Prompts: A Linhagem do Segment Anything
Outra tendência importante é a segmentação "baseada em prompts", sem restrições impostas por qualquer lista de categorias fixas predeterminadas. O Segment Anything Model (SAM), lançado pela Meta em Em 2023, o SAM recebeu uma variedade de estímulos como entrada — um ponto, uma caixa delimitadora, uma máscara aproximada — e gerou uma máscara de segmentação de alta qualidade a partir deles. Essa mudança — definir um alvo arbitrário com base em um estímulo, em vez de prever a partir de uma lista de classes fixa — impulsionou significativamente a modelagem fundamental da visão computacional.
Seu sucessor, o SAM 2, substituiu o ViT de escala única pelo Hiera, um Vision Transformer hierárquico multiescala pré-treinado por meio de autoencoder mascarado, e adicionou suporte para segmentação de vídeo. Ele opera a 130 FPS em 37 conjuntos de dados zero-shot, mantendo alta precisão (mIoU 58,9/81,7).
Em 2026, a Meta lançou o SAM 3, capaz de detectar, segmentar e rastrear um "conceito visual" especificado por um estímulo de texto ou uma imagem de exemplo. É o próximo passo na mesma direção — segmentação de propósito geral baseada em estímulos — levado um nível adiante, até a especificação de um conceito em texto.
SAM 3 Alcançando Implantação no Mundo Real: Resultados de Competições de Segmentação de Vídeo
Desde o início de 2026, pesquisas aplicadas baseadas no SAM 3 têm surgido rapidamente em diversas áreas. A característica definidora do SAM 3 — especificar um conceito por meio de um prompt de texto — tem sido repetidamente adaptada para domínios especializados: vigilância marítima (MariSat, um conjunto de dados marítimos que incorpora o SAM 3 em um pipeline de anotação semiautomático) e inspeção de torres de comunicação (extração de componentes de imagens aéreas complexas de drones), entre outros.
Os resultados da trilha MOSEv2 do 8º Desafio LSVOS, realizado na ECCV 2026, oferecem uma medida útil do progresso da segmentação de vídeo. O SAM3Dual, um método sem treinamento baseado no SAM 3 que combina dois ramos de memória temporal — um para frames recentes e outro para contexto histórico — ficou em terceiro lugar com uma pontuação J&F de 64,37. O Competitive Memory Readout, que ficou em segundo lugar na mesma competição, Incorpora explicitamente evidências sobre objetos "concorrentes" da mesma classe ao recuperar informações do alvo da memória, atingindo uma pontuação de 66,20 na métrica principal. Ambos os resultados ressaltam que preservar a identidade do objeto ao longo do tempo em vídeo (continuar rastreando o mesmo objeto como o mesmo alvo durante toda a sequência) permanece o principal desafio que determina o desempenho real dos modelos da família SAM.
Exemplos Concretos de Otimização e Adaptação com Poucos Exemplos
Os esforços para aumentar ainda mais a eficiência da família SegFormer/Mask2Former também continuam. O DPNeXt (julho de 2026), um decodificador leve para predição densa baseada em ViT (segmentação mais trabalho multitarefa, como estimativa de profundidade), reduz os parâmetros treináveis em 78,6% em comparação com um DPT (Dense Prediction Transformer) padrão, mantendo um desempenho de última geração nos benchmarks Cityscapes e NYUv2. O TraceCLIP (julho de 2026), um método totalmente livre de treinamento que recupera informações semânticas locais por meio de Isolando a contribuição individual de cada patch para a atenção do token CLS do CLIP, o método reporta melhorias de mIoU de 1,3 a 4,5 pontos em relação aos métodos anteriores mais robustos em oito benchmarks de segmentação semântica zero-shot.
Um exemplo concreto de adaptação com poucos exemplos é o HASTE (julho de 2026), uma plataforma para avaliação rápida de danos em edifícios após desastres, a partir de imagens de satélite. Ao utilizar embeddings de modelos de base, o HASTE atinge a precisão de uma linha de base ResNet-50 totalmente supervisionada (treinada com rótulos para todo o conjunto de dados) usando apenas um vigésimo do número de rótulos, e já apoiou mais de 30 respostas a desastres reais — terremotos, furacões, incêndios florestais — desde 2023. É uma concretização do que a segmentação busca na era dos modelos de base: precisão de nível de produção a uma fração do custo de rotulagem.
Quando usar cada método atual
A divisão prática neste momento é: para uma tarefa fixa onde as categorias já são conhecidas antecipadamente (carros, pedestres, placas em uma cena de trânsito, por exemplo), os métodos baseados em transformadores da família SegFormer/Mask2Former têm vantagem tanto em precisão quanto em eficiência; para situações que exigem o tratamento de alvos desconhecidos ou casos com poucos exemplos, os modelos de base baseados em prompts da família SAM mostram sua força — e essa divisão de trabalho continua se consolidando.
Um mIoU geral alto garante uma boa segmentação de pequenos obstáculos?
As médias podem ocultar fraquezas específicas de classe ou tamanho. Inspecione classes relevantes, limites, falsos positivos e regiões não detectadas.
Referências
- Artigo de Avaliação Comparativa do SegFormer/Mask2Former (MDPI)
- [Do SAM ao SAM 2: Explorando Melhorias no Modelo Segment Anything da Meta] (arXiv)](https://arxiv.org/pdf/2408.06305)
- Documentação Oficial do SAM 3 (Ultralytics)
- Um Novo Benchmark para Segmentação Semântica com Poucos Exemplos na Era dos Modelos Fundamentais (arXiv)
- Artigo SAM3Dual (MOSEv2, Desafio LSVOS) (arXiv)
- Leitura Competitiva de Memória para Segmentação Robusta de Objetos em Vídeo (arXiv)
- Artigo DPNeXt (arXiv)
- Artigo TraceCLIP (arXiv)
- Artigo HASTE (arXiv)
Comentários
Entre na sua conta para continuar.
Ainda não há dados.