Contents — find the section you need
Executar um modelo de linguagem complexo em sua própria máquina, sem a necessidade de uma API na nuvem — o chamado "Modelo de Linguagem Local" — tornou-se viável nos últimos anos. É o resultado da convergência de duas tendências: modelos openweight aprimorados e a redução de modelos por meio de técnicas de quantização.
 Ollama
 Hugging Face
Imagem: Ollama / Hugging Face logos, Wikimedia Commons


Inferência Local em Resumo
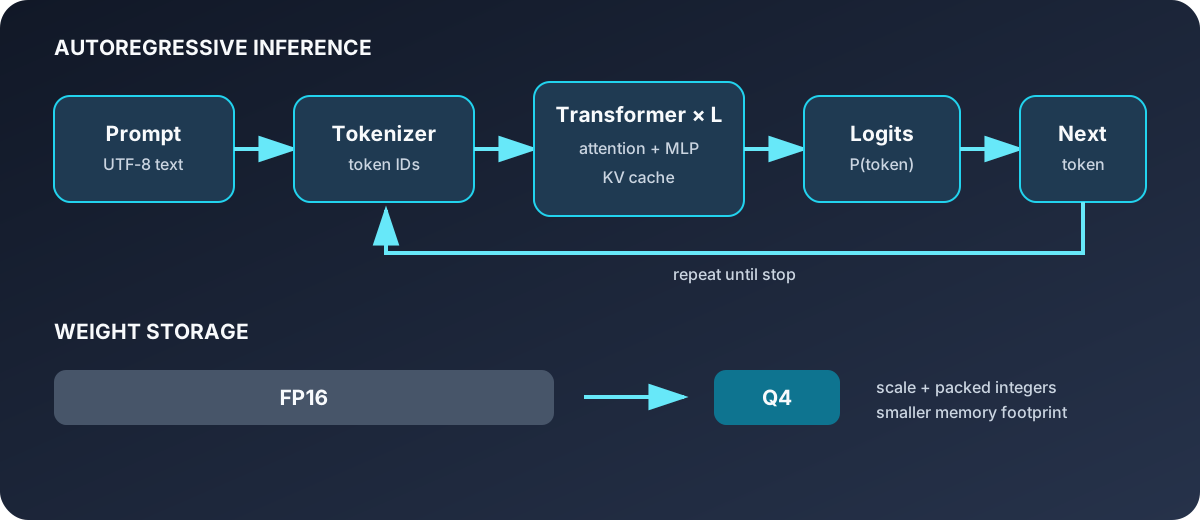
Diagrama: Duskcoil. O caminho de geração e o papel da quantização de pesos são mostrados separadamente.
A chave para entender um LLM local é separar o loop de inferência repetido da memória necessária para armazenar o modelo. O texto se torna IDs de token; o transformador calcula uma distribuição para o próximo token; e o token selecionado retorna à entrada. A quantização, por sua vez, altera principalmente a forma como os pesos são armazenados e calculados, de modo que um modelo caiba em RAM ou VRAM limitadas. Uma comparação útil de implantação, portanto, considera não apenas o nome do modelo, mas também seu formato de peso, o cache KV que cresce com o comprimento do contexto e os backends de CPU/GPU disponíveis.
A Ascensão Rápida dos Modelos de Peso Aberto
O cenário de pesos abertos em 2026 continua se reorganizando em uma escala de tempo de meses. O DeepSeek impulsiona a alta eficiência em suas variantes Flash e Pro; O Qwen ascendeu de "um concorrente sério" a ser classificado como "de primeira linha em raciocínio de nível de pós-graduação", graças à ampla gama de opções de hardware e tamanho de modelo. O Llama 4 da Meta oferece uma janela de contexto de até 10 milhões de tokens para um modelo aberto. Mais recentemente, o GLM-5.2 da Z.ai deu um grande salto no desempenho de agentes de codificação e foi integrado a frameworks de agentes poucos dias após o lançamento, e o Kimi K2.7 Code HighSpeed alega um aumento de velocidade de 6x no raciocínio de codificação multimodal — o ritmo de mudança é extremamente rápido.
Os resultados de benchmarks também marcam uma mudança importante. Em conjuntos de avaliação de codificação no estilo SWE-bench, a diferença entre os principais modelos open weight e os principais modelos comerciais diminuiu para pontos percentuais de um dígito, e alguns argumentam que essa diferença foi efetivamente eliminada para o trabalho de engenharia do dia a dia.
A Base: O Mecanismo de Atenção
Todos os principais modelos de linguagem atuais — incluindo aqueles executados pelo Ollama — são construídos sobre a arquitetura Transformer, e seu núcleo é a autoatenção. Dadas as matrizes de consulta Q, chave K e valor V derivadas da sequência de entrada, ele calcula a atenção por produto escalar escalonado da seguinte forma:
QK^\top representa o quão relacionados (ou semelhantes) os tokens são entre si, e dividir por \sqrt{d_k} (a raiz quadrada da dimensão da chave) impede que os produtos escalares cresçam tanto a ponto de o gradiente da função softmax desaparecer. Repetir essa operação em todos os parâmetros e camadas de um modelo é o que a inferência de transformadores realmente faz — e o quanto a maior parte desses parâmetros (as matrizes de pesos) pode ser reduzida é exatamente o papel da quantização, que será abordado a seguir.
A Forma Básica da Quantização Linear
A ideia subjacente ao GGUF, AWQ e GPTQ é a quantização linear: converter um peso de ponto flutuante x em um inteiro de bits menos significativos q.
s é a escala (a largura em números reais por passo) e z é o ponto zero (onde, na representação inteira, o zero real de fato se encontra) — ambos parâmetros de calibração. A forma como cada método define esses dois valores, e em qual granularidade (modelo inteiro, por camada, por peso), é o que determina as diferenças de desempenho entre eles.
A Maturidade da Quantização: GGUF, AWQ, GPTQ
Além de um melhor desempenho do modelo, a quantização — redução do tamanho do modelo — tornou-se essencial. Métodos de quantização como GGUF, AWQ e GPTQ conseguiram reduzir o tamanho do modelo em aproximadamente 70%, mantendo a perda de precisão abaixo de 2%, o que permite que um modelo com 32 bilhões de classes de parâmetros agora caiba em 16 GB de memória. A inferência local em hardware de consumo típico agora atinge 70–85% da qualidade de um modelo de ponta, sem custo adicional por requisição.
Os três formatos têm seus próprios pontos fortes. GGUF (anteriormente GGML) é o formato nativo para llama.cpp e seu ecossistema (Ollama, LM Studio e similares), com excelente desempenho em inferência híbrida CPU+GPU. GPTQ se destaca pela velocidade bruta de inferência em configurações somente com GPU, e AWQ é geralmente considerado a melhor opção em termos de precisão por tamanho com quantização de 4 bits. Para uso geral em desenvolvimento local, GGUF via Ollama é frequentemente recomendado como a escolha padrão.
As Diferenças Técnicas entre os Três Métodos de Quantização
GGUF, AWQ e GPTQ são todos métodos de quantização que reduzem os pesos do modelo de ponto flutuante de 16/32 bits para cerca de 4 bits, mas chegam a esse resultado por meios tecnicamente diferentes.
GPTQ trata a quantização como um problema de otimização. O método utiliza informações de segunda ordem da função de perda (a Hessiana) para determinar quais erros de arredondamento dos pesos são mais relevantes para a saída. Em seguida, à medida que cada peso é quantizado, o erro resultante é distribuído como compensação entre os pesos ainda não quantizados na mesma linha. É um método focado no desempenho de inferência em GPUs, e a quantização de um modelo com 7 bilhões de classes de parâmetros leva aproximadamente de 2 a 4 horas em uma única GPU A100.
O AWQ, por outro lado, não se concentra na etapa de quantização em si, mas em descobrir "quais pesos realmente importam". Ele executa uma fase de calibração que observa as ativações reais do modelo, identifica os pesos "salientes" que afetam fortemente a qualidade da saída e quantiza agressivamente todos os outros, mantendo esses pesos com alta precisão. O AWQ requer menos amostras de calibração do que o GPTQ (aproximadamente 128 a 512, contra mais de 2.048 para o GPTQ), o que o torna substancialmente mais rápido — cerca de 10 a 30 minutos para um modelo de 7 bits.
O GGUF (formato nativo do llama.cpp) utiliza um esquema chamado "K-quants", atribuindo uma profundidade de bits diferente para cada camada — 6 bits para uma camada de alta importância, como atenção, 4 bits para uma camada de feedforward e assim por diante — alcançando maior qualidade por bit do que a quantização uniforme ingênua de 4 bits. Uma configuração representativa, Q4_K_M, supostamente retém cerca de 92% da qualidade do modelo original.
Essas diferenças técnicas se relacionam diretamente com o caso de uso mais adequado para cada método. AWQ para inferência de alta velocidade somente em GPU; GPTQ quando um ecossistema de GPU maduro e uma grande biblioteca de modelos pré-quantizados são mais importantes; GGUF (via Ollama, etc.) quando a facilidade de uso em um ambiente híbrido CPU/GPU é a prioridade.
llama.cpp: Como funciona o mecanismo por trás da inferência local
Por trás de muitos ambientes de execução LLM locais, incluindo o Ollama, está o llama.cpp — um mecanismo de inferência escrito em C/C++ — e o GGML, a biblioteca de tensores subjacente. O GGML é uma biblioteca de computação tensorial leve e com baixa dependência, aproximadamente análoga ao PyTorch ou TensorFlow, que representa toda a computação de um modelo como um "grafo de computação". Alguns tensores contêm dados reais (como pesos), enquanto outros representam apenas o resultado de uma operação entre outros tensores, não tendo nenhum valor até que a computação seja de fato executada. Este grafo computacional pode ser executado diretamente na CPU ou traduzido em instruções para um acelerador — CUDA para GPUs NVIDIA, Metal para hardware Apple — e essa portabilidade, que permite executar o mesmo arquivo de modelo em uma ampla gama de configurações de hardware, é a base técnica que sustenta a popularidade do formato GGUF.
Os Números por Trás do Crescimento
A rapidez com que isso se espalhou se reflete em números concretos. O número de downloads mensais do Ollama cresceu de 100.000 no primeiro trimestre de 2023 para 52 milhões no primeiro trimestre de 2026 — um aumento de 520 vezes em três anos. O número de modelos formatados em GGUF no Hugging Face, formatados para inferência local, cresceu de 200 para 135.000 no mesmo período. O llama.cpp, projeto que sustenta tudo isso, ultrapassou 73.000 estrelas no GitHub.
O Panorama de Lançamento de Modelos no Final de 2026
Acompanhando o blog oficial da Ollama, um grande lançamento sucedeu o outro apenas no segundo semestre de 2026. Em 10 de agosto, a Meta Superintelligence Labs lançou seu primeiro modelo aberto, um modelo multimodal de 30 bilhões de parâmetros chamado "Muse Glimmer", sob a licença Apache 2.0; no dia seguinte, 11 de agosto, a NVIDIA anunciou o "Nemotron 3.5 Lightning", um modelo de 30 bilhões projetado para tarefas de agentes com múltiplas etapas. Em 29 de junho, uma atualização foi lançada, tornando o Gemma 4 até 90% mais rápido no runtime MLX do Apple Silicon, dando continuidade ao esforço em aumentar a velocidade de execução para casos de uso de agentes de codificação. A própria Ollama anunciou uma rodada de financiamento de US$ 88 milhões em 9 de julho e relatou ter alcançado 8,9 milhões de usuários desenvolvedores. O ecossistema de modelos de peso aberto está deixando de ser apenas um "lançamento de modelos" e assumindo a forma de uma infraestrutura comercial genuína.
A Vanguarda da Quantização: NVFP4 como uma Nova Opção
Após GGUF, AWQ e GPTQ, a pesquisa sobre NVFP4 — um formato de ponto flutuante de 4 bits projetado para a arquitetura Blackwell da NVIDIA — cresceu rapidamente até 2026 como um novo formato de quantização. Um estudo de junho de 2026 relatou que um tamanho de bloco de 16 oferece a melhor relação entre precisão e armazenamento, e o ScaleSweep (maio de 2026), que otimiza os valores iniciais de escala de bloco por meio de uma busca por varredura, é um dos vários métodos que agora relatam que mesmo a quantização agressiva pode preservar mais de 93% do desempenho de precisão total. Técnicas de pós-processamento também surgiram, como o H-Scale (agosto de 2026), que refina os valores de escala por grupo usando uma aproximação de segunda ordem baseada na matriz Hessiana, sem sobrecarga adicional de tempo de inferência — um sinal de que a própria pesquisa em quantização está mudando de "quanto os pesos podem ser reduzidos" para "como recuperar a precisão após a redução".
A compressão do cache KV (a região de memória que armazena representações intermediárias de tokens anteriores durante a geração, que aumenta consideravelmente com contextos mais longos) também está progredindo em paralelo. O SemKV (agosto de 2026), que atribui dinamicamente um de dois níveis de precisão por token com base em uma pontuação de importância, relata uma redução de armazenamento de 6,0x, evitando o fenômeno do "abismo de qualidade", onde a qualidade se degrada abruptamente — e 7,9x quando combinado com um quantizador otimizado. Para inferência local em contextos longos, a compressão do cache KV está se tornando um foco prático tão importante quanto a própria quantização de pesos.
Ajustar os pesos na memória é suficiente para inferência?
O cache KV, o espaço de trabalho e a sobrecarga de tempo de execução também consomem memória. Inclua o comprimento do contexto e a concorrência na estimativa.
Referências
- Melhores LLMs Open-Weight 2026: DeepSeek vs Qwen vs Kimi vs GLM vs Llama
- Quantização de LLM Explicada: GGUF vs AWQ vs GPTQ — O Guia Completo de 2026
- IA Local em 2026: Benchmarks do Ollama, Inferência de $0 e o Fim da Precificação por Token
- Guia de Quantização de LLM: Comparação entre GGUF vs AWQ vs GPTQ vs bitsandbytes (2026)
- llama.cpp GitHub (ggml-org)
- Blog oficial do Ollama
- Artigo sobre escala H (arXiv)
- Artigo sobre varredura de escala (arXiv)
- Artigo sobre SemKV (arXiv)
Comentários
Entre na sua conta para continuar.
Ainda não há dados.