Contents — find the section you need
L'esecuzione di un modello linguistico di grandi dimensioni sulla propria macchina, senza l'ausilio di API cloud (il cosiddetto "LLM locale"), è diventata una pratica consolidata negli ultimi anni. È il risultato della convergenza di due tendenze: modelli open-weight più performanti e la riduzione delle dimensioni dei modelli tramite tecniche di quantizzazione.
 Ollama
 Hugging Face
Immagine: Ollama / Hugging Face loghi, Wikimedia Commons


Inferenza locale in sintesi
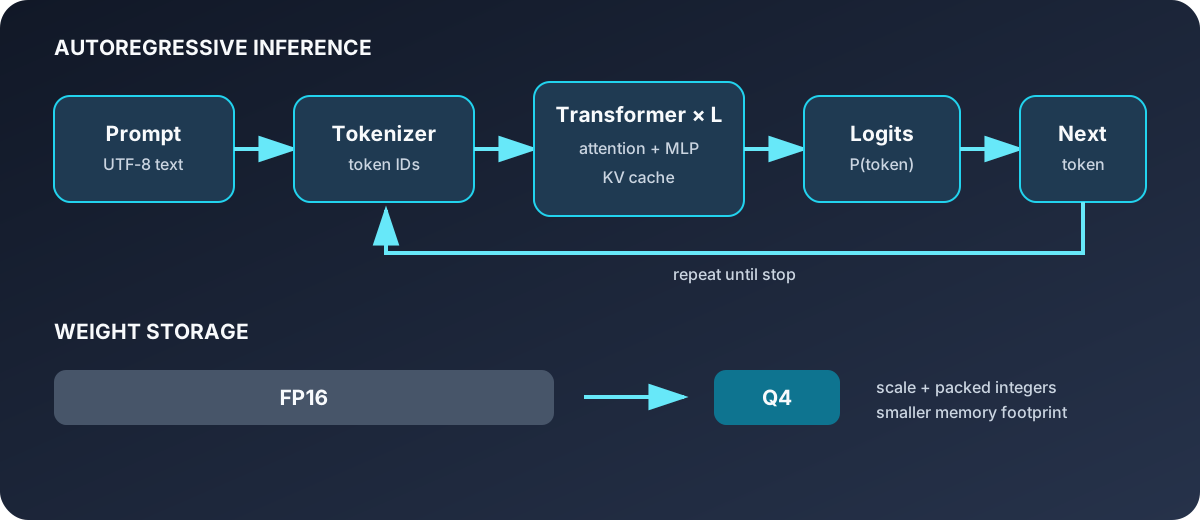
Diagramma: Duskcoil. Il percorso di generazione e il ruolo della quantizzazione dei pesi sono mostrati separatamente.
La chiave per comprendere un LLM locale è separare il ciclo di inferenza ripetuto dalla memoria necessaria per contenere il modello. Il testo diventa ID di token; il trasformatore calcola una distribuzione per il token successivo; e il token selezionato ritorna all'input. La quantizzazione, invece, modifica principalmente il modo in cui i pesi vengono memorizzati e calcolati in modo che un modello si adatti alla RAM o VRAM limitata. Un utile confronto di implementazione considera quindi non solo il nome del modello, ma anche il suo formato dei pesi, la cache KV che cresce con la lunghezza del contesto e i backend CPU/GPU disponibili.
La rapida ascesa dei modelli open-weight
Il panorama open-weight, a partire dal 2026, continua a evolversi su scala di mesi. DeepSeek punta sull'alta efficienza nelle sue varianti Flash e Pro; Qwen è passato dall'essere considerato "un serio contendente" a essere classificato come "di prim'ordine nel ragionamento a livello universitario", grazie all'ampiezza delle sue opzioni hardware e di dimensione del modello. Llama 4 di Meta offre una finestra di contesto lunga fino a 10 milioni di token per un modello aperto. Più recentemente, GLM-5.2 di Z.ai ha fatto un grande salto nelle prestazioni degli agenti di codifica ed è stato integrato nei framework degli agenti a pochi giorni dal rilascio, e Kimi K2.7 Code HighSpeed afferma di avere una velocità sei volte superiore nel ragionamento di codifica multimodale: il ritmo del cambiamento è estremamente rapido.
Anche i risultati dei benchmark segnano un cambiamento importante. Nelle suite di valutazione della codifica in stile SWEbench, il divario tra i migliori modelli open-weight e i principali modelli commerciali si è ridotto a pochi punti percentuali, e alcuni sostengono che tale divario si sia effettivamente azzerato per il lavoro di ingegneria quotidiano.
Le fondamenta: il meccanismo di attenzione
Ogni modello linguistico di grandi dimensioni attualmente in uso, inclusi quelli utilizzati da Ollama, si basa sull'architettura Transformer, il cui nucleo centrale è l'autoattenzione. Date le matrici di query Q, chiave K e valore V derivate dalla sequenza di input, il modello calcola l'attenzione scalata tramite prodotto scalare come segue:
QK^\top rappresenta il grado di correlazione (somiglianza) tra i token, e la divisione per \sqrt{d_k} (la radice quadrata della dimensione della chiave) impedisce che i prodotti scalari crescano a tal punto da annullare il gradiente della funzione softmax. Ripetere questa operazione sull'intero numero di parametri e sulla profondità dei layer di un modello è ciò che effettivamente costituisce l'inferenza del trasformatore, e il ruolo della quantizzazione, di cui parleremo in seguito, è proprio quello di ridurre la maggior parte di questi parametri (le matrici dei pesi).
La forma base della quantizzazione lineare
L'idea alla base di GGUF, AWQ e GPTQ è la quantizzazione lineare: convertire un peso in virgola mobile x in un intero a bit inferiori q.
s rappresenta la scala (l'ampiezza in numeri reali per ogni passo) e z rappresenta il punto zero (dove, nella rappresentazione intera, si trova effettivamente lo zero reale): entrambi parametri di calibrazione, e il modo in cui ciascun metodo determina questi due valori, e a quale granularità (intero modello, per strato, per peso), è ciò che determina le differenze di prestazioni tra di essi.
La maturazione della quantizzazione: GGUF, AWQ, GPTQ
Oltre a migliorare le prestazioni del modello, la quantizzazione, ovvero la riduzione delle dimensioni del modello, è diventata altrettanto essenziale. Metodi di quantizzazione come GGUF, AWQ e GPTQ sono riusciti a ridurre le dimensioni del modello di circa il 70% mantenendo la perdita di accuratezza al di sotto del 2%, ed è così che un modello con 32 miliardi di parametri può ora essere contenuto in 16 GB di memoria. L'inferenza locale su hardware consumer tipico raggiunge ora il 70-85% della qualità di un modello di fascia alta, senza costi aggiuntivi per richiesta.
I tre formati hanno ciascuno i propri punti di forza. GGUF (precedentemente GGML) è il formato nativo per llama.cpp e il suo ecosistema (Ollama, LM Studio e simili), ed è particolarmente efficace nell'inferenza ibrida CPU+GPU. GPTQ eccelle nella velocità di inferenza pura su configurazioni solo GPU, mentre AWQ è generalmente considerato l'opzione migliore in termini di accuratezza per dimensione con quantizzazione a 4 bit. Per l'utilizzo generale nello sviluppo locale, GGUF tramite Ollama è spesso consigliato come scelta predefinita.
Differenze tecniche tra i tre metodi di quantizzazione
GGUF, AWQ e GPTQ sono tutti metodi di quantizzazione che riducono i pesi del modello da virgola mobile a 16/32 bit a circa 4 bit, ma raggiungono questo risultato attraverso mezzi tecnicamente diversi.
GPTQ tratta la quantizzazione come un problema di ottimizzazione. Utilizza approssimativamente informazioni di secondo ordine dalla funzione di perdita (l'Hessiana) per valutare quali errori di arrotondamento dei pesi influiscono maggiormente sull'output, quindi, man mano che ciascun peso viene quantizzato, distribuisce l'errore risultante come compensazione tra i pesi non ancora quantizzati nella stessa riga. È un metodo focalizzato sulle prestazioni di inferenza GPU e la quantizzazione di un modello con 7 miliardi di classi di parametri richiede circa 2-4 ore su una singola GPU A100.
AWQ, al contrario, non si concentra sulla fase di quantizzazione in sé, ma sull'individuazione di "quali pesi sono effettivamente importanti". Esegue una fase di calibrazione che osserva le attivazioni effettive del modello, identifica i pesi "salienti" che influenzano fortemente la qualità dell'output e quantizza in modo aggressivo tutto il resto, mantenendo al contempo un'elevata precisione per tali pesi. Richiede un numero inferiore di campioni di calibrazione rispetto a GPTQ (circa 128-512, contro gli oltre 2.048 necessari per GPTQ), il che lo rende sostanzialmente più veloce: circa 10-30 minuti per un modello a 7 miliardi di bit.
GGUF (il formato nativo di llama.cpp) utilizza uno schema chiamato "K-quants", assegnando una diversa profondità di bit per ogni strato: 6 bit per uno strato di alta importanza come quello dell'attenzione, 4 bit per uno strato feed-forward e così via, ottenendo una qualità per bit superiore rispetto alla semplice quantizzazione uniforme a 4 bit. Un'impostazione rappresentativa, Q4_K_M, si dice che mantenga circa il 92% della qualità del modello originale.
Queste differenze tecniche si traducono direttamente nel caso d'uso più adatto a ciascun metodo. AWQ per l'inferenza ad alta velocità esclusivamente su GPU; GPTQ quando un ecosistema GPU maturo e un'ampia libreria di modelli pre-quantizzati sono più importanti; GGUF (tramite Ollama, ecc.) quando la facilità d'uso in un ambiente ibrido CPU/GPU è la priorità.
llama.cpp: Come funziona il motore alla base dell'inferenza locale
Dietro molti runtime LLM locali, incluso Ollama, si trova llama.cpp, un motore di inferenza scritto in C/C++, e GGML, la libreria tensoriale sottostante. GGML è una libreria di calcolo tensoriale leggera e a bassa dipendenza, grosso modo analoga a PyTorch o TensorFlow, che rappresenta l'intero calcolo di un modello come un "grafo computazionale". Alcuni tensori contengono dati effettivi (come i pesi), mentre altri rappresentano semplicemente il risultato di un'operazione tra altri tensori, senza alcun valore fino a quando il calcolo non viene effettivamente eseguito. Questo grafo computazionale può essere eseguito direttamente sulla CPU o tradotto in istruzioni per un acceleratore — CUDA per le GPU NVIDIA, Metal per l'hardware Apple — e questa portabilità, ovvero la possibilità di eseguire lo stesso file modello su un'ampia gamma di configurazioni hardware, è il fondamento tecnico alla base della popolarità del formato GGUF.
I numeri dietro la crescita
La rapidità con cui si è diffuso si riflette in numeri concreti. Il numero di download mensili di Ollama è passato da 100.000 nel primo trimestre del 2023 a 52 milioni nel primo trimestre del 2026, con un aumento di 520 volte in tre anni. Il numero di modelli in formato GGUF su Hugging Face, formattati per l'inferenza locale, è cresciuto da 200 a 135.000 nello stesso periodo. llama.cpp, il progetto alla base di tutto questo, ha superato le 73.000 stelle su GitHub.
Il panorama dei rilasci di modelli a fine 2026
Seguendo il blog ufficiale di Ollama, un importante rilascio si è susseguito a un altro nella seconda metà del 2026. Il 10 agosto, Meta Superintelligence Labs ha rilasciato il suo primo modello open source, un modello multimodale da 30 miliardi di parametri chiamato "Muse Glimmer", con licenza Apache 2.0; il giorno successivo, l'11 agosto, NVIDIA ha annunciato "Nemotron 3.5 Lightning", un modello da 30 miliardi di parametri progettato per attività agentiche a più fasi. Il 29 giugno, un aggiornamento ha reso Gemma 4 fino al 90% più veloce sul runtime MLX di Apple Silicon, continuando a spingere sulla velocità di esecuzione per i casi d'uso degli agenti di codifica. Ollama stessa ha annunciato un round di finanziamento da 88 milioni di dollari il 9 luglio e ha riferito di aver raggiunto 8,9 milioni di utenti sviluppatori. L'ecosistema dei modelli open source sta andando oltre il semplice "rilascio di modelli" e sta assumendo la forma di una vera e propria infrastruttura commerciale.
La frontiera della quantizzazione: NVFP4 come nuova opzione
Dopo GGUF, AWQ e GPTQ, la ricerca su NVFP4, un formato a virgola mobile a 4 bit progettato per l'architettura Blackwell di NVIDIA, è cresciuta rapidamente nel corso del 2026 come nuovo formato di quantizzazione. Uno studio del giugno 2026 ha riportato che una dimensione del blocco di 16 offre il miglior compromesso tra precisione e spazio di archiviazione, e ScaleSweep (maggio 2026), che ottimizza i valori iniziali di scala del blocco tramite una ricerca a scansione, è uno dei diversi metodi che ora riportano che anche una quantizzazione aggressiva può preservare oltre il 93% delle prestazioni a precisione completa. Sono emerse anche tecniche di post-elaborazione, come H-Scale (agosto 2026), che affina i valori di scala per gruppo utilizzando un'approssimazione basata sull'Hessiana di secondo ordine senza alcun overhead aggiuntivo in fase di inferenza: un segno che la ricerca sulla quantizzazione si sta spostando da "quanto si possono ridurre i pesi" a "come recuperare la precisione dopo averli ridotti". Anche la compressione della cache KV (la regione di memoria che contiene rappresentazioni intermedie dei token precedenti durante la generazione, che si espande con contesti più lunghi) sta progredendo in parallelo. SemKV (agosto 2026), che assegna dinamicamente uno dei due livelli di precisione per token in base a un punteggio di importanza, riporta una riduzione dello spazio di archiviazione di 6,0 volte, evitando il fenomeno del "degrado improvviso della qualità", e di 7,9 volte se abbinato a un quantizzatore ottimizzato. Per l'inferenza locale su contesti lunghi, la compressione della cache KV sta diventando un aspetto pratico tanto quanto la quantizzazione dei pesi stessa.
È sufficiente memorizzare i pesi in memoria per l'inferenza?
Anche la cache KV, lo spazio di lavoro e l'overhead di runtime consumano memoria.
Includi la lunghezza del contesto e la concorrenza nella stima.Riferimenti
- Migliori LLM Open-Weight 2026: DeepSeek vs Qwen vs Kimi vs GLM vs Llama
- Quantizzazione LLM spiegata: GGUF vs AWQ vs GPTQ — La guida completa 2026
- IA locale nel 2026: benchmark Ollama, inferenza a $0 e la fine del prezzo per token
- Guida alla quantizzazione LLM: confronto tra GGUF, AWQ, GPTQ e bitsandbytes (2026)
- llama.cpp GitHub (ggml-org)
- Blog ufficiale di Ollama
- Articolo sulla scala H (arXiv)
- Articolo su ScaleSweep (arXiv)
- Articolo su SemKV (arXiv)
Commenti
Accedi per continuare.
Nessun dato disponibile.