Contents — find the section you need
在过去几年里,无需借助任何云 API,在本地机器上运行大型语言模型(即“本地语言模型”)已成为现实。这得益于两大趋势的融合:一是更优的开放权重模型,二是利用量化技术实现的模型缩减。
 Ollama
 Hugging Face
图片:Ollama / Hugging Face logos, Wikimedia Commons


局部推理概览
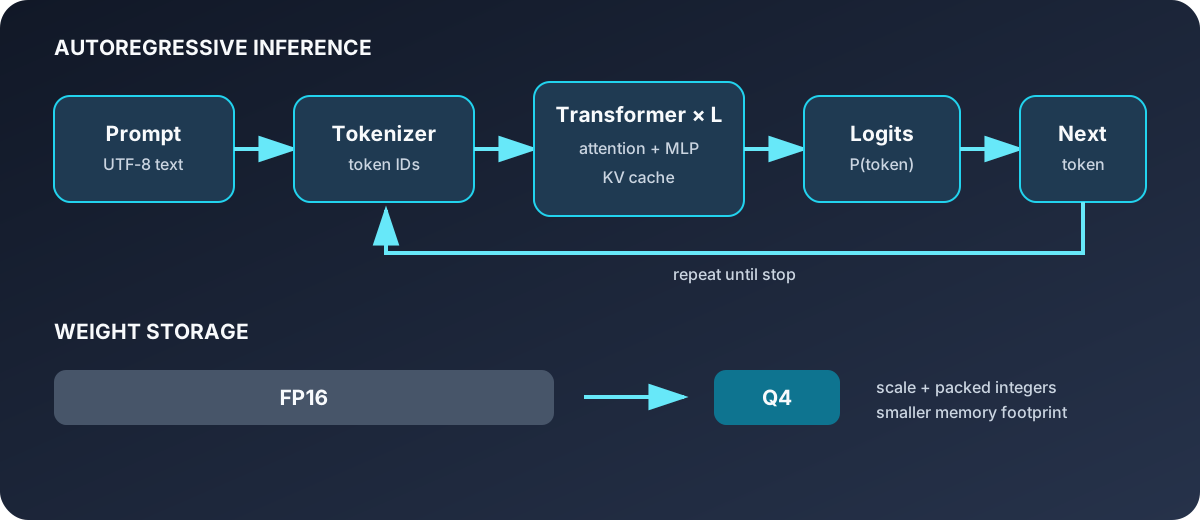
图:Duskcoil。生成路径和权重量化的作用将分别展示。
理解本地 LLM 的关键在于将重复的推理循环与保存模型所需的内存区分开来。文本被转换为词元 ID;Transformer 计算下一个词元的分布;选定的词元返回到输入端。同时,量化主要改变权重的存储和计算方式,使模型能够适应有限的 RAM 或 VRAM。因此,有效的部署比较不仅要考虑模型名称,还要考虑其权重格式、随上下文长度增长的键值缓存以及可用的 CPU/GPU 后端。
开放权重模型的快速崛起
截至 2026 年,开放权重模型的格局将以月为单位不断变化。DeepSeek 在其 Flash 和 Pro 版本中都实现了高效率; Qwen凭借其硬件和模型规模选项的广泛性,已从“强有力的竞争者”跃升为“研究生级别推理能力的顶尖模型”。Meta的Llama 4为开放模型提供了高达1000万个词元的上下文窗口。最近,Z.ai的GLM-5.2在编码代理性能方面取得了显著提升,并在发布后几天内就被集成到代理框架中。Kimi K2.7 Code HighSpeed声称在多模态编码推理方面速度提升了6倍——变革的步伐极其迅猛。
基准测试结果也标志着一个重要的转变。在SWE-bench风格的编码评估套件中,顶级开源模型与领先的商业模型之间的差距已缩小到个位数百分比,一些人认为,对于日常工程工作而言,这种差距实际上已经消失。
基础:注意力机制
如今所有主流的大型语言模型——包括通过 Ollama 运行的模型——都基于 Transformer 架构,其核心是自注意力机制。给定从输入序列中提取的查询矩阵 Q、键矩阵 K 和值矩阵 V,它会计算如下缩放点积注意力:
QK^\top 表示词元之间的相关性(相似度),除以 \sqrt{d_k}(键维度的平方根)可以防止点积过大,导致 softmax 函数的梯度消失。Transformer 推理的本质就是对模型的所有参数和层深度重复此操作——而量化的作用就在于如何缩小大部分参数(权重矩阵),我们将在下文中详细介绍。
线性量化的基本形式
GGUF、AWQ 和 GPTQ 的基本思想都是线性量化:将浮点权重 x 转换为低位整数 q。
s 是尺度(每个步长的实数宽度),z 是零点(在整数表示中,实数零实际落在的位置)——这两个都是校准参数。每种方法如何确定这两个值,以及它们的粒度(整个模型、每层、每个权重),决定了它们之间的性能差异。
量化技术的成熟:GGUF、AWQ、GPTQ
除了提升模型性能之外,量化(缩小模型尺寸)也变得至关重要。 GGUF、AWQ 和 GPTQ 等量化方法已成功将模型大小减少约 70%,同时将准确率损失控制在 2% 以下,这使得一个 320 亿参数的类模型现在可以装入 16 GB 的内存。在典型的消费级硬件上进行本地推理,其质量已达到顶级模型的 70% 至 85%,且每次请求无需额外成本。
这三种格式各有优势。GGUF(以前称为 GGML)是 llama.cpp 及其生态系统(Ollama、LM Studio 等)的原生格式,在 CPU+GPU 混合推理方面表现出色。GPTQ 在纯 GPU 配置下具有极快的原始推理速度,而 AWQ 通常被认为是 4 位量化下单位大小准确率最高的选择。对于一般的本地开发用途,通常建议通过 Ollama 使用 GGUF 作为默认选择。
三种量化方法的技术差异
GGUF、AWQ 和 GPTQ 都是将模型权重从 16 位/32 位浮点数缩减到 4 位左右的量化方法,但它们实现方式的技术手段各不相同。
GPTQ 将量化视为一个优化问题。它近似地利用损失函数(Hessian 矩阵)的二阶信息来判断哪些权重的舍入误差对输出影响最大,然后,随着每个权重的依次量化,将产生的误差作为补偿分配到同一行中尚未量化的权重上。这种方法侧重于 GPU 推理性能,在单个 A100 GPU 上量化一个 70 亿参数的类模型大约需要 2-4 小时。
相比之下,AWQ 的重点不在于量化步骤本身,而在于确定“哪些权重真正重要”。它运行一个校准阶段,观察模型的实际激活值,识别对输出质量影响显著的“关键”权重,并在保持这些关键权重高精度的同时,对其他所有权重进行严格量化。它所需的校准样本比 GPTQ 少(大约 128-512 个,而 GPTQ 通常需要 2048 个以上),因此速度更快——对于一个 70 亿模型,大约只需 10-30 分钟。
GGUF(llama.cpp 的原生格式)使用一种称为“K-量化”的方案,为每一层分配不同的位深度——例如,对于注意力机制等重要层,使用 6 位;对于前馈层,使用 4 位,依此类推——从而实现比简单的 4 位均匀量化更高的每比特质量。一个典型的设置 Q4_K_M 据称可以保留原始模型约 92% 的质量。
这些技术差异直接对应于哪种用例适合哪种方法。AWQ 适用于仅使用 GPU 的高速推理;当成熟的 GPU 生态系统和庞大的预量化模型库至关重要时,GPTQ 是理想之选;当混合 CPU/GPU 环境下的易用性是首要考虑因素时,GGUF(通过 Ollama 等工具实现)则更为合适。
llama.cpp:本地推理引擎的工作原理
许多本地 LLM 运行时(包括 Ollama)的背后都运行着 llama.cpp——一个用 C/C++ 编写的推理引擎——以及其底层的张量库 GGML。GGML 是一个轻量级、低依赖性的张量计算库,与 PyTorch 或 TensorFlow 类似,它将模型的整个计算过程表示为一个“计算图”。一些张量存储实际数据(例如权重),而另一些张量则仅仅表示其他张量之间运算的结果,在实际执行计算之前没有任何值。这种计算图可以直接在 CPU 上运行,也可以转换成加速器指令——例如 NVIDIA GPU 的 CUDA 和 Apple 硬件的 Metal——这种可移植性,即在各种硬件配置上运行同一个模型文件,正是 GGUF 格式流行的技术基础。
增长背后的数据
这种格式的快速传播可以用具体的数字来衡量。Ollama 的月下载量从 2023 年第一季度的 10 万次增长到 2026 年第一季度的 5200 万次——三年内增长了 520 倍。同期,Hugging Face 上用于本地推理的 GGUF 格式模型数量也从 200 个增长到 13.5 万个。支撑这一切的 llama.cpp 项目在 GitHub 上的 star 数已超过 7.3 万。
2026 年末模型发布概览
根据 Ollama 官方博客的动态,2026 年下半年,Ollama 发布了一系列重要模型。8 月 10 日,Meta Superintelligence Labs 发布了其首个开源模型——拥有 300 亿参数的多模态模型“Muse Glimmer”,并采用 Apache 2.0 许可协议;紧接着,8 月 11 日,NVIDIA 发布了“Nemotron 3.5 Lightning”,这是一款专为多步骤智能体任务设计的 300 亿参数模型。6 月 29 日,Gemma 4 的更新使其在 Apple Silicon 的 MLX 运行时上的速度提升高达 90%,进一步提升了编码智能体用例的执行速度。Ollama 本身也在 7 月 9 日宣布完成 8800 万美元的融资,并表示其开发者用户已达 890 万。开源权重模型生态系统正超越简单的“发布模型”阶段,逐渐发展成为真正的商业基础设施。
量化前沿:NVFP4 作为新选择
继 GGUF、AWQ 和 GPTQ 之后,针对 NVFP4(一种专为 NVIDIA Blackwell 架构设计的 4 位浮点格式)的研究在 2026 年之前迅速发展,成为一种新的量化格式。2026 年 6 月的一项研究报告指出,16 位块大小可提供最佳的精度/存储权衡。ScaleSweep(2026 年 5 月)通过扫描搜索优化初始块缩放值,是目前多种方法之一,这些方法均表明,即使是激进的量化也能保留超过 93% 的全精度性能。后处理技术也应运而生,例如 H-Scale(2026 年 8 月),它使用基于二阶 Hessian 矩阵的近似方法来优化每个组的尺度值,且不会增加任何推理时间开销——这表明量化研究本身正在从“权重可以削减多少”转向“如何在削减权重后恢复精度”。
KV 缓存(用于存储生成过程中过去词元中间表示的内存区域,其大小会随着上下文长度的增加而膨胀)的压缩也在同步进行。SemKV(2026 年 8 月)根据重要性得分动态地为每个词元分配两个精度级别之一,据称在避免质量突然下降的“质量断崖”现象的同时,实现了 6.0 倍的存储空间缩减——如果与优化的量化器配合使用,则可实现 7.9 倍的存储空间缩减。对于长上下文的局部推理而言,KV 缓存压缩正变得与权重量化本身一样重要。
将权重拟合到内存中是否足以进行推理?
键值缓存、工作区和运行时开销也会消耗内存。
估算时请考虑上下文长度和并发性。
评论
请先登录。
暂无数据。