Contents — find the section you need
Büyük bir dil modelini kendi makinenizde, bulut API'si kullanmadan çalıştırmak ("Yerel LLM"), son birkaç yıldır pratik hale geldi. Bu, iki akımın birleşmesinin ürünüdür: daha iyi açık ağırlıklı modeller ve niceleme teknikleri yoluyla model küçültme.
 Ollama
 Sarılan Yüz
Resim: Ollama / Hugging Yüz logoları, Wikimedia Commons


Yerel Çıkarım Bir Bakışta
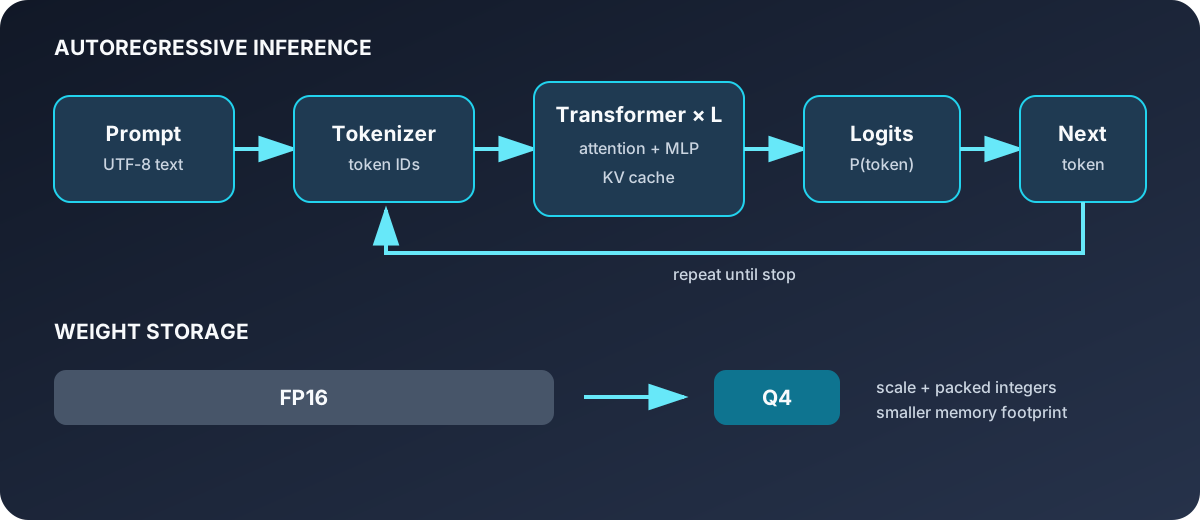
Diyagram: Duskcoil. Üretim yolu ve ağırlık nicelemesinin rolü ayrı ayrı gösterilmiştir.
Yerel bir LLM'yi anlamanın anahtarı, tekrarlanan çıkarım döngüsünü modeli tutmak için gereken bellekten ayırmaktır. Metin, belirteç kimlikleri haline gelir; dönüştürücü, bir sonraki belirteç için bir dağılım hesaplar; ve seçilen belirteç girişe geri döner. Niceleme ise, öncelikle ağırlıkların nasıl saklandığını ve hesaplandığını değiştirerek bir modelin sınırlı RAM veya VRAM'e sığmasını sağlar. Bu nedenle, yararlı bir dağıtım karşılaştırması yalnızca model adını değil, aynı zamanda ağırlık biçimini, bağlam uzunluğuyla büyüyen KV önbelleğini ve mevcut CPU/GPU arka uçlarını da dikkate alır.
Açık Ağırlıklı Modellerin Hızlı Yükselişi
2026 itibariyle açık ağırlıklı model ortamı, aylar süren bir zaman ölçeğinde sürekli olarak yeniden şekilleniyor. DeepSeek, Flash ve Pro varyantlarında yüksek verimliliği ön plana çıkarıyor; Qwen, donanım ve model boyutu seçeneklerinin ne kadar geniş olduğu sayesinde "ciddi bir rakip" olmaktan "lisansüstü düzeyde akıl yürütmede en üst düzey" olarak derecelendirilmeye yükseldi. Meta'nın Llama 4'ü, açık bir model için 10 milyon token'a kadar uzanan bir bağlam penceresi sunuyor. Daha yakın zamanda, Z.ai'nin GLM-5.2'si kodlama ajanı performansında büyük bir sıçrama yaptı ve piyasaya sürülmesinden günler sonra ajan çerçevelerine entegre edildi ve Kimi K2.7 Code HighSpeed, çok modlu kodlama akıl yürütmesinde 6 kat hızlanma iddiasında bulunuyor - değişim hızı son derece yüksek.
Benchmark sonuçları da önemli bir değişime işaret ediyor. SWE-bench tarzı kodlama değerlendirme paketlerinde, en iyi açık ağırlıklı modeller ile önde gelen ticari modeller arasındaki fark tek haneli yüzde puanlarına kadar daraldı ve bazıları bu farkın günlük mühendislik çalışmaları için fiilen kapandığını savunuyor.
Temel: Dikkat Mekanizması
Ollama'da kullanılanlar da dahil olmak üzere günümüzdeki tüm büyük dil modelleri, transformatör mimarisi üzerine kuruludur ve özünde öz-dikkat mekanizması bulunur. Giriş dizisinden türetilen sorgu Q, anahtar K ve değer V matrisleri verildiğinde, ölçeklendirilmiş nokta çarpımı dikkatini şu şekilde hesaplar:
QK^\top, belirteçlerin birbirleriyle ne kadar ilişkili (ne kadar benzer) olduğunu temsil eder ve \sqrt{d_k}'a (anahtar boyutunun karekökü) bölmek, nokta çarpımlarının softmax'ın gradyanının sıfıra inmesine neden olacak kadar büyümesini engeller. Bu işlemin bir modelin tüm parametre sayısı ve katman derinliği boyunca tekrarlanması, transformatör çıkarımının özüdür ve bu parametrelerin (ağırlık matrislerinin) ne kadar küçültülebileceği, bir sonraki bölümde ele alınan nicelemenin oynadığı roldür.
Doğrusal Nicelleştirmenin Temel Biçimi
GGUF, AWQ ve GPTQ'nun temelinde yatan fikir doğrusal nicelleştirmedir: kayan noktalı bir ağırlığı x daha düşük bitli bir tamsayıya q dönüştürmek.
s ölçek (adım başına gerçek sayı genişliği) ve z sıfır noktasıdır (tamsayı gösteriminde gerçek sayı sıfırının gerçekte düştüğü yer) — her ikisi de kalibrasyon parametresidir ve her yöntemin bu iki değeri nasıl ve hangi ayrıntı düzeyinde (tüm model, katman başına, ağırlık başına) belirlediği, aralarındaki performans farklılıklarını belirler.
Nicelleştirmenin Olgunlaşması: GGUF, AWQ, GPTQ
Daha iyi model performansının yanı sıra, nicelleştirme — model boyutunu küçültme — de aynı derecede önemli hale gelmiştir. GGUF, AWQ ve GPTQ gibi niceleme yöntemleri, doğruluk kaybını %2'nin altında tutarken model boyutunu yaklaşık %70 oranında küçültmeyi başardı; bu sayede 32 milyar parametreli bir sınıf modeli artık 16 GB belleğe sığabiliyor. Tipik tüketici donanımında yerel çıkarım, istek başına sıfır ek maliyetle, üst düzey bir modelin kalitesinin %70-85'ine ulaşıyor.
Üç formatın her birinin kendi güçlü yönleri var. GGUF (eski adıyla GGML), llama.cpp ve ekosistemi (Ollama, LM Studio ve benzerleri) için yerel formattır ve hibrit CPU+GPU çıkarımında güçlüdür. GPTQ, yalnızca GPU kurulumlarında ham çıkarım hızında mükemmeldir ve AWQ, 4 bit nicelemede boyut başına doğruluk açısından genellikle en güçlü seçenek olarak kabul edilir. Genel yerel geliştirme kullanımı için, Ollama aracılığıyla GGUF genellikle varsayılan seçim olarak önerilir.
Üç Nicelleştirme Yöntemi Arasındaki Teknik Farklar
GGUF, AWQ ve GPTQ, model ağırlıklarını 16-bit/32-bit kayan noktalı sayılardan yaklaşık 4 bite kadar küçülten nicelleştirme yöntemleridir, ancak bunu teknik olarak farklı yollarla yaparlar.
GPTQ, nicelleştirmeyi bir optimizasyon problemi olarak ele alır. Hangi ağırlıkların yuvarlama hatalarının çıktı için en önemli olduğunu belirlemek için kayıp fonksiyonundan (Hessian) yaklaşık ikinci dereceden bilgi kullanır, ardından her ağırlık sırayla nicelleştirilirken, ortaya çıkan hatayı aynı satırdaki henüz nicelleştirilmemiş ağırlıklara telafi olarak dağıtır. GPU çıkarım performansına odaklanan bir yöntemdir ve 7 milyar parametreli bir sınıf modelinin nicelleştirilmesi tek bir A100 GPU'da yaklaşık 2-4 saat sürer.
AWQ ise, nicelleştirme adımının kendisine değil, "hangi ağırlıkların gerçekten önemli olduğunu" bulmaya odaklanır. Bu yöntem, modelin gerçek aktivasyonlarını gözlemleyen, çıktı kalitesini güçlü bir şekilde etkileyen "önemli" ağırlıkları belirleyen ve bu ağırlıkları yüksek hassasiyette tutarken geri kalan her şeyi agresif bir şekilde nicelleştiren bir kalibrasyon aşaması yürütür. GPTQ'dan daha az kalibrasyon örneğine ihtiyaç duyar (yaklaşık 128-512, GPTQ için genellikle 2048+'a karşılık), bu da onu önemli ölçüde daha hızlı hale getirir - 7B'lik bir model için yaklaşık 10-30 dakika.
GGUF (llama.cpp'nin yerel formatı), "K-quants" adı verilen bir şema kullanır ve her katman için farklı bir bit derinliği atar - dikkat gibi yüksek öneme sahip bir katman için 6 bit, ileri besleme katmanı için 4 bit vb. - böylece basit tekdüze 4 bitlik nicelleştirmeye göre bit başına daha yüksek kalite elde eder. Temsili bir ayar olan Q4_K_M'nin, orijinal modelin kalitesinin yaklaşık %92'sini koruduğu söylenmektedir.
Bu teknik farklılıklar, hangi kullanım durumunun hangi yönteme uygun olduğunu doğrudan belirler. AWQ, yalnızca GPU tabanlı, yüksek hızlı çıkarım için; GPTQ, olgun bir GPU ekosistemi ve geniş bir önceden nicelenmiş model kütüphanesi en önemli olduğunda; GGUF (Ollama vb. aracılığıyla), hibrit CPU/GPU ortamında kullanım kolaylığı öncelikli olduğunda kullanılır.
llama.cpp: Yerel Çıkarımın Arkasındaki Motor Nasıl Çalışır
Ollama dahil birçok yerel LLM çalışma ortamının arkasında, C/C++ ile yazılmış bir çıkarım motoru olan llama.cpp ve onun altındaki tensör kütüphanesi GGML bulunur. GGML, bir modelin tüm hesaplamasını "hesaplama grafiği" olarak temsil eden, PyTorch veya TensorFlow'a kabaca benzer, hafif, düşük bağımlılığa sahip bir tensör hesaplama kütüphanesidir. Bazı tensörler gerçek verileri (ağırlıklar gibi) tutarken, diğerleri yalnızca diğer tensörler arasındaki bir işlemin sonucunu temsil eder ve hesaplama gerçekten yürütülene kadar hiçbir değer taşımaz. Bu hesaplama grafiği doğrudan CPU üzerinde çalıştırılabilir veya bir hızlandırıcı için talimatlara dönüştürülebilir — NVIDIA GPU'lar için CUDA, Apple donanımı için Metal — ve bu taşınabilirlik, aynı model dosyasını çok çeşitli donanım yapılandırmalarında çalıştırma, GGUF formatının popülaritesinin temelini oluşturan teknik temeldir.
Büyümenin Ardındaki Rakamlar
Bunun ne kadar hızlı yayıldığı somut rakamlarda ortaya çıkıyor. Ollama'nın aylık indirme sayısı 2023'ün ilk çeyreğinde 100.000'den 2026'nın ilk çeyreğinde 52 milyona yükseldi — üç yılda 520 kat artış. Yerel çıkarım için biçimlendirilmiş GGUF formatlı modellerin sayısı, aynı dönemde Hugging Face'te 200'den 135.000'e yükseldi. Tüm bunların temelini oluşturan llama.cpp projesi, GitHub'da 73.000 yıldızı geçti.
2026 Yılının Sonlarına Doğru Model Yayın Manzarası
Ollama'nın resmi blogunu takip ettiğimizde, 2026 yılının ikinci yarısında birbiri ardına büyük yayınlar gerçekleştiğini görüyoruz. 10 Ağustos'ta Meta Superintelligence Labs, Apache 2.0 lisansı altında "Muse Glimmer" adlı 30 milyar parametreli çok modlu ilk açık modelini yayınladı; hemen ertesi gün, 11 Ağustos'ta NVIDIA, çok adımlı ajan görevleri için tasarlanmış 30 milyar parametreli bir model olan "Nemotron 3.5 Lightning"i duyurdu. 29 Haziran'da, Gemma 4'ü Apple Silicon'ın MLX çalışma zamanında %90'a kadar daha hızlı hale getiren bir güncelleme yayınlandı ve kodlama ajanı kullanım durumları için yürütme hızına yönelik çabalar devam etti. Ollama'nın kendisi de 9 Temmuz'da 88 milyon dolarlık bir finansman turunu duyurdu ve 8,9 milyon geliştirici kullanıcıya ulaştığını bildirdi. Açık ağırlıklı model ekosistemi, sadece "model yayınlamanın" ötesine geçerek gerçek bir ticari altyapı şeklini alıyor.
Nicelleştirmenin Son Noktası: Yeni Bir Seçenek Olarak NVFP4
GGUF, AWQ ve GPTQ'nun ardından, NVIDIA'nın Blackwell mimarisi için tasarlanmış 4 bitlik kayan noktalı bir format olan NVFP4 üzerine yapılan araştırmalar, yeni bir nicelleştirme formatı olarak 2026 yılına kadar hızla büyüdü. Haziran 2026'da yapılan bir çalışma, 16'lık bir blok boyutunun en iyi doğruluk/depolama dengesini sunduğunu ve tarama araması yoluyla başlangıç blok ölçek değerlerini optimize eden ScaleSweep'in (Mayıs 2026), agresif nicelleştirmenin bile tam hassasiyet performansının %93'ünden fazlasını koruyabileceğini bildiren çeşitli yöntemlerden biri olduğunu ortaya koydu. H-Scale (Ağustos 2026) gibi, her grup için ölçek değerlerini, sıfır ek çıkarım süresi yüküyle ikinci dereceden Hessian tabanlı bir yaklaşımla iyileştiren işlem sonrası teknikler de ortaya çıkmıştır; bu da niceleme araştırmasının kendisinin "ağırlıklar ne kadar azaltılabilir"den "azaltıldıktan sonra doğruluğu nasıl geri kazanabiliriz"e doğru kaydığının bir işaretidir.
KV önbelleğinin (üretim sırasında geçmiş belirteçlerin ara temsillerini tutan ve daha uzun bağlamlarla şişen bellek bölgesi) sıkıştırılması da paralel olarak ilerlemektedir. Önem puanına bağlı olarak belirteç başına iki hassasiyet seviyesinden birini dinamik olarak atayan SemKV (Ağustos 2026), kalitenin aniden düştüğü "kalite uçurumu" fenomeninden kaçınırken 6,0 kat depolama azaltımı sağladığını ve optimize edilmiş bir niceleyici ile eşleştirildiğinde 7,9 kat azaltım sağladığını bildirmektedir. Uzun bağlamlar üzerinde yerel çıkarım için, KV önbellek sıkıştırması, ağırlık nicelemesinin kendisi kadar pratik bir odak noktası haline gelmektedir.
Ağırlıkların belleğe yerleştirilmesi çıkarım için yeterli mi?
KV önbelleği, çalışma alanı ve çalışma zamanı ek yükü de bellek tüketir. Tahmine bağlam uzunluğunu ve eşzamanlılığı dahil edin.
Referanslar
- En İyi Açık Ağırlıklı LLM'ler 2026: DeepSeek vs Qwen vs Kimi vs GLM vs Llama
- LLM Nicelleştirme Açıklaması: GGUF vs AWQ vs GPTQ — 2026 İçin Tam Kılavuz
- 2026'da Yerel Yapay Zeka: Ollama Kıyaslamaları, 0$ Çıkarımı ve Token Başına Fiyatlandırmanın Sonu
- LLM Nicelleştirme Kılavuzu: GGUF vs AWQ vs GPTQ vs bitsandbytes Karşılaştırması (2026)
- llama.cpp GitHub (ggml-org) )
- Ollama resmi blogu
- H-Scale Makalesi (arXiv)
- ScaleSweep Makalesi (arXiv)
- SemKV Makalesi (arXiv)
Yorumlar
Lütfen önce giriş yapın.
Henüz veri yok.