Contents — find the section you need
Bir Dünya Modeli, bir ajanın bir eylemde bulunduğunda ortamın durumunun nasıl değişeceğini tahmin etmeyi öğrenen bir model için kullanılan genel bir terimdir. Robotik ve pekiştirmeli öğrenmede, "gerçek dünyada hareket etmeden önce kafanızda denemeler yapmak" için dahili bir simülatör görevi görür; video üretimi yapay zekası bağlamında ise "sadece makul görünen videolar üretmek değil, aynı zamanda ortamın kendisini fiziksel yasalara göre simüle etmek" için temel oluşturur. Bu kavram, son birkaç yıldır her iki yönden de hızla artan bir ilgi görmüştür.
 NVIDIA Cosmos
Resim: NVIDIA logo, Wikimedia Commons. Burada, fiziksel yapay zeka için Cosmos serisi Dünya Temel Modellerini geliştiren şirket olarak tanıtılıyor.

Tek Bir Diyagramda Dünya Modelleri
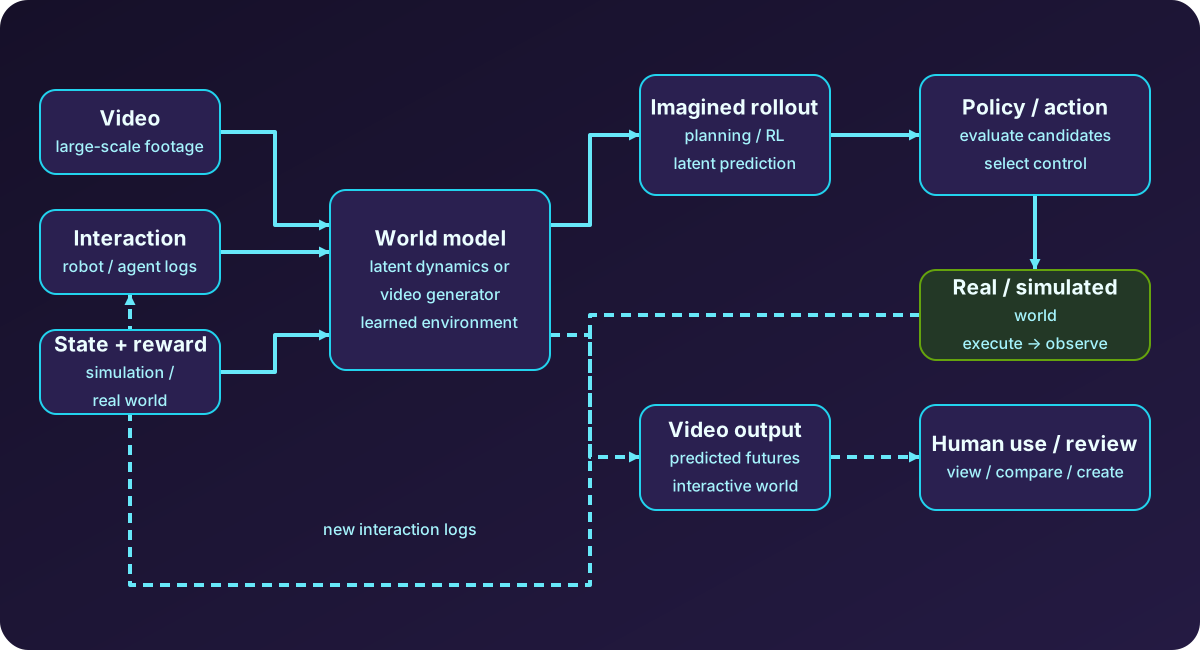
Diyagram: Duskcoil tarafından oluşturulmuştur. Model tabanlı takviyeli öğrenme için dahili bir simülatör olarak kullanım ile video üretim modeli olarak kullanımı birleştiren basitleştirilmiş tek bir diyagram.
Dünya Modellerini anlama ekseni iki soruya ayrılıyor: ne tahmin ediliyor (ham video pikselleri veya sıkıştırılmış gizli bir temsil) ve ne için kullanılıyor (politika öğrenimi için dahili bir simülatör veya bir insanın izlemesi için video üretimi). Aynı "Dünya Modeli" terimi, Dreamer'da olduğu gibi bir robotun simülasyondan gerçekliğe öğrenmesini destekleyen olasılıksal gizli dinamik modeline veya Sora veya Genie'de olduğu gibi on milyarlarca parametreye sahip bir video oluşturma modeline atıfta bulunabilir; bu, bağlam doğru tutulmadığı takdirde tartışmaların birbirini anlamayabileceği bir alandır.
Soy Ağacı: Ha ve Schmidhuber'in Orijinal Makalesinden DreamerV3'e
"Dünya Modelleri" teriminin mevcut anlamıyla yayılmaya başladığı nokta, David Ha ve Jürgen Schmidhuber'in 2018 tarihli bir makalesine dayanmaktadır. Kurulumlarında, bir VAE (varyasyonel otoenkoder) görsel gözlemleri kompakt bir temsile sıkıştırır ve bir RNN (LSTM) bu temsilin zaman içinde nasıl değiştiğini tahmin eder; bir ajanın tamamen bu öğrenilmiş gizli alanın "içinde" bir politika eğitebileceğini gösterdiler.
Bu tasarım, 2019'da PlaNet'te önemli ölçüde geliştirildi; PlaNet'in RSSM'si (Tekrarlayan Durum Uzayı Modeli), çok adımlı tahmin doğruluğunu ve tutarlılığını önemli ölçüde iyileştirmek için deterministik ve stokastik bileşenleri birleştirdi. PlaNet, model öngörücü kontrol (MPC) olarak her adımda bir planı yeniden çözerken, daha sonraki Dreamer işleri daha da ileri götürerek, dünya modeli içinde geri yayılım yoluyla doğrudan bir politika (aktör) ve değer fonksiyonu (eleştirmen) öğrendi - bu tasarım, o zamandan beri "Dreamer ailesi" için temel şablon haline geldi. DreamerV2, ayrık gizli temsilleri tanıttı ve 2025'te Nature'da yayınlanan DreamerV3, sabit hiperparametre ayarlaması olmadan Minecraft'ta elmas madenciliği de dahil olmak üzere çeşitli alanlarda genelleştirilmiş performans göstererek, model tabanlı takviyeli öğrenmede dünya modellerinin pratik kullanışlılığı için çıtayı önemli ölçüde yükseltti.
Üretken Yapay Zeka Tarafından Yakınsama: Sora, Genie, World Labs
Takviyeli öğrenme soyundan ayrı olarak, "Dünya Modeli" terimi video üreten yapay zeka tarafında da kullanılmaya başlandı. 2024 yılında OpenAI, video üreten model Sora hakkındaki teknik raporunda, "video üreten modelleri ölçeklendirmenin, fiziksel dünyanın genel amaçlı simülatörlerini oluşturmaya yönelik umut vadeden bir yol olduğunu" savundu ve Sora'nın fiziksel yasaların ve nedenselliğin bazı yönlerini örtük olarak öğrendiğinin kanıtı olarak tuval üzerinde kalıcı boya fırça darbeleri ve birinin hamburger yedikten sonra kalan ısırık izleri gibi örnekler gösterdi.
Google DeepMind'ın Genie serisi bu yönü daha da ileriye taşıdı: Aralık 2024'te Genie 2, tek bir görüntüden kontrol edilebilir bir 3B ortam üretebildiğini gösterdi ve Ağustos 2025'te Genie 3, saniyede 24 kare ve 720p çözünürlükte, metin komutundan dakikalarca süren, gerçek zamanlı keşfedilebilir 3B dünyalar üretebildi. DeepMind bunu, robotikte navigasyon, algılama ve uzun vadeli akıl yürütme için eğitim verisi üretmenin ölçeklenebilir bir yolu olarak konumlandırıyor ve Şubat 2026'da Waymo'nun otonom sürüş simülasyonu için bu teknolojiyi benimsediği bildirildi.
Stanford'dan Fei-Fei Li tarafından kurulan World Labs, Kasım 2025'te ticari ürünü Marble'ı duyurdu. Marble, metin, resim veya video parçalarından kalıcı, indirilebilir 3 boyutlu ortamlar (Gaussian Splatting, ağlar veya video olarak dışa aktarılabilir) oluşturuyor. Li, Haziran 2026'da yayınladığı bir makalede, Dünya Modellerini işlevsel olarak üç kategoriye ayırdı: Renderer (insan gözünün görebileceği video çıktısı verir), Simulator (bir programın hesaplama için kullanabileceği geometrik ve fiziksel olarak doğru bir temsil çıktısı verir) ve Planner (gözlemlerden ve bir hedeften sonraki eylemi çıktı olarak verir) — Sora ve Genie gibi video oluşturma sistemlerini Renderer'a, robot öğrenme dinamikleri modellerini Simulator'a ve VLA'yı Planner'a daha yakın konumlandırdı.
NVIDIA Cosmos: Robotik için Bir Dünya Temel Modeli
Robotik endüstrisi tarafında giderek daha fazla ilgi gören bir yaklaşım ise NVIDIA'nın Cosmos serisidir. Haziran 2026'da duyurulan Cosmos 3, görsel akıl yürütmeyi, dünya oluşturmayı ve eylem tahminini tek bir modelde birleştiren, metin, görüntü, video, çevresel ses ve eylem gibi birden fazla modülü tek bir çerçeve içinde ele alan bir transformatör karışımı mimarisi benimser. Amaç, bir veri üretim hattı oluşturmaktır: gerçek bir robot kolunda binlerce saatlik deneme yapmak yerine, bir robotun bir görevi yerine getirdiğine dair büyük miktarda simüle edilmiş video üretmek, bu veriler üzerinde bir politika eğitmek ve ardından bunu gerçek donanıma uygulamak. NVIDIA, Agile Robots, Black Forest Labs, Runway ve Skild AI gibi ortaklarla birlikte, Dünya Temel Modelleri için açık bir ekosistem oluşturmak üzere Cosmos Koalisyonu'nu kurdu.
Üretken mi Değil mi: LeCun'un JEPA'sı Karşı Eksen Olarak
Sora, Genie ve Cosmos'un ortak noktası, doğrudan piksel (veya bunlara yakın bir temsil) üreten bir tasarıma sahip olmalarıdır. Meta AI'da Baş Yapay Zeka Bilimcisi olan Yann LeCun, bu üretken yaklaşıma karşı sürekli olarak şüpheci bir tavır sergilemiştir. Önerdiği JEPA (Ortak Gömülü Tahmin Mimarisi), soyut bir temsil alanında tahmin yaparak ve asla piksel veya belirteç üretmeyerek net bir çizgi çizen bir tasarımdır. Bu tasarım felsefesi üzerine inşa edilen V-JEPA 2'nin, yaklaşık bir milyon saatlik internet videosu üzerinde ön eğitimden ve sadece 62 saatlik robot manipülasyon verisi üzerinde ince ayardan sonra, sıfır atışlı robot manipülasyon görevlerinde yaklaşık %80 başarı elde ettiği bildiriliyor. LeCun, 2026'nın başlarında Meta'dan ayrıldı, Paris'te AMI Labs'ı kurdu ve genel amaçlı bir Dünya Modeli oluşturmaya odaklanmak için bir milyar doları aşan tohum fonu topladı; şimdi de "üretken modeller Dünya Modelleri olarak çıkmaz sokaktır" iddiasını test etmeye başladığı bir aşamaya girdi.
2026 itibariyle, üretken ve üretken olmayan (JEPA tarzı) yaklaşımlardan hangisinin üstün olduğu henüz kararlaştırılamadı. Üretken modeller, insanların doğrudan gözle değerlendirebileceği videolar üretme gücüne sahipken, JEPA tarzı yaklaşımların soyut bir temsilde tahmin yaparak hesaplama verimliliği ve uzun vadeli tahmin istikrarı konusunda bir avantaja sahip olduğu söyleniyor; ancak her iki taraf da büyük ölçekli gerçek dünya uygulamalarında henüz belirleyici bir avantaj göstermedi.
Açık Zorluklar: Fiziksel Tutarlılık, Uzun Vadeli Uyum ve Değerlendirme
Fiziksel tutarlılık: Sora'nın ürettiği videoda fizik yasalarının ihlaline dair çok sayıda somut örnek gösterildi - yerçekimini görmezden gelerek havada süzülen nesneler, hareket etmeyen bir mum alevi, yanlış sayıda bacağı olan bir karınca, cam kırıldığında doğal olmayan parçalanma davranışı. Analizler, güçlü modellerin bile yerçekimi, nesne kalıcılığı ve nedensel tutarlılık konusunda başarısız olduğunu göstermiştir ve bu noktadaki tarafsız değerlendirme, Sora 2'nin 3 boyutlu yapı ve fiziksel nedensellik hakkında açıkça "bir şeyler" öğrendiği, ancak bu şeyin geleneksel bir fizik motoruyla aynı olmadığı yönündedir.
Uzun vadeli uyum: Bir ortamın durumunun, onlarca saniyenin ötesindeki süreler boyunca bozulmadan korunup korunamayacağı çözülmemiş bir zorluk olmaya devam etmektedir. 2026 yılında önerilen WorldRoamBench gibi değerlendirme kıyaslama ölçütleri, uzun vadeli istikrarı dört eksen boyunca değerlendiriyor: eylem doğruluğu, görsel bozulma (kayma), fiziksel tutarlılık ve bellek tutarlılığı (önceden ziyaret edilen konumların ve nesnelerin hatırlanıp hatırlanmadığı). Ayrıca, mevcut birçok değerlendirme yönteminin başlangıçta yalnızca 5-10 saniyelik kısa zaman dilimlerine baktığını belirtiyorlar.
Değerlendirme zorluğu: "İyi bir dünya modeli"nin niceliksel olarak nasıl ölçüleceği konusunda henüz bir fikir birliği yok. Oluşturulan videonun görsel doğallığı ve robot kontrol görevlerindeki kullanışlılığı her zaman örtüşmüyor ve çıktıların anlamsal ölçeği modeller arasında farklılık gösterdiğinden, yörüngeleri modeller arasında adil bir şekilde karşılaştırmanın zor olduğu belirtiliyor.
Hesaplama maliyeti: Büyük ölçekli dünya modellerini değerlendirmek ve eğitmek pahalıdır; tek bir API çağrısının bir dolardan fazla maliyeti olduğu bildiriliyor. Uzun vadeli görevleri öğrenen ve değerlendiren modeller, tek bir yanıtta 100.000'e yakın belirteç üretebilir; bu da araştırma tekrarlanabilirliğinin önünde bir engel haline gelmektedir.
Robot Öğrenmesiyle Bağlantı Noktası
Dünya Modellerinin doğrudan robotik alanına uygulanmasının önde gelen bir örneği, 1X Technologies'in kendi insansı robotu NEO için geliştirdiği video Dünya Modelidir (ayrıntılar için "İnsansı Robotlardaki Teknoloji Trendleri" bölümüne bakınız). 14 milyar parametreli bir video oluşturma modelinin "tamamlanan görevin kısa bir videosunu" hayal ettiği ve daha sonra bir Ters Dinamik Modeli aracılığıyla gerçek motor komutlarına dönüştürüldüğü tasarım, bir Oluşturucu (video oluşturma) ile bir Planlayıcı (eylem oluşturma) arasında doğrudan bağlantı kurmanın somut bir örneğidir.
Klasik pekiştirmeli öğrenme bağlamında, model tabanlı pekiştirmeli öğrenme (MBRL) bu kavramı yıllardır daha temelli bir biçimde ele almaktadır. Bir durum s ve bir eylem a'dan bir sonraki durumu tahmin eden bir dünya modeli \hat f_\theta'ün öğrenilmesinin tasarımı, gerçek donanıma dağıtmadan önce aday eylem dizilerinin model içinde değerlendirilmesi, tahmin hatası birikiminin alan rastgeleleştirmesi yoluyla nasıl ele alındığı ve simülasyondan gerçek ortama geçiş için aşamalı süreç - tüm bunlar "Model Tabanlı Takviyeli Öğrenmeye ve Simülasyondan Gerçek Ortama Giriş" makalesinde ayrıntılı olarak ele alınmıştır. Video oluşturma tarzı Dünya Modelleri ve MBRL'nin gizli dinamik modelleri farklı temsil çözünürlük seviyelerinde çalışır, ancak aynı temel fikri paylaşırlar: her şeyi gerçek donanımda denemeden önce öğrenilmiş bir model içinde deneyin.
Mevcut Durum
- Hedef: İnsanların izleyebileceği video/sanal ortamlar: Sora, Genie 3 ve World Labs'ın Marble'ı gibi Üretken Dünya Modelleri. Görsel olarak etkileyici, ancak fiziksel sağlamlık garanti edilmiyor
- Hedef: Robot politika öğrenimi ve değerlendirmesi için veri üretmek: Video üretim teknolojisini doğrudan robot eylem üretimine bağlayan NVIDIA Cosmos ve 1X Dünya Modeli gibi tasarımlar. Gerçek donanım veri toplama darboğazını hafifletmesi bekleniyor
- Hedef: Model tabanlı pekiştirmeli öğrenme için dahili bir simülatör: DreamerV3 ailesi gizli dinamik modelleri. Hesaplama açısından nispeten hafif ve doğrudan bir politika öğrenme döngüsüne kolayca entegre edilebilir, ancak işleyebilecekleri gözlemlerin karmaşıklığı sınırlıdır
- Hedef: Temsil öğrenimi ve genel amaçlı tahmin: V-JEPA ailesindeki üretken olmayan yaklaşımlar. Piksel üretiminin maliyetinden kaçınırken, alt görevlere aktarım performansını hedefliyor
Bu eğilimlerin her biri aynı temele dayanıyor - bir ortamın dinamiklerini öğrenme yoluyla içselleştirmek - ancak ne ürettiklerine ve kimin (veya neyin) için ürettiklerine bağlı olarak dallanıyorlar: bir insan, bir program veya bir politika öğrenme döngüsü. Bu, 2026 yılı itibariyle gerçekliktir.
Gerçekçi gelecek videosu doğru fiziksel tahminler oluşturuyor mu?
Görsel inandırıcılık ve eyleme bağlı dinamikler farklılık gösterir.
Tahmin edilen durum değişikliklerini aynı eylemler altındaki gerçek geçişlerle karşılaştırın.Referanslar
- Dünya Modelleri, orijinal makale (Ha & Schmidhuber, 2018)
- Dreamer resmi blogu (Google Araştırma)
- DreamerV3 makalesi, "Dünya modelleri aracılığıyla çeşitli kontrol görevlerinde ustalaşma" (Nature)
- Dünya simülatörleri olarak video oluşturma modelleri (OpenAI, resmi)
- Genie 3: Dünya modelleri için yeni bir sınır (Google DeepMind, resmi)
- Genie 2: Büyük ölçekli bir temel dünya modeli (Google DeepMind, resmi)
- [World Labs Marble duyurusu] (TechCrunch)](https://techcrunch.com/2025/11/12/fei-fei-lis-world-labs-speeds-up-the-world-model-race-with-marble-its-first-commercial-product/)
- Dünya Modellerinin Fonksiyonel Bir Taksonomisi (Fei-Fei Li, resmi blog)
- NVIDIA Cosmos 3 duyurusu (NVIDIA Haber Odası)
- V-JEPA (Meta AI, resmi)
- WorldRoamBench makalesi (arXiv)
- Model tabanlı takviyeli öğrenme ve simülasyondan gerçeğe geçiş hakkında ayrıntılı bilgi için ayrıca "Model Tabanlı Takviyeli Öğrenmeye ve Simülasyondan Gerçeğe Geçişe Giriş" bölümüne bakın.
Yorumlar
Lütfen önce giriş yapın.
Henüz veri yok.