Contents — find the section you need
월드 모델(World Model)은 에이전트가 행동을 취할 때 환경의 상태가 어떻게 변화할지 예측하도록 학습하는 모델을 가리키는 일반적인 용어입니다. 로봇 공학 및 강화 학습에서는 "실제 세계에서 행동하기 전에 머릿속으로 시뮬레이션해 보는" 내부 시뮬레이터 역할을 합니다. 비디오 생성 AI의 맥락에서는 "그냥 그럴듯해 보이는 비디오를 생성하는 것이 아니라 물리 법칙에 따라 환경 자체를 시뮬레이션하는" 기반이 됩니다. 이 개념은 지난 몇 년 동안 양방향에서 빠르게 주목받고 있습니다.
 NVIDIA Cosmos
이미지: NVIDIA logo, Wikimedia Commons. 여기서는 물리적 AI를 위한 코스모스 시리즈 월드 파운데이션 모델을 개발하는 회사로 소개됩니다.

월드 모델을 하나의 다이어그램으로 이해하기
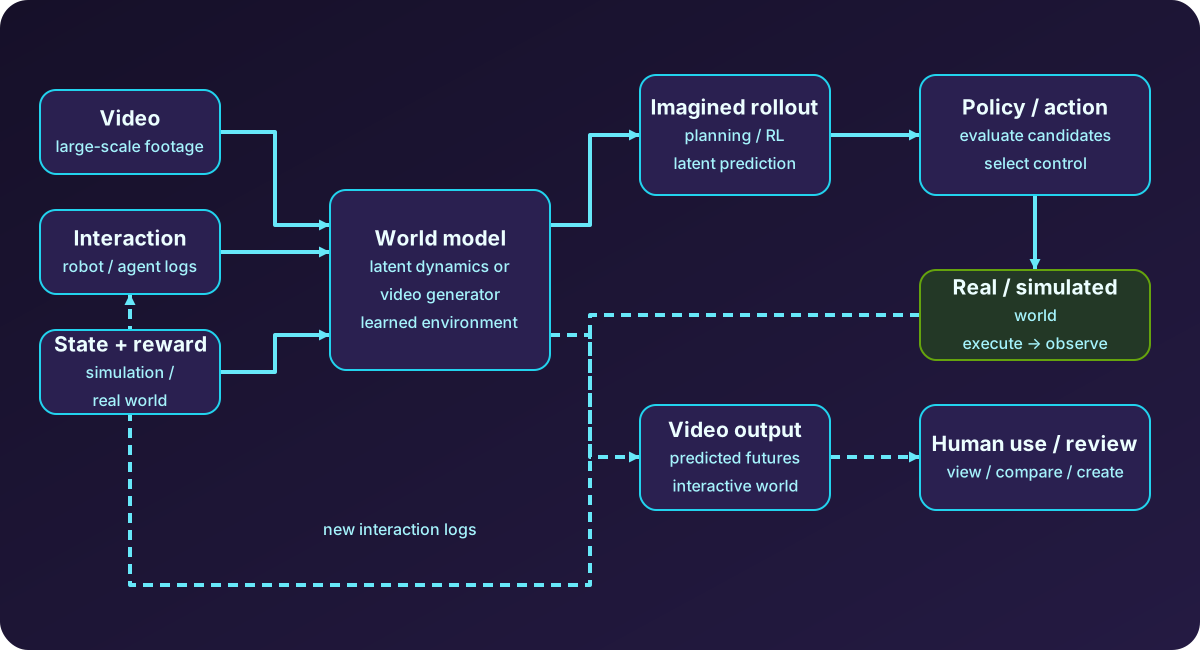
다이어그램: Duskcoil 제작. 모델 기반 강화 학습을 위한 내부 시뮬레이터로서의 사용과 비디오 생성 모델로서의 사용을 하나의 간소화된 다이어그램으로 결합했습니다.
월드 모델을 이해하는 축은 두 가지 질문으로 나뉩니다. 무엇을 예측하는가(원시 비디오 픽셀 또는 압축된 잠재 표현), 그리고 무엇에 사용되는가(정책 학습을 위한 내부 시뮬레이터 또는 인간이 시청할 비디오 생성). "월드 모델"이라는 용어는 드림어(Dreamer)처럼 로봇의 시뮬레이션에서 현실로의 학습을 뒷받침하는 확률적 잠재 동역학 모델을 지칭할 수도 있고, 소라(Sora)나 지니(Genie)처럼 수백억 개의 매개변수를 가진 비디오 생성 모델을 지칭할 수도 있습니다. 따라서 맥락을 명확히 하지 않으면 서로 다른 이야기가 오갈 수 있는 분야입니다.
계보: 하와 슈미드후버의 최초 논문에서 드림어V3까지
"월드 모델"이라는 용어가 현재와 같은 의미로 널리 사용되기 시작한 것은 데이비드 하와 위르겐 슈미드후버가 2018년에 발표한 논문에서입니다. 그들의 연구에서는 변분 오토인코더(VAE)가 시각적 관찰값을 간결한 표현으로 압축하고, 순환 신경망(LSTM)이 해당 표현이 시간에 따라 어떻게 변화하는지 예측합니다. 연구진은 에이전트가 학습된 잠재 공간 "내부"에서 정책을 완전히 학습할 수 있음을 보여주었습니다.
이 설계는 2019년 PlaNet에서 크게 개선되었는데, PlaNet의 RSSM(순환 상태 공간 모델)은 결정론적 요소와 확률론적 요소를 결합하여 다단계 예측 정확도와 일관성을 크게 향상시켰습니다. PlaNet이 모델 예측 제어(MPC)를 통해 매 단계마다 계획을 다시 도출했다면, 후속 모델인 Dreamer는 한 단계 더 나아가 월드 모델 내부에서 역전파를 통해 정책(액터)과 가치 함수(크리틱)를 직접 학습하는 방식을 채택했습니다. 이 설계는 이후 "Dreamer 계열"의 기본 템플릿이 되었습니다. DreamerV2는 이산 잠재 표현을 도입했고, 2025년 Nature에 발표된 DreamerV3는 고정된 하이퍼파라미터 튜닝 없이 마인크래프트에서 다이아몬드 채굴을 포함한 다양한 영역에서 일반화된 성능을 보여주며, 모델 기반 강화 학습에서 월드 모델의 실용적인 유용성에 대한 기준을 크게 높였습니다.
생성형 AI 분야의 융합: Sora, Genie, World Labs
강화 학습 계보와는 별개로, "월드 모델"이라는 용어는 비디오 생성 AI 분야에서도 사용되기 시작했습니다. 2024년, OpenAI는 비디오 생성 모델 Sora에 대한 기술 보고서에서 "비디오 생성 모델의 확장성은 물리 세계의 범용 시뮬레이터를 구축하는 데 유망한 길이다"라고 주장하며, 캔버스에 남은 물감 자국이나 햄버거를 먹은 후 남은 한입 자국과 같은 사례를 들어 Sora가 물리 법칙과 인과 관계의 일부를 암묵적으로 학습했음을 보여준다고 언급했습니다.
구글 딥마인드의 지니(Genie) 시리즈는 이러한 방향으로 더욱 나아갔습니다. 2024년 12월, 지니 2는 단 하나의 이미지에서 제어 가능한 3D 환경을 생성할 수 있음을 보여주었고, 2025년 8월에는 지니 3가 텍스트 입력만으로 초당 24프레임, 720p 해상도의 실시간 탐색 가능한 3D 세계를 생성하여 수분 동안 지속될 수 있음을 입증했습니다. 딥마인드는 이 기술을 로봇 공학 분야의 내비게이션, 인지, 장기 추론을 위한 훈련 데이터 생성에 확장 가능한 방식으로 활용할 수 있다고 주장했으며, 2026년 2월에는 웨이모(Waymo)가 자율 주행 시뮬레이션에 이 기술을 도입했다는 소식이 전해졌습니다.
스탠포드 대학교의 페이페이 리(Fei-Fei Li) 교수가 설립한 월드 랩스(World Labs)는 2025년 11월 상용 제품인 마블(Marble)을 발표했습니다. 마블은 텍스트, 이미지 또는 비디오 조각에서 지속적이고 다운로드 가능한 3D 환경(가우시안 스플래팅, 메시 또는 비디오 형식으로 내보내기 가능)을 생성합니다. 2026년 6월에 발표된 에세이에서 Li는 월드 모델을 기능적으로 세 가지 범주로 분류했습니다. 렌더러(Renderer)(인간의 눈으로 볼 수 있는 비디오를 출력), 시뮬레이터(Simulator)(프로그램이 계산에 사용할 수 있는 기하학적, 물리적으로 정확한 표현을 출력), 플래너(Planner)(관찰 및 목표를 기반으로 다음 행동을 출력)입니다. Sora와 Genie 같은 비디오 생성 시스템은 렌더러에, 로봇 학습 동역학 모델은 시뮬레이터에, VLA는 플래너에 더 가깝다고 볼 수 있습니다.
NVIDIA Cosmos: 로봇 공학을 위한 월드 파운데이션 모델
로봇 공학 업계에서 주목받고 있는 접근 방식 중 하나는 NVIDIA의 Cosmos 시리즈입니다. 2026년 6월에 발표된 Cosmos 3는 시각적 추론, 월드 생성, 행동 예측을 단일 모델로 통합하는 혼합형 트랜스포머 아키텍처를 채택하여 텍스트, 이미지, 비디오, 환경 오디오, 행동 등 다양한 모달리티를 단일 프레임워크 내에서 처리합니다. 목표는 데이터 생성 파이프라인을 구축하는 것입니다. 실제 로봇 팔에서 수천 시간 동안 실험을 진행하는 대신, 로봇이 작업을 수행하는 모습을 시뮬레이션한 대량의 비디오를 생성하고, 해당 데이터를 기반으로 정책을 학습시킨 후 실제 하드웨어에 배포하는 방식입니다. NVIDIA는 Agile Robots, Black Forest Labs, Runway, Skild AI 등과 함께 Cosmos Coalition을 결성하여 World Foundation Models를 위한 개방형 생태계를 구축하고 있습니다.
생성형인가 아닌가: LeCun의 JEPA, 대안
Sora, Genie, Cosmos의 공통점은 픽셀(또는 픽셀에 가까운 표현)을 직접 생성하는 설계 방식입니다. Meta AI의 전 최고 AI 과학자였던 Yann LeCun은 이러한 생성형 접근 방식 자체에 대해 지속적으로 회의적인 입장을 취해왔습니다. 그가 제안한 JEPA(Joint Embedding Predictive Architecture)는 추상적인 표현 공간 내에서 예측만 하고 픽셀이나 토큰을 생성하지 않음으로써 이러한 접근 방식과 명확한 경계를 긋습니다. 이러한 설계 철학을 기반으로 구축된 V-JEPA 2는 약 백만 시간 분량의 인터넷 비디오로 사전 학습하고 단 62시간 분량의 로봇 조작 데이터로 미세 조정을 거쳐 제로샷 로봇 조작 작업에서 약 80%의 성공률을 달성한 것으로 알려져 있습니다. 르쿤은 2026년 초 메타를 떠나 파리에 AMI Labs를 설립하고 10억 달러가 넘는 시드 펀딩을 유치하여 범용 월드 모델 구축에 집중했습니다. 그는 현재 "생성형 모델은 월드 모델로서 막다른 길이다"라는 자신의 주장을 시험하는 단계에 접어들었습니다.
2026년 현재, 생성형과 비생성형(JEPA 방식) 접근 방식 중 어느 것이 더 우수한지는 아직 결정되지 않았습니다. 생성형 모델은 사람이 직접 눈으로 평가할 수 있는 비디오를 생성한다는 장점이 있는 반면, JEPA 방식은 추상적인 표현으로 예측함으로써 계산 효율성과 장기 예측 안정성 측면에서 우위를 점한다고 알려져 있습니다. 그러나 어느 쪽도 대규모 실제 환경에서 결정적인 우위를 입증하지는 못했습니다.
해결해야 할 과제: 물리적 일관성, 장기적인 일관성 유지, 그리고 평가
물리적 일관성: 소라가 생성한 영상에서는 물리 법칙을 위반하는 구체적인 사례들이 다수 발견되었습니다. 중력을 무시하고 떠다니는 물체, 움직이지 않는 촛불, 다리 개수가 잘못된 개미, 유리가 깨질 때 파편의 움직임 등이 그 예입니다. 분석 결과, 아무리 강력한 모델이라도 중력, 물체의 영속성, 그리고 인과적 일관성 측면에서 한계를 보였습니다. 현재로서는 소라 2가 3D 구조와 물리적 인과관계에 대해 "무언가"를 학습한 것은 분명하지만, 그것이 기존의 물리 엔진과는 다르다는 것이 객관적인 평가입니다.
장기적인 일관성: 환경의 상태가 수십 초 이상 지속되는 동안에도 무너지지 않고 유지될 수 있는지는 여전히 해결되지 않은 과제입니다. 2026년에 제안된 WorldRoamBench와 같은 평가 벤치마크는 동작 충실도, 시각적 오류(드리프트), 물리적 일관성, 메모리 일관성(이전에 방문한 위치와 객체를 기억하는지 여부)의 네 가지 축을 따라 장기적인 안정성을 평가하며, 기존의 많은 평가 방법들이 애초에 5~10초 정도의 짧은 시간 범위만을 고려했다는 점을 지적합니다.
평가 난이도: "좋은 월드 모델"을 정량적으로 측정하는 방법에 대한 합의도 아직 없습니다. 생성된 비디오의 시각적 자연스러움과 후속 로봇 제어 작업에서의 유용성이 반드시 일치하는 것은 아니며, 모델마다 출력의 의미론적 규모가 다르기 때문에 모델 간의 궤적을 공정하게 비교하기 어렵다는 지적이 있습니다.
계산 비용: 대규모 월드 모델을 평가하고 학습하는 데는 많은 비용이 소요됩니다. API 호출 한 번에 1달러 이상이 드는 것으로 알려져 있습니다. 장기적인 과제를 학습하고 평가하는 모델은 한 번의 응답에서 거의 10만 개의 토큰을 생성할 수 있는데, 이는 연구 재현성 자체에 걸림돌이 되고 있습니다.
로봇 학습과의 연결점
월드 모델이 로봇 공학에 직접 적용된 대표적인 예로는 1X Technologies가 자체 휴머노이드 로봇 NEO를 위해 개발한 비디오 월드 모델이 있습니다(자세한 내용은 "휴머노이드 로봇 기술 동향" 참조). 140억 개의 매개변수를 가진 비디오 생성 모델이 "과제 수행 과정을 담은 짧은 비디오"를 상상하고, 이를 역동학 모델을 통해 실제 모터 명령으로 변환하는 이 설계는 렌더러(비디오 생성)와 플래너(액션 생성)를 직접 연결하는 구체적인 사례입니다.
고전적인 강화 학습 맥락에서 모델 기반 강화 학습(MBRL)은 이러한 개념을 보다 체계적인 형태로 오랫동안 다뤄왔습니다. 상태 s와 행동 a로부터 다음 상태를 예측하는 세계 모델 \hat f_\theta의 학습 설계, 실제 하드웨어에 배포하기 전에 모델 내부에서 후보 행동 시퀀스를 평가하는 방법, 도메인 무작위화를 통해 예측 오류 누적을 처리하는 방법, 그리고 시뮬레이션에서 실제 환경으로 이동하는 단계별 프로세스 등 이 모든 내용은 "모델 기반 강화 학습 및 시뮬레이션-실제 환경 전환 소개"에서 자세히 다룹니다. 비디오 생성 방식의 세계 모델과 MBRL의 잠재 동역학 모델은 표현 해상도 수준은 다르지만, 핵심 아이디어는 동일합니다. 즉, 실제 하드웨어에서 모든 것을 시도하기 전에 학습된 모델 내부에서 먼저 시도해 보는 것입니다.
현재 상황
- 목표: 사람이 볼 수 있는 비디오/가상 환경: Sora, Genie 3, World Labs의 Marble과 같은 생성형 세계 모델. 시각적으로는 매력적이지만 물리적 정확성은 보장되지 않습니다.
- 목표: 로봇 정책 학습 및 평가를 위한 데이터 생성: NVIDIA Cosmos 및 1X World Model과 같은 설계는 비디오 생성 기술을 로봇 동작 생성에 직접 연결합니다. 실제 하드웨어 데이터 수집의 병목 현상을 완화할 것으로 기대됩니다.
- 목표: 모델 기반 강화 학습을 위한 내부 시뮬레이터: DreamerV3 계열의 잠재 동역학 모델. 계산량이 비교적 적고 정책 학습 루프에 직접 쉽게 통합할 수 있지만 처리할 수 있는 관측치의 복잡성에는 한계가 있습니다.
- 목표: 표현 학습 및 범용 예측: V-JEPA 계열의 비생성적 접근 방식. 픽셀 생성 비용을 피하면서 하위 작업으로의 전이 성능을 추구합니다.
이러한 모든 추세는 환경의 역동성을 학습을 통해 내재화한다는 동일한 기반 위에 구축되어 있지만, 출력 대상(인간, 프로그램 또는 정책 학습 루프)에 따라 분기됩니다. 이것이 2026년 현재 현실입니다.
현실적인 미래 영상은 정확한 물리적 예측을 가능하게 합니까?
시각적 개연성과 행동 조건부 역학은 다릅니다.
동일한 동작 하에서 예측된 상태 변화와 실제 전환을 비교합니다.참고 자료
- 월드 모델, 원 논문 (Ha & Schmidhuber, 2018)
- 드리머 공식 블로그 (구글 리서치)
- 드리머V3 논문, "월드 모델을 통한 다양한 제어 작업 마스터하기" (네이처)
- 비디오 생성 모델을 월드 시뮬레이터로 활용하기 (OpenAI, 공식)
- 지니 3: 월드 모델의 새로운 지평 (구글 딥마인드, 공식)
- 지니 2: 대규모 기반 월드 모델 (구글 딥마인드, 공식)
- 월드 랩스 마블 발표 (테크크런치)
- 세계 모델의 기능적 분류 체계 (Fei-Fei Li, 공식 블로그)
- NVIDIA Cosmos 3 발표 (NVIDIA 뉴스룸)
- V-JEPA (Meta AI, 공식)
- WorldRoamBench 논문 (arXiv)
- 모델 기반 강화 학습 및 시뮬레이션-실제 변환에 대한 자세한 내용은 "모델 기반 강화 학습 및 시뮬레이션-실제 변환 소개"도 참조하세요.
댓글
먼저 로그인해 주세요.
아직 데이터가 없습니다.