Contents — find the section you need
Model Dunia adalah istilah umum untuk model yang belajar memprediksi bagaimana keadaan lingkungan akan berubah ketika agen mengambil tindakan a. Dalam robotika dan pembelajaran penguatan, ia berfungsi sebagai simulator internal untuk "mencoba berbagai hal di dalam pikiran Anda sebelum bertindak di dunia nyata"; dalam konteks AI pembuatan video, ia berfungsi sebagai dasar untuk "tidak hanya menghasilkan video yang tampak masuk akal, tetapi juga mensimulasikan lingkungan itu sendiri sesuai dengan hukum fisika." Ini adalah konsep yang telah menarik perhatian yang berkembang pesat selama beberapa tahun terakhir dari kedua arah.
 NVIDIA Cosmos
Gambar: NVIDIA logo, Wikimedia Commons. Ditampilkan di sini sebagai perusahaan yang mengembangkan seri Cosmos dari Model Fondasi Dunia untuk AI fisik.

Model Dunia dalam Satu Diagram
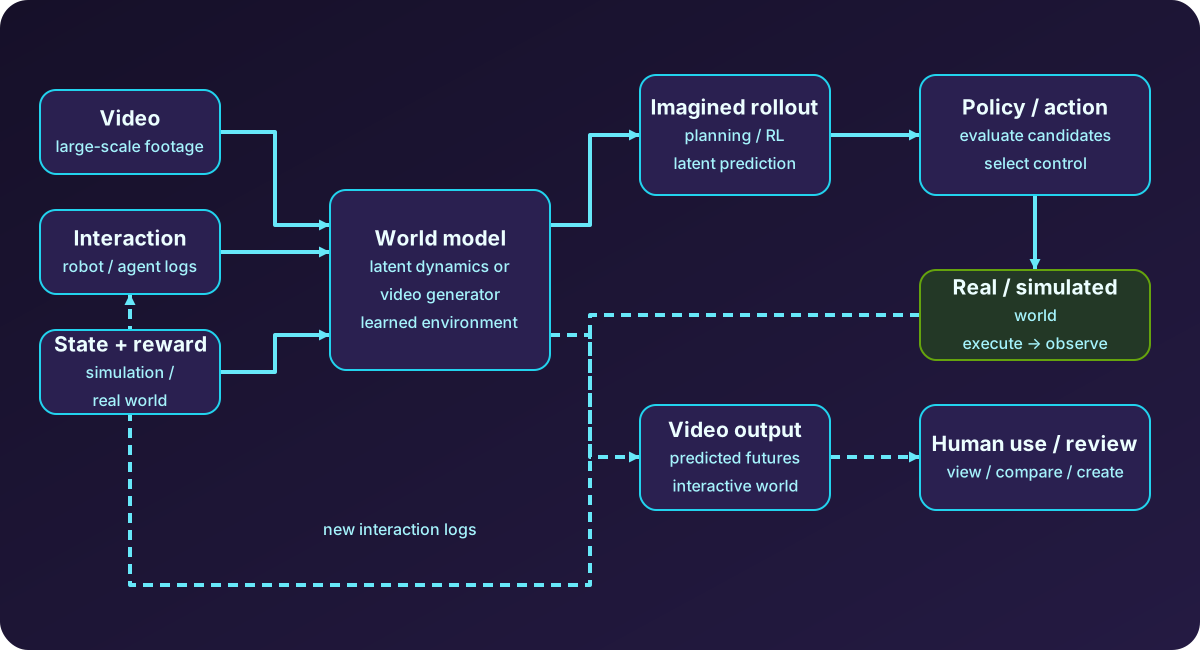
Diagram: dibuat oleh Duskcoil. Diagram tunggal yang disederhanakan yang menggabungkan penggunaan sebagai simulator internal untuk pembelajaran penguatan berbasis model dengan penggunaan sebagai model pembuatan video.
Sumbu untuk memahami Model Dunia terbagi menjadi dua pertanyaan: apa yang diprediksi (piksel video mentah, atau representasi laten terkompresi), dan untuk apa itu digunakan (simulator internal untuk pembelajaran kebijakan, atau pembuatan video untuk ditonton manusia). Istilah "Model Dunia" yang sama dapat merujuk pada model dinamika laten probabilistik yang mendasari pembelajaran simulasi-ke-nyata robot, seperti pada Dreamer, atau pada model pembangkitan video dengan puluhan miliar parameter, seperti pada Sora atau Genie — ini adalah bidang di mana diskusi dapat saling tumpang tindih jika konteksnya tidak dipahami dengan benar.
Silsilah: Dari Makalah Asli Ha & Schmidhuber hingga DreamerV3
Titik di mana istilah "Model Dunia" menyebar dalam pengertiannya saat ini berawal dari makalah tahun 2018 oleh David Ha dan Jürgen Schmidhuber. Dalam pengaturan mereka, VAE (variational autoencoder) mengompres pengamatan visual menjadi representasi yang ringkas, dan RNN (LSTM) memprediksi bagaimana representasi tersebut berubah seiring waktu; mereka menunjukkan bahwa agen dapat melatih kebijakan sepenuhnya "di dalam" ruang laten yang dipelajari ini.
Desain ini ditingkatkan secara substansial dalam PlaNet pada tahun 2019, yang RSSM (Recurrent State-Space Model) menggabungkan komponen deterministik dan stokastik untuk secara signifikan meningkatkan akurasi dan konsistensi prediksi multi-langkah. Jika PlaNet menyelesaikan ulang rencana pada setiap langkah sebagai kontrol prediktif model (MPC), Dreamer selanjutnya melangkah lebih jauh, mempelajari kebijakan (aktor) dan fungsi nilai (kritik) secara langsung melalui backpropagation di dalam model dunia — sebuah desain yang menjadi templat dasar untuk "keluarga Dreamer" sejak saat itu. DreamerV2 memperkenalkan representasi laten diskrit, dan DreamerV3, yang diterbitkan di Nature pada tahun 2025, menunjukkan kinerja yang dapat digeneralisasikan di berbagai domain — termasuk penambangan berlian di Minecraft — tanpa penyetelan hyperparameter tetap, secara substansial meningkatkan standar untuk kegunaan praktis model dunia dalam pembelajaran penguatan berbasis model.
Konvergensi dari Sisi AI Generatif: Sora, Genie, World Labs
Terpisah dari garis keturunan pembelajaran penguatan (reinforcement learning), istilah "Model Dunia" juga mulai digunakan dari sisi AI pembangkit video. Pada tahun 2024, OpenAI berpendapat dalam laporan teknisnya tentang model pembangkit video Sora bahwa "penskalaan model pembangkit video merupakan jalur yang menjanjikan untuk membangun simulator dunia fisik serbaguna," dengan mengutip contoh seperti sapuan cat yang tetap ada di kanvas dan bekas gigitan yang tersisa setelah seseorang makan hamburger, sebagai bukti bahwa Sora secara implisit telah mempelajari beberapa aspek hukum fisika dan kausalitas.
Seri Genie dari Google DeepMind mendorong arah ini lebih jauh: pada Desember 2024, Genie 2 menunjukkan kemampuannya untuk menghasilkan lingkungan 3D yang dapat dikontrol dari satu gambar, dan pada Agustus 2025, Genie 3 dapat menghasilkan dunia 3D yang dapat dieksplorasi secara real-time, berdurasi beberapa menit, dari perintah teks, dengan kecepatan 24 frame per detik dan resolusi 720p. DeepMind memposisikan ini sebagai cara yang terukur untuk menghasilkan data pelatihan untuk navigasi, persepsi, dan penalaran jangka panjang dalam robotika, dan pada Februari 2026 dilaporkan bahwa Waymo telah mengadopsi teknologi ini untuk simulasi mengemudi otonom.
World Labs, yang didirikan oleh Fei-Fei Li dari Stanford, mengumumkan produk komersialnya, Marble, pada November 2025. Marble menghasilkan lingkungan 3D yang persisten dan dapat diunduh (dapat diekspor sebagai Gaussian Splatting, mesh, atau video) dari fragmen teks, gambar, atau video. Dalam esai yang diterbitkan Li pada Juni 2026, ia mengklasifikasikan Model Dunia secara fungsional ke dalam tiga kategori: Renderer (menghasilkan video untuk dilihat mata manusia), Simulator (menghasilkan representasi geometris dan fisik yang akurat yang dapat digunakan program untuk komputasi), dan Planner (menghasilkan tindakan selanjutnya dari pengamatan dan tujuan) — menempatkan sistem pembangkitan video seperti Sora dan Genie lebih dekat ke Renderer, model dinamika pembelajaran robot lebih dekat ke Simulator, dan VLA lebih dekat ke Planner.
NVIDIA Cosmos: Model Fondasi Dunia untuk Robotika
Pendekatan yang semakin populer dari sisi industri robotika adalah seri Cosmos dari NVIDIA. Cosmos 3, yang diumumkan pada Juni 2026, mengadopsi arsitektur campuran transformator yang menyatukan penalaran visual, pembangkitan dunia, dan prediksi tindakan ke dalam satu model, menangani berbagai modalitas — teks, gambar, video, audio lingkungan, dan tindakan — dalam satu kerangka kerja. Tujuannya adalah sebuah alur kerja pembangkitan data: alih-alih menjalankan ribuan jam percobaan pada lengan robot sungguhan, hasilkan sejumlah besar video simulasi robot yang melakukan suatu tugas, latih kebijakan pada data tersebut, dan kemudian terapkan ke perangkat keras sungguhan. NVIDIA telah membentuk Cosmos Coalition dengan mitra termasuk Agile Robots, Black Forest Labs, Runway, dan Skild AI, membangun ekosistem terbuka untuk World Foundation Models.
Generatif atau Tidak: JEPA LeCun sebagai Sumbu Kontra
Yang dimiliki Sora, Genie, dan Cosmos adalah desain yang secara langsung menghasilkan piksel (atau representasi yang mendekati piksel). Yann LeCun, mantan Kepala Ilmuwan AI di Meta AI, secara konsisten mengambil sikap skeptis terhadap pendekatan generatif ini. JEPA (Joint Embedding Predictive Architecture) yang diusulkannya adalah desain yang menarik garis yang jelas dengan memprediksi dalam ruang representasi abstrak dan tidak pernah menghasilkan piksel atau token. V-JEPA 2, yang dibangun berdasarkan filosofi desain ini, dilaporkan telah mencapai sekitar 80% keberhasilan pada tugas manipulasi robot tanpa pelatihan awal (zero-shot) setelah pelatihan awal pada sekitar satu juta jam video internet dan penyempurnaan (fine-tuning) hanya pada 62 jam data manipulasi robot. LeCun meninggalkan Meta pada awal tahun 2026, mendirikan AMI Labs di Paris, dan mengumpulkan pendanaan awal melebihi satu miliar dolar untuk fokus membangun Model Dunia serbaguna — memasuki fase di mana ia sekarang menguji klaimnya sendiri, bahwa "model generatif adalah jalan buntu sebagai Model Dunia."
Hingga tahun 2026, pendekatan generatif dan non-generatif (gaya JEPA) mana yang lebih unggul masih belum diputuskan. Model generatif memiliki kekuatan dalam menghasilkan video yang dapat dievaluasi langsung oleh manusia, sementara pendekatan gaya JEPA dikatakan memiliki keunggulan dalam efisiensi komputasi dan stabilitas prediksi jangka panjang dengan memprediksi dalam representasi abstrak — tetapi belum ada pihak yang menunjukkan keunggulan yang menentukan pada penerapan skala besar di dunia nyata.
Tantangan Terbuka: Konsistensi Fisik, Koherensi Jangka Panjang, dan Evaluasi
Konsistensi Fisik: Banyak contoh konkret pelanggaran hukum fisika telah ditunjukkan dalam video yang dihasilkan Sora — objek yang melayang sambil mengabaikan gravitasi, nyala lilin yang tidak bergerak, semut dengan jumlah kaki yang salah, perilaku pecahan yang tidak wajar ketika kaca pecah. Analisis telah menunjukkan bahwa bahkan model yang kuat pun gagal dalam hal gravitasi, permanensi objek, dan konsistensi kausal, dan penilaian netral pada titik ini adalah bahwa meskipun Sora 2 jelas telah mempelajari "sesuatu" tentang struktur 3D dan kausalitas fisik, sesuatu itu tidak sama dengan mesin fisika konvensional.
Koherensi Jangka Panjang: Apakah keadaan suatu lingkungan dapat dipertahankan tanpa mengalami kerusakan selama durasi lebih dari puluhan detik tetap menjadi tantangan yang belum terselesaikan. Tolok ukur evaluasi yang diusulkan pada tahun 2026, seperti WorldRoamBench, menilai stabilitas jangka panjang di sepanjang empat sumbu — fidelitas aksi, kerusakan visual (pergeseran), konsistensi fisik, dan konsistensi memori (apakah lokasi dan objek yang sebelumnya dikunjungi diingat) — dan menunjukkan bahwa banyak metode evaluasi yang ada hanya melihat jendela waktu singkat 5–10 detik saja.
Kesulitan evaluasi: Belum ada konsensus tentang bagaimana mengukur secara kuantitatif "model dunia yang baik." Kealamian visual video yang dihasilkan dan kegunaannya pada tugas kontrol robot selanjutnya tidak selalu selaras, dan karena skala semantik keluaran berbeda di berbagai model, telah dikemukakan bahwa membandingkan lintasan secara adil di berbagai model itu sulit.
Biaya komputasi: Mengevaluasi dan melatih model dunia skala besar itu mahal — satu panggilan API dilaporkan dapat menghabiskan biaya lebih dari satu dolar. Model yang mempelajari dan mengevaluasi tugas jangka panjang dapat menghasilkan hampir 100.000 token dalam satu respons, yang menjadi penghalang bagi reproduksibilitas penelitian itu sendiri.
Titik Penghubung dengan Pembelajaran Robot
Contoh utama penerapan langsung Model Dunia pada robotika adalah Model Dunia video yang dikembangkan oleh 1X Technologies untuk robot humanoid mereka sendiri, NEO (lihat "Tren Teknologi dalam Robot Humanoid" untuk detailnya). Desain di mana model pembangkitan video dengan 14 miliar parameter membayangkan "video singkat tentang tugas yang sedang diselesaikan," yang kemudian dikonversi menjadi perintah motorik aktual melalui Model Dinamika Terbalik, adalah contoh konkret menghubungkan Renderer (pembangkitan video) langsung ke Planner (pembangkitan aksi).
Dalam konteks pembelajaran penguatan klasik, pembelajaran penguatan berbasis model (MBRL) telah menangani konsep ini dalam bentuk yang lebih mendasar selama bertahun-tahun. Desain pembelajaran model dunia \hat f_\theta yang memprediksi keadaan selanjutnya dari keadaan s dan aksi a, mengevaluasi urutan aksi kandidat di dalamnya sebelum diterapkan ke perangkat keras nyata, bagaimana akumulasi kesalahan prediksi ditangani melalui pengacakan domain, dan proses bertahap untuk beralih dari simulasi ke nyata — semua ini dibahas secara detail dalam "Pengantar Pembelajaran Penguatan Berbasis Model dan Simulasi ke Nyata." Model Dunia bergaya generasi video dan model dinamika laten MBRL beroperasi pada tingkat resolusi representasional yang berbeda, tetapi mereka memiliki ide inti yang sama: mencobanya di dalam model yang telah dipelajari sebelum mencoba semuanya pada perangkat keras nyata.
Kondisi Saat Ini
- Tujuan: lingkungan video/virtual untuk dilihat manusia: Model Dunia Generatif seperti Sora, Genie 3, dan Marble dari World Labs. Menarik secara visual, tetapi ketelitian fisik tidak dijamin
- Tujuan: menghasilkan data untuk pembelajaran dan evaluasi kebijakan robot: Desain seperti NVIDIA Cosmos dan 1X World Model, yang menghubungkan teknologi pembuatan video langsung ke pembuatan aksi robot. Diharapkan dapat mengurangi hambatan dalam pengumpulan data perangkat keras nyata
- Tujuan: simulator internal untuk pembelajaran penguatan berbasis model: Model dinamika laten keluarga DreamerV3. Relatif ringan secara komputasi dan mudah disematkan langsung ke dalam loop pembelajaran kebijakan, tetapi terbatas dalam kompleksitas pengamatan yang dapat mereka tangani
- Tujuan: pembelajaran representasi dan prediksi tujuan umum: Pendekatan non-generatif dalam keluarga V-JEPA. Hindari biaya pembuatan piksel sambil mengejar kinerja transfer ke tugas hilir
Setiap tren ini berdiri di atas fondasi yang sama — menginternalisasi dinamika lingkungan melalui pembelajaran — sementara bercabang berdasarkan apa yang mereka hasilkan dan untuk siapa (atau apa) mereka menghasilkan: manusia, program, atau loop pembelajaran kebijakan. Itulah realita pada tahun 2026.
Apakah video masa depan yang realistis menghasilkan prediksi fisik yang akurat?
Kemungkinan visual dan dinamika yang dikondisikan oleh tindakan berbeda.
Bandingkan perubahan keadaan yang diprediksi dengan transisi aktual di bawah tindakan yang sama.Referensi
- World Models, makalah asli (Ha & Schmidhuber, 2018)
- Blog resmi Dreamer (Google Research)
- Makalah DreamerV3, "Menguasai beragam tugas kontrol melalui model dunia" (Nature)
- Model generasi video sebagai simulator dunia (OpenAI, resmi)
- Genie 3: Batasan baru untuk model dunia (Google DeepMind, resmi)
- Genie 2: Model dunia dasar skala besar (Google DeepMind, resmi)
- Pengumuman World Labs Marble (TechCrunch)
- Taksonomi Fungsional Model Dunia (Fei-Fei Li, blog resmi)
- Pengumuman NVIDIA Cosmos 3 (NVIDIA Newsroom)
- V-JEPA (Meta AI, resmi)
- Makalah WorldRoamBench (arXiv)
- Untuk detail tentang pembelajaran penguatan berbasis model dan simulasi-ke-nyata, lihat juga "Pengantar Pembelajaran Penguatan Berbasis Model dan Simulasi-ke-Nyata"
Komentar
Silakan masuk terlebih dahulu.
Belum ada data.