Contents — find the section you need
世界模型是一个通用术语,指的是一种能够预测智能体采取动作时环境状态如何转变的模型。在机器人学和强化学习中,它充当内部模拟器,用于“在现实世界中行动之前先在脑海中进行尝试”;在视频生成人工智能领域,它不仅是“生成逼真视频,而且根据物理定律模拟环境本身”的基础。近年来,这一概念在各个方面都迅速引起了越来越多的关注。
 NVIDIA Cosmos
图片:NVIDIA logo, Wikimedia Commons.

此处重点介绍的是开发 Cosmos 系列物理人工智能世界基础模型的公司。
世界模型概览
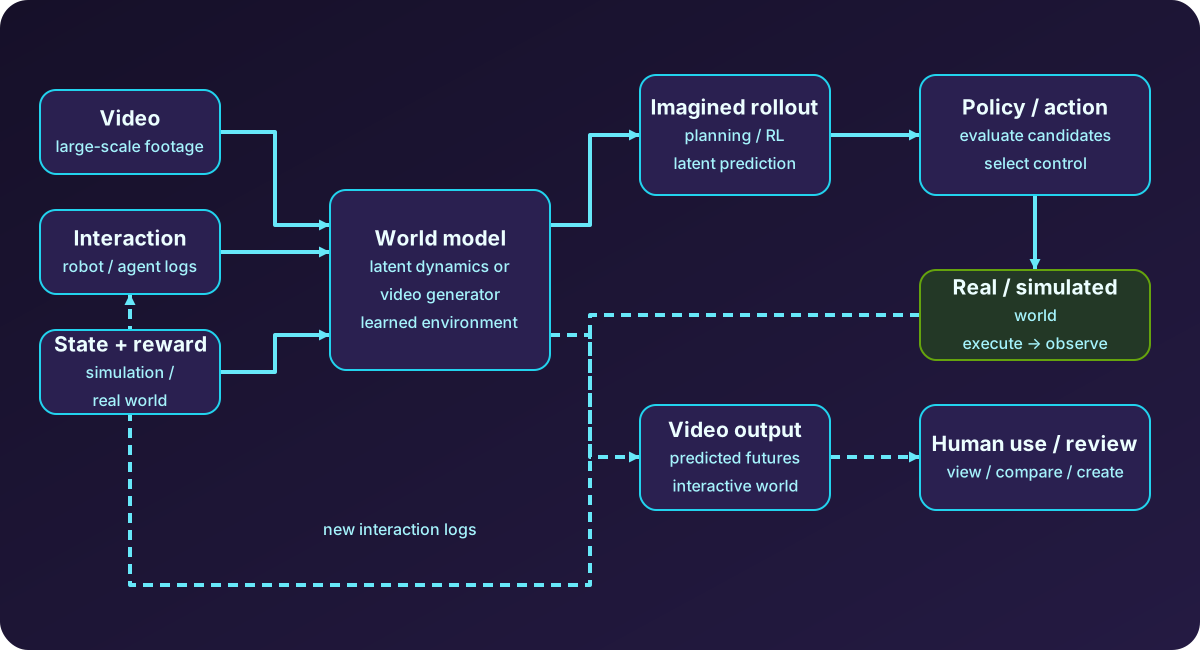
图表:由 Duskcoil 创建。一个简化的单图,结合了作为基于模型的强化学习的内部模拟器和作为视频生成模型的两种用途。
理解世界模型的关键在于两个问题:预测的是什么(原始视频像素,或压缩的潜在表示),以及它的用途(用于策略学习的内部模拟器,或生成供人类观看的视频)。 “世界模型”一词既可以指支撑机器人从模拟到现实学习的概率潜在动力学模型(例如 Dreamer),也可以指拥有数百亿个参数的视频生成模型(例如 Sora 或 Genie)。在这个领域,如果上下文不清晰,讨论很容易陷入无意义的争论。
沿革:从 Ha 和 Schmidhuber 的原始论文到 DreamerV3
“世界模型”一词以目前的含义传播开来,可以追溯到 David Ha 和 Jürgen Schmidhuber 于 2018 年发表的一篇论文。在他们的模型中,变分自编码器 (VAE) 将视觉观测压缩成紧凑的表示,而循环神经网络 (RNN)(长短期记忆网络,LSTM)则预测该表示随时间的变化;他们证明,智能体可以完全“在”这个学习到的潜在空间内训练策略。
2019 年的 PlaNet 对这一设计进行了大幅改进,其 RSSM(循环状态空间模型)结合了确定性和随机性组件,显著提高了多步预测的准确性和一致性。PlaNet 在每一步都重新求解策略,即模型预测控制 (MPC),而后续的 Dreamer 则更进一步,直接在世界模型内部通过反向传播学习策略(actor)和价值函数(critic)——这一设计此后成为“Dreamer 系列”的基本模板。DreamerV2 引入了离散潜在表示,而于 2025 年发表在《自然》杂志上的 DreamerV3 则展现了跨多个领域的泛化性能——包括在 Minecraft 中挖掘钻石——且无需固定的超参数调优,这极大地提高了基于模型的强化学习中世界模型的实际应用价值。
生成式人工智能领域的融合:Sora、Genie、World Labs
除了强化学习之外,“世界模型”这一术语也开始出现在视频生成人工智能领域。2024年,OpenAI在其关于视频生成模型Sora的技术报告中指出,“扩展视频生成模型是构建通用物理世界模拟器的一条很有前景的途径”,并列举了诸如画布上残留的笔触和汉堡包上留下的咬痕等例子,以此证明Sora已经隐式地学习了物理定律和因果关系的一些方面。
谷歌DeepMind的Genie系列进一步推动了这一方向的发展:2024年12月,Genie 2展示了其能够从单张图像生成可控的3D环境;到2025年8月,Genie 3能够根据文本提示,以每秒24帧、720p分辨率生成持续数分钟的实时可探索3D世界。DeepMind将此定位为一种可扩展的方式,用于生成机器人导航、感知和长时程推理的训练数据。2026年2月,据报道,Waymo已将该技术应用于自动驾驶模拟。
由斯坦福大学李飞飞创立的World Labs于2025年11月发布了其商业产品Marble。Marble能够从文本、图像或视频片段生成持久的、可下载的3D环境(可导出为高斯散射、网格或视频格式)。李在2026年6月发表的一篇文章中,将世界模型按功能分为三类:渲染器(输出供人眼观看的视频)、模拟器(输出几何和物理上忠实还原的表示,供程序进行计算)和规划器(根据观察结果和目标输出下一步动作)。她将Sora和Genie等视频生成系统归类为渲染器,将机器人学习动力学模型归类为模拟器,而将VLA归类为规划器。
NVIDIA Cosmos:机器人世界基础模型
NVIDIA的Cosmos系列正在机器人行业中崭露头角。Cosmos 3于2026年6月发布,采用混合Transformer架构,将视觉推理、世界生成和动作预测统一到一个模型中,并在单一框架内处理多种模态——文本、图像、视频、环境音频和动作。目标是构建一个数据生成流程:无需在真实的机械臂上运行数千小时的试验,而是生成大量机器人执行任务的模拟视频,基于这些数据训练策略,然后将其部署到真实硬件上。NVIDIA 已与 Agile Robots、Black Forest Labs、Runway 和 Skild AI 等合作伙伴组建了 Cosmos 联盟,旨在为世界基础模型构建一个开放的生态系统。
生成式还是非生成式:LeCun 的 JEPA 作为反制方案
Sora、Genie 和 Cosmos 的共同之处在于它们都采用了直接生成像素(或与其接近的表示形式)的设计。Meta AI 的前首席人工智能科学家 Yann LeCun 一直对这种生成式方法持怀疑态度。他提出的 JEPA(联合嵌入预测架构)通过在抽象表示空间中进行预测,而非生成像素或标记,从而划清了界限。基于这种设计理念构建的 V-JEPA 2 据报道在对约一百万小时的互联网视频进行预训练,并仅使用 62 小时的机器人操作数据进行微调后,在零样本机器人操作任务中取得了约 80% 的成功率。LeCun 于 2026 年初离开 Meta,在巴黎创立了 AMI Labs,并筹集了超过十亿美元的种子资金,专注于构建通用世界模型——他现在正着手验证自己“生成模型作为世界模型是死胡同”的论断。
截至 2026 年,生成式和非生成式(JEPA 式)方法孰优孰劣仍未有定论。生成式模型的优势在于能够生成人类可以直接用肉眼评估的视频,而 JEPA 式方法则因其在抽象表示中进行预测而被认为在计算效率和长期预测稳定性方面具有优势——但双方都尚未在大规模实际部署中展现出决定性的优势。
开放性挑战:物理一致性、长期稳定性与评估
物理一致性:在Sora生成的视频中,已经指出了许多违反物理定律的具体例子——物体无视重力漂浮、蜡烛火焰静止不动、蚂蚁腿数错误、玻璃破碎时碎片运动异常。分析表明,即使是强大的模型在重力、物体恒存性和因果一致性方面也存在缺陷。目前的客观评价是,虽然Sora 2显然已经掌握了一些关于3D结构和物理因果关系的知识,但这些知识与传统的物理引擎并不相同。
长期稳定性:环境状态能否在数十秒以上的时间内保持稳定,仍然是一个尚未解决的挑战。 2026 年提出的评估基准,例如 WorldRoamBench,从四个维度评估长期稳定性:动作保真度、视觉崩溃(漂移)、物理一致性和记忆一致性(是否记住先前访问过的位置和物体)。这些基准指出,许多现有的评估方法最初只关注 5-10 秒的短窗口。
评估难度:目前对于如何定量衡量“优秀的世界模型”尚未达成共识。生成视频的视觉自然度及其在下游机器人控制任务中的实用性并不一定一致,而且由于不同模型的输出语义尺度不同,因此有人指出,难以公平地比较不同模型的轨迹。
计算成本:评估和训练大规模世界模型成本高昂——据报道,一次 API 调用就可能花费超过一美元。学习和评估长时程任务的模型在单次响应中可以生成近 10 万个标记,这本身已成为研究可重复性的一大障碍。
与机器人学习的联系
世界模型直接应用于机器人领域的一个典型例子是 1X Technologies 为其人形机器人 NEO 开发的视频世界模型(详情请参见“人形机器人技术趋势”)。该设计中,一个拥有 140 亿参数的视频生成模型会“想象一段完成任务的短视频”,然后通过逆动力学模型将其转换为实际的运动指令。这是一个将渲染器(视频生成)直接连接到规划器(动作生成)的具体示例。
在经典的强化学习领域,基于模型的强化学习 (MBRL) 多年来一直以更实际的方式处理这一概念。学习世界模型 \hat f_\theta 的设计,该模型能够根据状态 s 和动作 a 预测下一个状态;在部署到真实硬件之前,评估模型内部的候选动作序列;如何通过域随机化处理预测误差累积;以及从模拟环境到真实环境的分阶段过渡——所有这些都在基于模型的强化学习和模拟到真实环境的过渡简介中进行了详细介绍。视频生成式世界模型和基于模型的强化学习的潜在动态模型在不同的表征分辨率级别上运行,但它们的核心思想相同:在真实硬件上进行所有尝试之前,先在已学习的模型中进行测试。
现状
-
目标:为人类提供视频/虚拟环境:生成式世界模型,例如 Sora、Genie 3 和 World Labs 的 Marble。视觉效果引人注目,但物理严谨性无法保证
-
目标:为机器人策略学习和评估生成数据:NVIDIA Cosmos 和 1X World Model 等设计将视频生成技术直接与机器人动作生成相结合。有望缓解真实硬件数据采集的瓶颈。
-
目标:基于模型的强化学习的内部模拟器:DreamerV3 系列潜在动力学模型。计算量相对较小,易于直接嵌入策略学习循环,但其可处理的观测复杂度有限。
-
目标:表征学习和通用预测:V-JEPA 系列的非生成方法。避免像素生成的开销,同时追求向下游任务的迁移性能。
所有这些趋势都基于同一基础——通过学习将环境动态内化——但它们根据输出内容以及输出对象(人、程序或策略学习循环)的不同而有所区别。这就是2026年的真实情况。
逼真的未来视频能否建立准确的物理预测?
视觉合理性和动作条件动力学有所不同。
比较相同动作下预测的状态变化与实际状态转换。参考资料
-
[World Labs Marble 公告] (TechCrunch)](https://techcrunch.com/2025/11/12/fei-fei-lis-world-labs-speeds-up-the-world-model-race-with-marble-its-first-commercial-product/)
-
有关基于模型的强化学习和模拟到现实的详细信息,另请参阅基于模型的强化学习和模拟到现实简介"
评论
请先登录。
暂无数据。