Contents — find the section you need
Un modello del mondo è un termine generico per un modello che impara a prevedere come lo stato di un ambiente cambierà quando un agente intraprende un'azione a. Nella robotica e nell'apprendimento per rinforzo, funziona come un simulatore interno per "provare le cose mentalmente prima di agire nel mondo reale"; nel contesto dell'IA per la generazione di video, funge da base non solo per generare video dall'aspetto plausibile, ma anche per simulare l'ambiente stesso secondo le leggi fisiche. È un concetto che ha attirato rapidamente sempre più attenzione negli ultimi anni da entrambe le direzioni.
 NVIDIA Cosmos
Immagine: NVIDIA logo, Wikimedia Commons. Presentata qui come l'azienda che sviluppa la serie Cosmos di Modelli Fondamentali Mondiali per l'IA fisica.

Modelli Mondiali in un unico diagramma
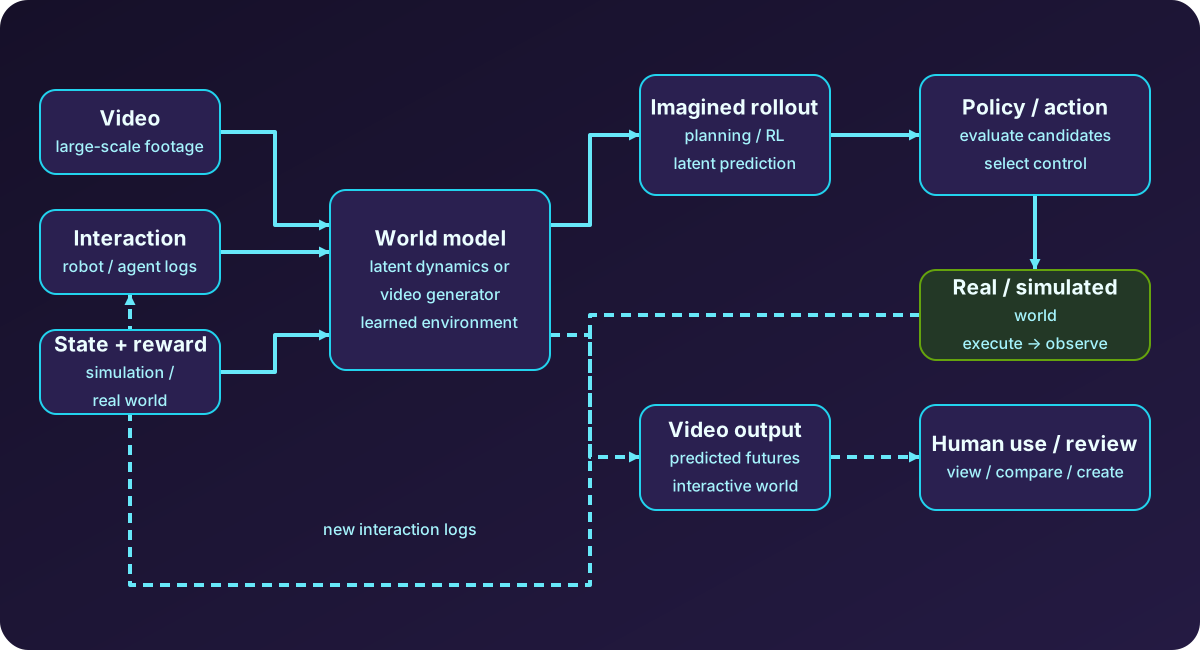
Diagramma: creato da Duskcoil. Un diagramma semplificato che combina l'utilizzo come simulatore interno per l'apprendimento per rinforzo basato su modelli con l'utilizzo come modello per la generazione di video.
L'asse per la comprensione dei Modelli Mondiali si divide in due domande: cosa viene previsto (pixel video grezzi o una rappresentazione latente compressa) e a cosa serve (un simulatore interno per l'apprendimento delle politiche o la generazione di video da visualizzare per un essere umano). Lo stesso termine "Modello del Mondo" può riferirsi a un modello di dinamica latente probabilistica che è alla base dell'apprendimento dalla simulazione alla realtà di un robot, come in Dreamer, oppure a un modello di generazione video con decine di miliardi di parametri, come in Sora o Genie: si tratta di un campo in cui le discussioni possono facilmente sovrapporsi se non si mantiene il giusto contesto.
Genealogia: dall'articolo originale di Ha e Schmidhuber a DreamerV3
Il termine "Modelli del Mondo" ha assunto il suo significato attuale a partire da un articolo del 2018 di David Ha e Jürgen Schmidhuber. Nella loro configurazione, un VAE (autoencoder variazionale) comprime le osservazioni visive in una rappresentazione compatta e una RNN (LSTM) prevede come tale rappresentazione cambia nel tempo; hanno dimostrato che un agente può addestrare una strategia interamente "all'interno" di questo spazio latente appreso.
Questo design è stato sostanzialmente migliorato in PlaNet nel 2019, il cui RSSM (Recurrent State-Space Model) ha combinato componenti deterministiche e stocastiche per migliorare significativamente l'accuratezza e la coerenza della previsione a più passi. Mentre PlaNet rielaborava un piano a ogni passo come controllo predittivo basato su modello (MPC), il successivo Dreamer ha fatto un ulteriore passo avanti, apprendendo una politica (attore) e una funzione di valore (critico) direttamente tramite retropropagazione all'interno del modello del mondo: un design che da allora è diventato il modello di base per la "famiglia Dreamer". DreamerV2 ha introdotto rappresentazioni latenti discrete e DreamerV3, pubblicato su Nature nel 2025, ha dimostrato prestazioni generalizzabili a diversi domini, tra cui l'estrazione di diamanti in Minecraft, senza necessità di ottimizzazione fissa degli iperparametri, alzando notevolmente l'asticella per l'utilità pratica dei modelli del mondo nell'apprendimento per rinforzo basato su modelli.
Convergenza dal lato dell'IA generativa: Sora, Genie, World Labs
Indipendentemente dalla tradizione dell'apprendimento per rinforzo, il termine "modello del mondo" ha iniziato ad essere utilizzato anche dal lato dell'IA per la generazione di video. Nel 2024, OpenAI sostenne nel suo rapporto tecnico sul modello di generazione video Sora che "la scalabilità dei modelli di generazione video rappresenta una strada promettente per la creazione di simulatori generici del mondo fisico", citando esempi come le pennellate di pittura che persistono su una tela e i segni di morsi che rimangono dopo aver mangiato un hamburger, come prova che Sora avesse implicitamente appreso alcuni aspetti delle leggi fisiche e della causalità.
La serie Genie di Google DeepMind ha ulteriormente spinto in questa direzione: nel dicembre 2024, Genie 2 ha dimostrato di poter generare un ambiente 3D controllabile a partire da una singola immagine e, nell'agosto 2025, Genie 3 è stato in grado di generare mondi 3D persistenti, esplorabili in tempo reale per diversi minuti, a partire da un input testuale, a 24 fotogrammi al secondo e con una risoluzione di 720p. DeepMind presenta questa tecnologia come un metodo scalabile per generare dati di addestramento per la navigazione, la percezione e il ragionamento a lungo termine nella robotica e, nel febbraio 2026, è stato riportato che Waymo aveva adottato questa tecnologia per la simulazione della guida autonoma.
World Labs, fondata da Fei-Fei Li di Stanford, ha annunciato il suo prodotto commerciale Marble nel novembre 2025. Marble genera ambienti 3D persistenti e scaricabili (esportabili come Gaussian Splatting, mesh o video) a partire da frammenti di testo, immagini o video. In un saggio pubblicato nel giugno 2026, Li ha classificato funzionalmente i modelli del mondo in tre categorie: Renderer (produce video visualizzabili dall'occhio umano), Simulator (produce una rappresentazione geometricamente e fisicamente fedele che un programma può utilizzare per i calcoli) e Planner (produce l'azione successiva a partire da osservazioni e un obiettivo), collocando i sistemi di generazione video come Sora e Genie più vicini al Renderer, i modelli di dinamica di apprendimento robotico più vicini al Simulatore e VLA più vicino al Pianificatore.
NVIDIA Cosmos: un modello di base per la robotica
Un approccio che sta guadagnando terreno nel settore della robotica è la serie Cosmos di NVIDIA. Cosmos 3, annunciato nel giugno 2026, adotta un'architettura "mixed-of-transformers" che unifica il ragionamento visivo, la generazione del mondo e la previsione delle azioni in un unico modello, gestendo diverse modalità (testo, immagini, video, audio ambientale e azioni) all'interno di un unico framework. L'obiettivo è una pipeline di generazione dati: invece di eseguire migliaia di ore di test su un braccio robotico reale, si generano grandi quantità di video simulati di un robot che esegue un compito, si addestra una policy su questi dati e la si implementa su hardware reale. NVIDIA ha formato la Cosmos Coalition con partner come Agile Robots, Black Forest Labs, Runway e Skild AI, costruendo un ecosistema aperto per i World Foundation Models.
Generativo o no: JEPA di LeCun come contro-asse
Ciò che Sora, Genie e Cosmos hanno in comune è un design che genera direttamente pixel (o una rappresentazione simile). Yann LeCun, ex responsabile scientifico per l'IA presso Meta AI, ha sempre mantenuto un atteggiamento scettico nei confronti di questo approccio generativo. La sua architettura JEPA (Joint Embedding Predictive Architecture) traccia una netta linea di demarcazione, basandosi sulla previsione all'interno di uno spazio di rappresentazione astratto e non generando mai pixel o token. V-JEPA 2, costruito su questa filosofia progettuale, avrebbe raggiunto circa l'80% di successo in compiti di manipolazione robotica zero-shot dopo un pre-addestramento su circa un milione di ore di video online e un fine-tuning su sole 62 ore di dati di manipolazione robotica. LeCun ha lasciato Meta all'inizio del 2026, ha fondato AMI Labs a Parigi e ha raccolto finanziamenti iniziali per oltre un miliardo di dollari per concentrarsi sulla costruzione di un modello del mondo di uso generale, entrando in una fase in cui sta mettendo alla prova la sua stessa affermazione, secondo cui "i modelli generativi sono un vicolo cieco come modelli del mondo".
Nel 2026, non è ancora stato stabilito quale approccio, tra quello generativo e quello non generativo (in stile JEPA), sia superiore. I modelli generativi hanno il vantaggio di produrre video che gli esseri umani possono valutare direttamente a occhio nudo, mentre gli approcci in stile JEPA si dice che abbiano un vantaggio in termini di efficienza computazionale e stabilità delle previsioni a lungo termine, grazie alla loro capacità di prevedere in una rappresentazione astratta; tuttavia, nessuno dei due approcci ha ancora dimostrato un vantaggio decisivo in implementazioni su larga scala nel mondo reale.
Sfide aperte: Coerenza fisica, coerenza a lungo termine e valutazione
Coerenza fisica: Numerosi esempi concreti di violazioni delle leggi fisiche sono stati evidenziati nei video generati da Sora: oggetti che fluttuano ignorando la gravità, una fiamma di candela immobile, una formica con un numero errato di zampe, un comportamento innaturale dei frammenti quando il vetro si frantuma. L'analisi ha dimostrato che anche i modelli più potenti falliscono in termini di gravità, permanenza degli oggetti e coerenza causale. La valutazione neutrale al momento è che, sebbene Sora 2 abbia chiaramente appreso "qualcosa" sulla struttura 3D e sulla causalità fisica, questo qualcosa non è lo stesso di un motore fisico convenzionale.
Coerenza a lungo termine: la questione se lo stato di un ambiente possa essere mantenuto senza deterioramenti per durate superiori a decine di secondi rimane una sfida irrisolta. I benchmark di valutazione proposti nel 2026, come WorldRoamBench, valutano la stabilità a lungo termine lungo quattro assi: fedeltà dell'azione, deterioramento visivo (deriva), coerenza fisica e coerenza della memoria (se le posizioni e gli oggetti visitati in precedenza vengono ricordati). Sottolineano inoltre che molti metodi di valutazione esistenti si sono concentrati inizialmente solo su brevi intervalli di tempo di 5-10 secondi.
Difficoltà di valutazione: non esiste ancora un consenso su come misurare quantitativamente un "buon modello del mondo". La naturalezza visiva del video generato e la sua utilità per le successive attività di controllo del robot non coincidono necessariamente, e poiché la scala semantica degli output varia a seconda del modello, è stato evidenziato che confrontare equamente le traiettorie tra i diversi modelli risulta difficile.
Costo computazionale: Valutare e addestrare modelli del mondo su larga scala è costoso: una singola chiamata API può costare più di un dollaro. I modelli che apprendono e valutano compiti a lungo termine possono generare quasi 100.000 token in una singola risposta, il che sta diventando un ostacolo alla riproducibilità della ricerca stessa.
Il punto di connessione con l'apprendimento robotico
Un esempio di spicco di applicazione diretta dei modelli del mondo alla robotica è il modello video World Model sviluppato da 1X Technologies per il proprio robot umanoide, NEO (vedi "Tendenze tecnologiche nei robot umanoidi" per i dettagli). Il design, in cui un modello di generazione video con 14 miliardi di parametri immagina "un breve video del completamento del compito", che viene poi convertito in comandi motori effettivi tramite un modello di dinamica inversa, è un esempio concreto di connessione diretta tra un Renderer (generazione video) e un Planner (generazione di azioni).
Nel contesto classico dell'apprendimento per rinforzo, l'apprendimento per rinforzo basato su modelli (MBRL) ha affrontato questo concetto in modo più concreto per anni. La progettazione di un modello del mondo \hat f_\theta che predice lo stato successivo a partire da uno stato s e un'azione a, la valutazione delle sequenze di azioni candidate al suo interno prima di implementarle su hardware reale, la gestione dell'accumulo dell'errore di predizione tramite randomizzazione del dominio e il processo a fasi per il passaggio dalla simulazione alla realtà: tutto ciò è trattato in dettaglio in "Introduzione all'apprendimento per rinforzo basato su modelli e al passaggio dalla simulazione alla realtà". I modelli del mondo in stile generazione video e i modelli di dinamica latente dell'MBRL operano a diversi livelli di risoluzione rappresentativa, ma condividono la stessa idea di base: testare all'interno di un modello appreso prima di testare tutto su hardware reale.
Stato attuale
- Obiettivo: ambienti virtuali/video per la visualizzazione umana: Modelli generativi del mondo come Sora, Genie 3 e Marble di World Labs. Visivamente accattivanti, ma il rigore fisico non è garantito.
- Obiettivo: generazione di dati per l'apprendimento e la valutazione delle politiche dei robot: Progetti come NVIDIA Cosmos e 1X World Model, che collegano direttamente la tecnologia di generazione video alla generazione di azioni robotiche. Si prevede che faciliteranno la raccolta di dati da hardware reale.
- Obiettivo: un simulatore interno per l'apprendimento per rinforzo basato su modelli: Modelli di dinamica latente della famiglia DreamerV3. Relativamente leggeri dal punto di vista computazionale e facili da integrare direttamente in un ciclo di apprendimento delle politiche, ma limitati nella complessità delle osservazioni che possono gestire.
- Obiettivo: apprendimento delle rappresentazioni e previsione generica: Approcci non generativi della famiglia V-JEPA. Evitare i costi di generazione dei pixel, puntando al contempo alle prestazioni di trasferimento per le attività successive.
Ognuna di queste tendenze si basa sullo stesso principio fondamentale: l'internalizzazione delle dinamiche di un ambiente attraverso l'apprendimento, differenziandosi però in base al risultato ottenuto e al destinatario (o alla natura) dell'output: un essere umano, un programma o un ciclo di apprendimento basato su policy. Questa è la realtà del 2026.
I video realistici del futuro consentono di effettuare previsioni fisiche accurate?
La plausibilità visiva e le dinamiche condizionate dall'azione sono diverse.
Confronta le variazioni di stato previste con le transizioni effettive sotto le stesse azioni.Riferimenti
- World Models, articolo originale (Ha & Schmidhuber, 2018)
- Blog ufficiale di Dreamer (Google Research)
- Articolo su DreamerV3, "Mastering diverse control tasks through world models" (Nature)
- Video generation models as world simulators (OpenAI, ufficiale)
- Genie 3: A new frontier for world models (Google DeepMind, ufficiale)
- Genie 2: A large-scale foundation world model (Google DeepMind, ufficiale)
- Annuncio di World Labs Marble (TechCrunch)
- Una tassonomia funzionale dei modelli del mondo (Fei-Fei Li, blog ufficiale)
- Annuncio di NVIDIA Cosmos 3 (NVIDIA Newsroom)
- V-JEPA (Meta AI, ufficiale)
- Articolo su WorldRoamBench (arXiv)
- Per maggiori dettagli sull'apprendimento per rinforzo basato su modelli e sulla simulazione-reale, vedere anche "Introduzione all'apprendimento per rinforzo basato su modelli e alla simulazione-reale"
Commenti
Accedi per continuare.
Nessun dato disponibile.