Contents — find the section you need
Ein Weltmodell ist ein allgemeiner Begriff für ein Modell, das lernt, vorherzusagen, wie sich der Zustand einer Umgebung verändert, wenn ein Agent eine Aktion ausführt. In der Robotik und im Reinforcement Learning dient es als interner Simulator, um „Dinge im Kopf durchzuspielen, bevor man in der realen Welt handelt“. Im Kontext der KI-gestützten Videogenerierung bildet es die Grundlage dafür, „nicht nur plausibel aussehende Videos zu erzeugen, sondern die Umgebung selbst nach physikalischen Gesetzen zu simulieren“. Dieses Konzept hat in den letzten Jahren in beiden Bereichen rasant an Bedeutung gewonnen.
 NVIDIA Cosmos
Bild: NVIDIA logo, Wikimedia Commons. Hier vorgestellt als das Unternehmen, das die Cosmos-Serie von Weltmodellen für physikalische KI entwickelt.

Weltmodelle in einem Diagramm
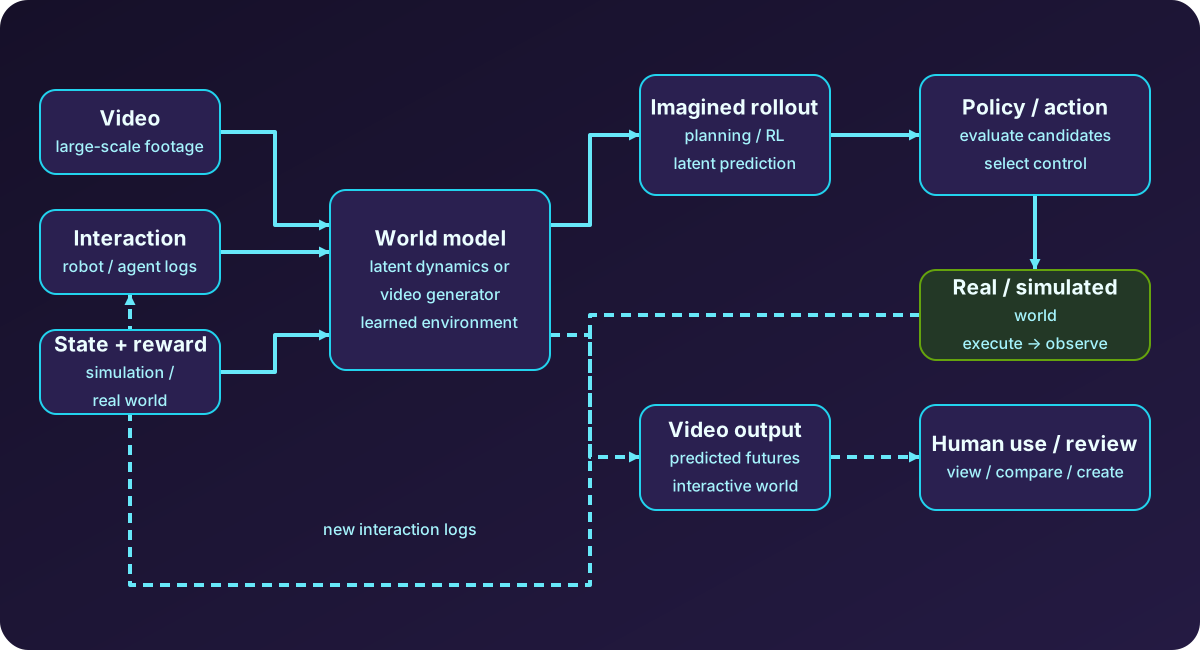
Diagramm: erstellt von Duskcoil. Ein vereinfachtes Diagramm, das die Verwendung als interner Simulator für modellbasiertes Reinforcement Learning mit der Verwendung als Videogenerierungsmodell kombiniert.
Das Verständnis von Weltmodellen basiert auf zwei Fragen: Was wird vorhergesagt? (Rohvideopixel oder eine komprimierte latente Repräsentation) und Wofür wird es verwendet? (Interner Simulator für Policy-Learning oder Videogenerierung zur menschlichen Betrachtung). Der Begriff „Weltmodell“ kann sowohl ein probabilistisches latentes Dynamikmodell bezeichnen, das dem Simulations-zu-Realitäts-Lernen eines Roboters zugrunde liegt, wie beispielsweise bei Dreamer, als auch ein Videogenerierungsmodell mit zig Milliarden Parametern, wie bei Sora oder Genie. In diesem Forschungsfeld können Diskussionen schnell aneinander vorbeiziehen, wenn der Kontext nicht klar definiert ist.
Entwicklung: Von Ha & Schmidhubers Originalarbeit zu DreamerV3
Die Verbreitung des Begriffs „Weltmodell“ in seiner heutigen Bedeutung geht auf eine Veröffentlichung von David Ha und Jürgen Schmidhuber aus dem Jahr 2018 zurück. In ihrem Ansatz komprimiert ein VAE (Variational Autoencoder) visuelle Beobachtungen zu einer kompakten Repräsentation, und ein RNN (LSTM) prognostiziert, wie sich diese Repräsentation im Laufe der Zeit verändert. Sie zeigten, dass ein Agent eine Strategie vollständig „innerhalb“ dieses gelernten latenten Raums trainieren kann.
Dieses Design wurde 2019 in PlaNet wesentlich verbessert. Dessen RSSM (Recurrent State-Space Model) kombinierte deterministische und stochastische Komponenten, um die Genauigkeit und Konsistenz von Mehrschrittvorhersagen signifikant zu steigern. Während PlaNet in jedem Schritt einen Plan neu berechnete (Model Predictive Control, MPC), ging der Nachfolger Dreamer noch einen Schritt weiter: Er lernte eine Strategie (Akteur) und eine Wertfunktion (Kritiker) direkt durch Backpropagation innerhalb des Weltmodells – ein Design, das seither als Grundlage für die „Dreamer-Familie“ dient. DreamerV2 führte diskrete latente Repräsentationen ein, und DreamerV3, 2025 in Nature veröffentlicht, demonstrierte eine Leistungsfähigkeit, die sich auf verschiedene Domänen – darunter den Diamantenabbau in Minecraft – ohne feste Hyperparameter-Optimierung übertragen ließ. Dies setzte neue Maßstäbe für die praktische Anwendbarkeit von Weltmodellen im modellbasierten Reinforcement Learning.
Konvergenz aus dem Bereich der generativen KI: Sora, Genie, World Labs
Unabhängig vom Reinforcement Learning wurde der Begriff „Weltmodell“ auch im Bereich der KI zur Videogenerierung verwendet. 2024 argumentierte OpenAI in seinem technischen Bericht zum Videogenerierungsmodell Sora, dass die Skalierung von Videogenerierungsmodellen ein vielversprechender Weg sei, um universelle Simulatoren der physikalischen Welt zu entwickeln. Als Beispiele wurden Farbstriche auf einer Leinwand und Bissspuren nach dem Verzehr eines Hamburgers angeführt, die belegten, dass Sora implizit einige Aspekte physikalischer Gesetze und Kausalität erlernt habe.
Die Genie-Serie von Google DeepMind trieb diese Entwicklung weiter voran: Im Dezember 2024 demonstrierte Genie 2 die Fähigkeit, aus einem einzelnen Bild eine steuerbare 3D-Umgebung zu generieren, und im August 2025 konnte Genie 3 persistente, minutenlange, in Echtzeit erkundbare 3D-Welten anhand einer Texteingabe mit 24 Bildern pro Sekunde und 720p-Auflösung erzeugen. DeepMind positioniert dies als skalierbare Methode zur Generierung von Trainingsdaten für Navigation, Wahrnehmung und langfristiges Denken in der Robotik. Im Februar 2026 wurde berichtet, dass Waymo die Technologie für Simulationen autonomen Fahrens eingeführt hat.
World Labs, gegründet von Fei-Fei Li von der Stanford University, kündigte im November 2025 sein kommerzielles Produkt Marble an. Marble generiert aus Text-, Bild- oder Videofragmenten persistente, herunterladbare 3D-Umgebungen (exportierbar als Gaussian Splatting, Meshes oder Video). In einem im Juni 2026 veröffentlichten Essay klassifizierte Li Weltmodelle funktional in drei Kategorien: Renderer (erzeugt Videos für das menschliche Auge), Simulator (erzeugt eine geometrisch und physikalisch korrekte Repräsentation für Berechnungen) und Planer (produziert die nächste Aktion basierend auf Beobachtungen und einem Ziel). Videogenerierungssysteme wie Sora und Genie ordnen sie dem Renderer zu, Modelle für die Roboterlerndynamik dem Simulator und VLA dem Planer.
NVIDIA Cosmos: Ein Weltmodell für die Robotik
Ein Ansatz, der in der Robotikindustrie zunehmend an Bedeutung gewinnt, ist die Cosmos-Serie von NVIDIA. Cosmos 3, angekündigt im Juni 2026, verwendet eine Architektur mit verschiedenen Transformatoren, die visuelles Denken, Weltgenerierung und Aktionsvorhersage in einem einzigen Modell vereint und mehrere Modalitäten – Text, Bild, Video, Umgebungsgeräusche und Aktionen – in einem einzigen Framework verarbeitet. Ziel ist eine Datengenerierungspipeline: Anstatt Tausende von Stunden an Tests mit einem realen Roboterarm durchzuführen, werden große Mengen simulierter Videos eines Roboters bei der Ausführung einer Aufgabe generiert, eine Strategie anhand dieser Daten trainiert und anschließend auf realer Hardware eingesetzt. NVIDIA hat mit Partnern wie Agile Robots, Black Forest Labs, Runway und Skild AI die Cosmos Coalition gegründet und baut damit ein offenes Ökosystem für World Foundation Models auf.
Generativ oder nicht: LeCuns JEPA als Gegenpol
Sora, Genie und Cosmos haben gemeinsam, dass sie direkt Pixel (oder eine ihnen ähnliche Repräsentation) generieren. Yann LeCun, ehemals Chief AI Scientist bei Meta AI, hat diesem generativen Ansatz stets skeptisch gegenübergestanden. Seine vorgeschlagene JEPA (Joint Embedding Predictive Architecture) setzt einen klaren Kontrast, indem sie innerhalb eines abstrakten Repräsentationsraums vorhersagt und niemals Pixel oder Token generiert. V-JEPA 2, basierend auf dieser Designphilosophie, soll nach einem Vortraining mit rund einer Million Stunden Internetvideos und einer Feinabstimmung mit nur 62 Stunden Robotermanipulationsdaten eine Erfolgsquote von etwa 80 % bei Zero-Shot-Robotermanipulationsaufgaben erzielt haben. LeCun verließ Meta Anfang 2026, gründete AMI Labs in Paris und akquirierte eine Anschubfinanzierung von über einer Milliarde Dollar, um sich auf die Entwicklung eines universellen Weltmodells zu konzentrieren – eine Phase, in der er nun seine Behauptung, dass „generative Modelle als Weltmodelle eine Sackgasse sind“, auf die Probe stellt.
Stand 2026 ist noch immer unklar, welcher der generativen oder nicht-generativen (JEPA-artigen) Ansätze überlegen ist. Generative Modelle haben den Vorteil, Videos zu erzeugen, die Menschen direkt visuell beurteilen können, während JEPA-artige Ansätze durch ihre abstrakte Repräsentation Vorteile in Bezug auf Recheneffizienz und langfristige Vorhersagestabilität bieten sollen – doch bisher konnte keiner der beiden Ansätze einen entscheidenden Vorteil im großflächigen Einsatz in der Praxis nachweisen.
Offene Herausforderungen: Physikalische Konsistenz, Langzeitkohärenz und Evaluierung
Physikalische Konsistenz: In Soras generierten Videos wurden zahlreiche konkrete Beispiele für Verstöße gegen physikalische Gesetze aufgezeigt – Objekte, die schweben, obwohl sie der Schwerkraft trotzen, eine Kerzenflamme, die sich nicht bewegt, eine Ameise mit der falschen Anzahl an Beinen und unnatürliches Verhalten von Glasfragmenten beim Zerbrechen. Analysen haben gezeigt, dass selbst leistungsstarke Modelle bei Schwerkraft, Objektpermanenz und kausaler Konsistenz versagen. Die neutrale Einschätzung lautet daher: Sora 2 hat zwar eindeutig etwas über 3D-Strukturen und physikalische Kausalität gelernt, aber dieses Wissen ist nicht mit dem einer herkömmlichen Physik-Engine vergleichbar.
Langzeitkohärenz: Ob der Zustand einer Umgebung über Zeiträume von mehr als einigen zehn Sekunden stabil bleiben kann, ist weiterhin eine ungelöste Herausforderung. Die 2026 vorgeschlagenen Evaluierungsstandards, wie beispielsweise WorldRoamBench, bewerten die Langzeitstabilität anhand von vier Achsen: Aktionstreue, visuelle Abweichungen (Drift), physikalische Konsistenz und Gedächtniskonsistenz (ob zuvor besuchte Orte und Objekte erinnert werden). Sie weisen darauf hin, dass viele bestehende Evaluierungsmethoden von vornherein nur kurze Zeitfenster von 5–10 Sekunden betrachteten.
Schwierigkeiten der Evaluierung: Es besteht noch kein Konsens darüber, wie ein „gutes Weltmodell“ quantitativ gemessen werden kann. Die visuelle Natürlichkeit generierter Videos und ihre Nützlichkeit für nachgelagerte Robotersteuerungsaufgaben korrelieren nicht unbedingt. Da sich die semantische Skala der Ausgaben je nach Modell unterscheidet, ist ein fairer Vergleich von Trajektorien zwischen verschiedenen Modellen schwierig.
Rechenaufwand: Die Evaluierung und das Training umfangreicher Weltmodelle sind kostspielig – ein einzelner API-Aufruf kann Berichten zufolge mehr als einen Dollar kosten. Modelle, die Aufgaben mit langem Zeithorizont lernen und bewerten, können in einer einzigen Antwort fast 100.000 Tokens generieren. Dies stellt ein Hindernis für die Reproduzierbarkeit von Forschungsergebnissen dar.
Die Verbindung zum Robotischen Lernen
Ein Paradebeispiel für die direkte Anwendung von Weltmodellen in der Robotik ist das Video-Weltmodell, das 1X Technologies für seinen humanoiden Roboter NEO entwickelt hat (siehe „Technologietrends bei humanoiden Robotern“ für Details). Das Design, bei dem ein Videogenerierungsmodell mit 14 Milliarden Parametern ein kurzes Video der Aufgabenerledigung simuliert, das anschließend mithilfe eines inversen Dynamikmodells in tatsächliche Motorbefehle umgewandelt wird, ist ein konkretes Beispiel für die direkte Verbindung eines Renderers (Videogenerierung) mit einem Planer (Aktionsgenerierung).
Im klassischen Kontext des Reinforcement Learnings hat modellbasiertes Reinforcement Learning (MBRL) dieses Konzept bereits seit Jahren in einer fundierteren Form umgesetzt. Das Design des Lernens eines Weltmodells \hat f_\theta, das den nächsten Zustand aus einem Zustand s und einer Aktion a vorhersagt, die Bewertung von Kandidaten-Aktionssequenzen innerhalb dieses Modells vor der Implementierung auf realer Hardware, der Umgang mit der Akkumulation von Vorhersagefehlern durch Domänenrandomisierung und der stufenweise Übergang von der Simulation zur realen Umgebung – all dies wird detailliert in „An Introduction to Model-Based Reinforcement Learning and Sim-to-Real“ beschrieben. Videogenerierte Weltmodelle und die latenten Dynamikmodelle von MBRL arbeiten mit unterschiedlichen Repräsentationsauflösungen, teilen aber die gleiche Kernidee: Zunächst wird die Implementierung in einem gelernten Modell getestet, bevor sie auf realer Hardware erprobt wird.
Aktueller Stand
- Ziel: Video-/virtuelle Umgebungen für die menschliche Betrachtung: Generative Weltmodelle wie Sora, Genie 3 und Marble von World Labs. Visuell ansprechend, aber physikalische Genauigkeit nicht garantiert.
– Ziel: Datengenerierung für das Lernen und Evaluieren von Roboterstrategien: Ansätze wie NVIDIA Cosmos und das 1X World Model verbinden Videogenerierungstechnologie direkt mit der Generierung von Roboteraktionen. Dies soll den Engpass bei der Datenerfassung mit realer Hardware verringern.
– Ziel: Interner Simulator für modellbasiertes Reinforcement Learning: Latente Dynamikmodelle der DreamerV3-Familie. Relativ recheneffizient und einfach direkt in einen Strategielernprozess einzubetten, jedoch in der Komplexität der verarbeitbaren Beobachtungen begrenzt.
– Ziel: Repräsentationslernen und allgemeine Vorhersage: Nicht-generative Ansätze der V-JEPA-Familie. Sie vermeiden die Kosten der Pixelgenerierung und optimieren gleichzeitig die Übertragungsleistung auf nachgelagerte Aufgaben.
Alle diese Trends basieren auf demselben Fundament – der Internalisierung der Dynamik einer Umgebung durch Lernen – und unterscheiden sich hinsichtlich ihrer Ausgabe und des Empfängers (bzw. des Empfängers): Mensch, Programm oder Strategielernprozess. Das ist die Realität im Jahr 2026.
Ermöglicht realistische Zukunftsvisualisierung in Videos präzise physikalische Vorhersagen?
Visuelle Plausibilität und handlungsbedingte Dynamik unterscheiden sich. Vergleichen Sie vorhergesagte Zustandsänderungen mit tatsächlichen Übergängen bei denselben Aktionen.
Referenzen
- Weltmodelle, Originalveröffentlichung (Ha & Schmidhuber, 2018)
- Dreamer offizieller Blog (Google Research)
- DreamerV3-Veröffentlichung, „Mastering diverse control tasks through world models“ (Nature)
- Videogenerierungsmodelle als Weltsimulatoren (OpenAI, offiziell)
-
Genie 3: Eine neue Grenze für Weltmodelle (Google DeepMind, offiziell)
-
Genie 2: Ein groß angelegtes Grundlagen-Weltmodell (Google DeepMind, offiziell)
- [World Labs Marble-Ankündigung] (TechCrunch)](https://techcrunch.com/2025/11/12/fei-fei-lis-world-labs-speeds-up-the-world-model-race-with-marble-its-first-commercial-product/)
- Eine funktionale Taxonomie von Weltmodellen (Fei-Fei Li, offizieller Blog)
- Weitere Informationen zu modellbasiertem Reinforcement Learning und Sim-to-Real finden Sie auch in „Eine Einführung in modellbasiertes Reinforcement Learning und Sim-to-Real“.
Kommentare
Bitte zuerst anmelden.
Noch keine Einträge.