Contents — find the section you need
Das Ausführen großer Sprachmodelle auf dem eigenen Rechner ohne Cloud-API – sogenannte „lokale Sprachmodelle“ – ist in den letzten Jahren praktikabel geworden. Dies ist das Ergebnis zweier Entwicklungen: verbesserte Open-Weight-Modelle und Modellverkleinerung durch Quantisierungstechniken.
 Ollama
 Hugging Face
Bild: Ollama / Hugging Face Logos, Wikimedia Commons


Lokale Inferenz auf einen Blick
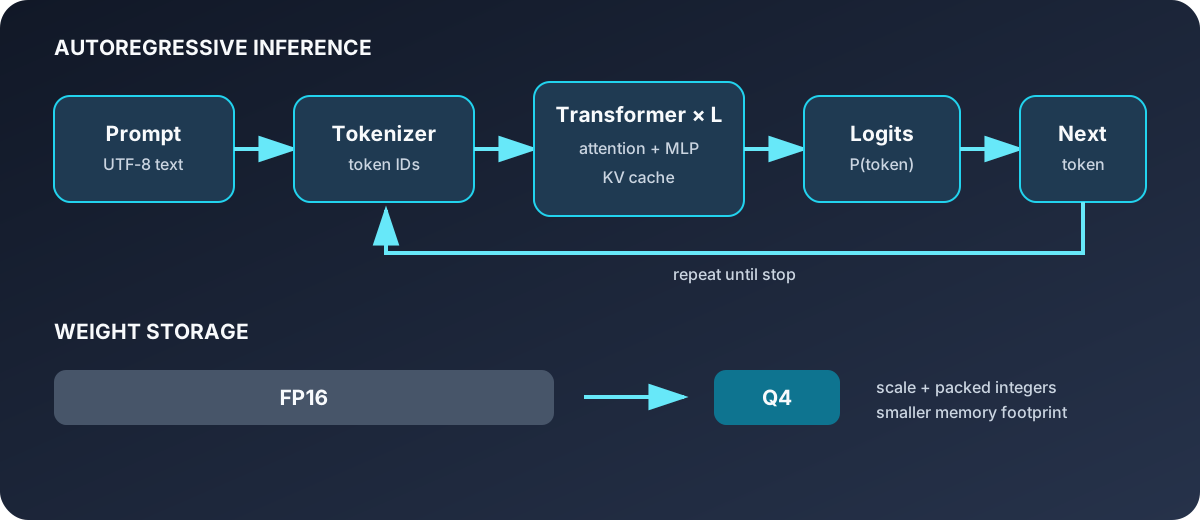
Diagramm: Duskcoil. Der Generierungspfad und die Rolle der Gewichtsquantisierung werden separat dargestellt.
Der Schlüssel zum Verständnis eines lokalen LLM liegt in der Trennung der wiederholten Inferenzschleife vom Speicherbedarf für das Modell. Text wird zu Token-IDs; der Transformer berechnet eine Verteilung für das nächste Token; und das ausgewählte Token wird an die Eingabe zurückgegeben. Die Quantisierung hingegen verändert primär die Speicherung und Berechnung der Gewichte, sodass ein Modell in begrenzten RAM oder VRAM passt. Ein sinnvoller Vergleich der Bereitstellungen berücksichtigt daher nicht nur den Modellnamen, sondern auch das Gewichtsformat, den mit der Kontextlänge wachsenden KV-Cache und die verfügbaren CPU/GPU-Backends.
Der rasante Aufstieg von Open-Weight-Modellen
Die Open-Weight-Landschaft verändert sich bis 2026 kontinuierlich im Zeitrahmen von Monaten. DeepSeek treibt die hohe Effizienz seiner Flash- und Pro-Varianten voran; Qwen hat sich von einem ernstzunehmenden Konkurrenten zu einem Spitzenreiter im Bereich des logischen Denkens auf Hochschulniveau entwickelt, dank seiner breiten Hardware- und Modellgrößenoptionen. Metas Llama 4 bietet ein Kontextfenster von bis zu 10 Millionen Token für ein offenes Modell. Kürzlich erzielte Z.ais GLM-5.2 einen großen Sprung in der Leistung von Codierungsagenten und wurde innerhalb weniger Tage nach Veröffentlichung in Agenten-Frameworks integriert. Kimi K2.7 Code HighSpeed verspricht eine sechsfache Beschleunigung beim multimodalen Codierungslogik – die Entwicklung schreitet rasant voran.
Benchmark-Ergebnisse markieren ebenfalls einen wichtigen Wandel. In SWE-Benchmark-basierten Codierungs-Evaluierungs-Suiten hat sich der Abstand zwischen den besten offenen Modellen und den führenden kommerziellen Modellen auf einstellige Prozentpunkte verringert, und manche argumentieren, dass dieser Abstand für die alltägliche Entwicklungsarbeit praktisch verschwunden ist.
Die Grundlage: Der Aufmerksamkeitsmechanismus
Jedes große Sprachmodell, das heute weit verbreitet ist – einschließlich derer, die mit Ollama ausgeführt werden – basiert auf der Transformer-Architektur, deren Kern die Selbstaufmerksamkeit ist. Ausgehend von den aus der Eingabesequenz abgeleiteten Matrizen Query Q, Key K und Value V wird die skalierte Dot-Product-Attention wie folgt berechnet:
QK^\top repräsentiert die Verwandtschaft (Ähnlichkeit) der Token zueinander. Die Division durch \sqrt{d_k} (die Quadratwurzel der Key-Dimension) verhindert, dass die Dot-Products so groß werden, dass der Gradient der Softmax-Funktion verschwindet. Die Wiederholung dieser Operation über alle Parameter und Schichten eines Modells entspricht der Transformer-Inferenz. Die Quantisierung, die im Folgenden erläutert wird, bestimmt, wie weit die meisten Parameter (die Gewichtsmatrizen) verkleinert werden können.
QK^\top repräsentiert die Verwandtschaft (Ähnlichkeit) der Token. ## Die Grundform der linearen Quantisierung
GGUF, AWQ und GPTQ basieren gleichermaßen auf der linearen Quantisierung: der Umwandlung eines Gleitkomma-Gewichts x in eine niederwertige Ganzzahl q.
s ist die Skalierung (die reelle Zahlenbreite pro Schritt) und z der Nullpunkt (an dem in der Ganzzahldarstellung die reelle Null liegt). Diese beiden Kalibrierungsparameter sowie die Art und Weise, wie die einzelnen Methoden diese Werte bestimmen und auf welcher Granularität (gesamtes Modell, pro Schicht, pro Gewicht) sie angewendet werden, bestimmen die Leistungsunterschiede zwischen ihnen.
Die Weiterentwicklung der Quantisierung: GGUF, AWQ, GPTQ
Neben einer verbesserten Modellleistung ist die Quantisierung – die Verkleinerung der Modellgröße – ebenso wichtig geworden. Quantisierungsverfahren wie GGUF, AWQ und GPTQ haben die Modellgröße um etwa 70 % reduziert und dabei den Genauigkeitsverlust unter 2 % gehalten. So passt ein Modell mit 32 Milliarden Parameterklassen nun in 16 GB Arbeitsspeicher. Lokale Inferenz auf typischer Consumer-Hardware erreicht jetzt 70–85 % der Qualität eines High-End-Modells – ohne zusätzliche Kosten pro Anfrage.
Die drei Formate haben jeweils ihre Stärken. GGUF (ehemals GGML) ist das native Format für llama.cpp und sein Ökosystem (Ollama, LM Studio usw.) und eignet sich besonders für hybride CPU/GPU-Inferenz. GPTQ zeichnet sich durch hohe Inferenzgeschwindigkeit auf reinen GPU-Systemen aus, und AWQ gilt allgemein als die beste Option für Genauigkeit pro Größe bei 4-Bit-Quantisierung. Für die allgemeine lokale Entwicklung wird GGUF über Ollama oft als Standardwahl empfohlen.
Die technischen Unterschiede zwischen den drei Quantisierungsmethoden
GGUF, AWQ und GPTQ sind Quantisierungsmethoden, die Modellgewichte von 16-Bit/32-Bit-Gleitkommazahlen auf etwa 4 Bit reduzieren. Sie erreichen dies jedoch auf technisch unterschiedlichen Wegen.
GPTQ behandelt die Quantisierung als Optimierungsproblem. Es verwendet näherungsweise Informationen zweiter Ordnung aus der Verlustfunktion (der Hesse-Matrix), um zu bestimmen, welche Rundungsfehler der Gewichte den größten Einfluss auf die Ausgabe haben. Anschließend wird der resultierende Fehler bei der Quantisierung jedes einzelnen Gewichts als Kompensation auf die noch nicht quantisierten Gewichte in derselben Zeile verteilt. Diese Methode ist auf die GPU-Inferenzleistung optimiert; die Quantisierung eines Modells mit 7 Milliarden Parameterklassen dauert auf einer einzelnen A100-GPU etwa 2–4 Stunden.
AWQ hingegen konzentriert sich nicht auf den Quantisierungsschritt selbst, sondern darauf, herauszufinden, „welche Gewichte tatsächlich relevant sind“. Es führt eine Kalibrierungsphase durch, die die tatsächlichen Aktivierungen des Modells beobachtet, die wichtigsten Gewichte identifiziert, die die Ausgabequalität stark beeinflussen, und alle anderen Daten aggressiv quantisiert, während diese Gewichte mit hoher Präzision erhalten bleiben. Es benötigt weniger Kalibrierungsbeispiele als GPTQ (etwa 128–512 gegenüber oft über 2048 bei GPTQ), wodurch es deutlich schneller ist – etwa 10–30 Minuten für ein 7-Bit-Modell.
GGUF (das native Format von llama.cpp) verwendet ein Verfahren namens „K-Quantisierung“, das jeder Schicht eine andere Bittiefe zuweist – 6 Bit für eine wichtige Schicht wie die Aufmerksamkeitsschicht, 4 Bit für eine Feedforward-Schicht usw. – und so eine höhere Qualität pro Bit als bei der einfachen, gleichmäßigen 4-Bit-Quantisierung erzielt. Eine repräsentative Einstellung, Q4_K_M, soll etwa 92 % der ursprünglichen Modellqualität erhalten.
Diese technischen Unterschiede lassen direkt darauf schließen, welcher Anwendungsfall zu welcher Methode passt. AWQ eignet sich für GPU-basierte, schnelle Inferenz. GPTQ ist die richtige Wahl, wenn ein ausgereiftes GPU-Ökosystem und eine große Bibliothek vorquantisierter Modelle entscheidend sind; GGUF (über Ollama usw.) hingegen, wenn die einfache Nutzung in einer hybriden CPU/GPU-Umgebung Priorität hat.
llama.cpp: Funktionsweise der Engine für lokale Inferenz
Viele lokale LLM-Laufzeitumgebungen, darunter auch Ollama, basieren auf llama.cpp – einer in C/C++ geschriebenen Inferenz-Engine – und GGML, der zugrunde liegenden Tensorbibliothek. GGML ist eine schlanke Tensorberechnungsbibliothek mit geringen Abhängigkeiten, vergleichbar mit PyTorch oder TensorFlow. Sie stellt die gesamte Berechnung eines Modells als „Berechnungsgraph“ dar. Einige Tensoren enthalten tatsächliche Daten (wie Gewichte), während andere lediglich das Ergebnis einer Operation zwischen anderen Tensoren repräsentieren und erst nach der eigentlichen Berechnung einen Wert annehmen. Dieser Berechnungsgraph kann direkt auf der CPU ausgeführt oder in Anweisungen für einen Beschleuniger übersetzt werden – CUDA für NVIDIA-GPUs, Metal für Apple-Hardware. Diese Portabilität, also die Ausführung derselben Modelldatei auf einer Vielzahl von Hardwarekonfigurationen, ist die technische Grundlage für die Popularität des GGUF-Formats.
Die Zahlen hinter dem Wachstum
Wie rasant sich das Format verbreitet hat, zeigen konkrete Zahlen. Die monatlichen Downloadzahlen von Ollama stiegen von 100.000 im ersten Quartal 2023 auf 52 Millionen im ersten Quartal 2026 – eine Steigerung um das 520-Fache innerhalb von drei Jahren. Die Anzahl der GGUF-formatierten Modelle auf Hugging Face, die für lokale Inferenz formatiert sind, wuchs im gleichen Zeitraum von 200 auf 135.000. llama.cpp, das Projekt, das all dem zugrunde liegt, hat auf GitHub über 73.000 Sterne erreicht.
Die Landschaft der Modellveröffentlichungen Ende 2026
Laut Ollamas offiziellem Blog folgte in der zweiten Jahreshälfte 2026 eine große Veröffentlichung der nächsten. Am 10. August veröffentlichte Meta Superintelligence Labs sein erstes Open-Source-Modell, ein multimodales Modell mit 30 Milliarden Parametern namens „Muse Glimmer“, unter der Apache-2.0-Lizenz. Bereits am nächsten Tag, dem 11. August, kündigte NVIDIA „Nemotron 3.5 Lightning“ an, ein 30-Milliarden-Parameter-Modell für mehrstufige Agentenaufgaben. Am 29. Juni erschien ein Update, das Gemma 4 auf Apple Silicons MLX-Laufzeitumgebung um bis zu 90 % beschleunigte und damit die Ausführungsgeschwindigkeit für Coding-Agent-Anwendungsfälle weiter steigerte. Ollama selbst gab am 9. Juli eine Finanzierungsrunde über 88 Millionen US-Dollar bekannt und berichtete von 8,9 Millionen Entwicklernutzern. Das Ökosystem der Open-Source-Modelle entwickelt sich von der reinen Modellveröffentlichung hin zu einer echten kommerziellen Infrastruktur.
Die Speerspitze der Quantisierung: NVFP4 als neue Option
Nach GGUF, AWQ und GPTQ hat die Forschung zu NVFP4 – einem 4-Bit-Gleitkommaformat für NVIDIAs Blackwell-Architektur – bis 2026 als neues Quantisierungsformat rasant an Fahrt aufgenommen. Eine Studie vom Juni 2026 ergab, dass eine Blockgröße von 16 das beste Verhältnis zwischen Genauigkeit und Speicherbedarf bietet. ScaleSweep (Mai 2026), das die anfänglichen Blockskalierungswerte mittels einer Sweep-Suche optimiert, ist eine von mehreren Methoden, die zeigen, dass selbst aggressive Quantisierung mehr als 93 % der vollen Präzision erhalten kann. Auch Nachbearbeitungstechniken wie H-Scale (August 2026) sind entstanden. H-Scale verfeinert die Skalierungswerte pro Gruppe mithilfe einer auf der Hesse-Matrix basierenden Approximation zweiter Ordnung ohne zusätzlichen Inferenzzeitaufwand – ein Zeichen dafür, dass sich die Quantisierungsforschung selbst von der Frage „Wie weit können Gewichte reduziert werden?“ hin zur Frage „Wie kann die Genauigkeit nach der Reduzierung wiederhergestellt werden?“ verlagert.
Die Komprimierung des KV-Caches (des Speicherbereichs, der während der Generierung Zwischenrepräsentationen vergangener Token enthält und mit zunehmender Kontextgröße stark anwächst) schreitet parallel voran. SemKV (August 2026), das jedem Token dynamisch eine von zwei Präzisionsstufen basierend auf einem Wichtigkeitswert zuweist, erreicht eine 6,0-fache Speicherreduzierung und vermeidet dabei den abrupten Qualitätsabfall („Quality Cliff“). In Kombination mit einem optimierten Quantisierer wird sogar eine 7,9-fache Reduzierung erzielt. Für die lokale Inferenz über lange Kontexte hinweg wird die KV-Cache-Komprimierung ebenso wichtig wie die Gewichtsquantisierung selbst.
Reicht das Anpassen der Gewichte im Speicher für die Inferenz aus?
KV-Cache, Arbeitsbereich und Laufzeit-Overhead beanspruchen ebenfalls Speicher. Berücksichtigen Sie Kontextlänge und Parallelität in der Schätzung.
Referenzen
- Beste Open-Weight LLMs 2026: DeepSeek vs. Qwen vs. Kimi vs. GLM vs. Llama
- LLM-Quantisierung erklärt: GGUF vs. AWQ vs. GPTQ – Der vollständige Leitfaden für 2026
- Lokale KI im Jahr 2026: Ollama-Benchmarks, Inferenz für 0 $ und das Ende der Token-basierten Preisgestaltung
-
LLM-Quantisierungsleitfaden: GGUF vs. AWQ vs. GPTQ vs. bitsandbytes im Vergleich (2026)
- H-Scale Paper (arXiv)
- ScaleSweep Paper (arXiv)
- SemKV Paper (arXiv)
Kommentare
Bitte zuerst anmelden.
Noch keine Einträge.