Contents — find the section you need
क्लाउड एपीआई के बिना, अपने कंप्यूटर पर एक बड़े भाषा मॉडल को चलाना — "लोकल एलएलएम" — पिछले कुछ वर्षों में व्यावहारिक हो गया है। यह दो प्रमुख रुझानों के संगम का परिणाम है: बेहतर ओपन-वेट मॉडल और क्वांटाइजेशन तकनीकों के माध्यम से मॉडल को छोटा करना।
 Ollama
 Hugging Face
छवि: Ollama / Hugging Face लोगो, विकिमीडिया कॉमन्स


स्थानीय अनुमान एक नज़र में
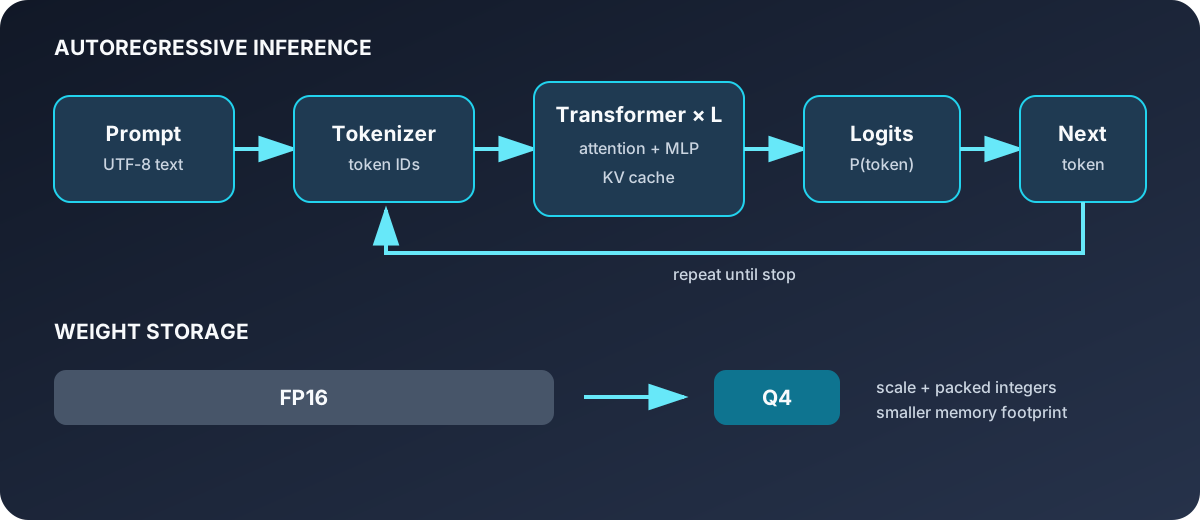
आरेख: डस्ककॉइल। जनरेशन पाथ और वेट क्वांटाइजेशन की भूमिका को अलग-अलग दर्शाया गया है।
लोकल एलएलएम को समझने की कुंजी बार-बार दोहराए जाने वाले इन्फरेंस लूप को मॉडल को रखने के लिए आवश्यक मेमोरी से अलग करना है। टेक्स्ट टोकन आईडी बन जाता है; ट्रांसफॉर्मर अगले टोकन के लिए एक डिस्ट्रीब्यूशन की गणना करता है; और चयनित टोकन इनपुट पर वापस आ जाता है। वहीं, क्वांटाइजेशन मुख्य रूप से वेट को स्टोर करने और गणना करने के तरीके को बदलता है ताकि मॉडल सीमित रैम या वीआरएएम में फिट हो सके। इसलिए, एक उपयोगी परिनियोजन तुलना में न केवल मॉडल का नाम, बल्कि उसका वेट फॉर्मेट, कॉन्टेक्स्ट लेंथ के साथ बढ़ने वाला केवी कैश और उपलब्ध सीपीयू/जीपीयू बैकएंड भी शामिल होते हैं।
ओपन-वेट मॉडल्स का तेजी से विकास
2026 तक ओपन-वेट परिदृश्य हर कुछ महीनों में बदलता रहता है। डीपसीक अपने फ्लैश और प्रो वेरिएंट में उच्च दक्षता को बढ़ावा देता है; क्वेन अपने हार्डवेयर और मॉडल-साइज़ विकल्पों की व्यापकता के बल पर "एक गंभीर दावेदार" से "स्नातक-स्तरीय तर्क क्षमता में शीर्ष स्थान" पर पहुंच गया है। मेटा का लामा 4 एक ओपन मॉडल के लिए 10 मिलियन टोकन तक की कॉन्टेक्स्ट विंडो प्रदान करता है। हाल ही में, Z.ai के GLM-5.2 ने कोडिंग-एजेंट के प्रदर्शन में ज़बरदस्त सुधार किया और रिलीज़ होने के कुछ ही दिनों में एजेंट फ्रेमवर्क में एकीकृत हो गया, जबकि किमि K2.7 कोड हाईस्पीड मल्टीमॉडल कोडिंग रीजनिंग में 6 गुना गति वृद्धि का दावा करता है - बदलाव की गति बेहद तेज़ है।
बेंचमार्क परिणाम भी एक महत्वपूर्ण बदलाव दर्शाते हैं। SWE-बेंच-शैली के कोडिंग मूल्यांकन सूट पर, शीर्ष ओपन-वेट मॉडल और अग्रणी वाणिज्यिक मॉडलों के बीच का अंतर घटकर एकल-अंकीय प्रतिशत अंक रह गया है, और कुछ का तर्क है कि रोजमर्रा के इंजीनियरिंग कार्यों के लिए यह अंतर लगभग समाप्त हो गया है।
आधार: ध्यान तंत्र
आज के अधिकांश प्रमुख भाषा मॉडल — जिनमें ओलामा द्वारा संचालित मॉडल भी शामिल हैं — ट्रांसफ़ॉर्मर आर्किटेक्चर पर आधारित हैं, और इसका मूल स्व-ध्यान है। इनपुट अनुक्रम से प्राप्त क्वेरी Q, कुंजी K और मान V मैट्रिक्स के आधार पर, यह निम्न प्रकार से स्केल्ड डॉट-प्रोडक्ट ध्यान की गणना करता है।
QK^\top यह दर्शाता है कि टोकन एक दूसरे से कितने संबंधित (कितने समान) हैं, और \sqrt{d_k} (कुंजी आयाम का वर्गमूल) से भाग देने पर डॉट-प्रोडक्ट इतने बड़े नहीं हो जाते कि सॉफ्टमैक्स का ग्रेडिएंट गायब हो जाए। किसी मॉडल के सभी पैरामीटरों और परत की गहराई पर इस प्रक्रिया को दोहराना ही ट्रांसफ़ॉर्मर अनुमान है — और इन पैरामीटरों (भार मैट्रिक्स) के बड़े हिस्से को कितना छोटा किया जा सकता है, यही क्वांटाइजेशन की भूमिका है, जिसकी चर्चा आगे की जाएगी।
लीनियर क्वांटाइजेशन का मूल स्वरूप
GGUF, AWQ और GPTQ तीनों में लीनियर क्वांटाइजेशन का सिद्धांत निहित है: फ्लोटिंग-पॉइंट वेट x को लोअर-बिट इंटीजर q में परिवर्तित करना।
s स्केल (प्रति स्टेप वास्तविक संख्या की चौड़ाई) है और z शून्य बिंदु (जहां, इंटीजर निरूपण में, वास्तविक संख्या शून्य वास्तव में आता है) है — ये दोनों कैलिब्रेशन पैरामीटर हैं, और प्रत्येक विधि इन दो मानों को कैसे निर्धारित करती है, और किस ग्रैन्युलैरिटी (संपूर्ण मॉडल, प्रति-परत, प्रति-वेट) पर, यही उनके प्रदर्शन में अंतर का कारण बनता है।
क्वांटाइजेशन का विकास: GGUF, AWQ, GPTQ
बेहतर मॉडल प्रदर्शन के साथ-साथ, क्वांटाइजेशन — मॉडल के आकार को कम करना — भी उतना ही आवश्यक हो गया है। GGUF, AWQ और GPTQ जैसी क्वांटाइजेशन विधियों ने सटीकता में 2% से कम की कमी रखते हुए मॉडल के आकार को लगभग 70% तक कम कर दिया है, यही कारण है कि 32 अरब पैरामीटर क्लास वाला मॉडल अब 16 GB मेमोरी में समा जाता है। सामान्य उपभोक्ता हार्डवेयर पर स्थानीय अनुमान अब शीर्ष स्तरीय मॉडल की गुणवत्ता के 70-85% तक पहुँच जाता है, और प्रति अनुरोध कोई अतिरिक्त लागत नहीं आती है।
तीनों प्रारूपों की अपनी-अपनी खूबियाँ हैं। GGUF (पूर्व में GGML) llama.cpp और इसके इकोसिस्टम (Ollama, LM Studio, आदि) का मूल प्रारूप है, जो हाइब्रिड CPU+GPU अनुमान में उत्कृष्ट है। GPTQ केवल GPU सेटअप पर तीव्र अनुमान गति में उत्कृष्ट है, और AWQ को आमतौर पर 4-बिट क्वांटाइजेशन पर आकार के अनुसार सटीकता के लिए सबसे अच्छा विकल्प माना जाता है। सामान्य स्थानीय विकास के लिए, Ollama के माध्यम से GGUF को अक्सर डिफ़ॉल्ट विकल्प के रूप में अनुशंसित किया जाता है।
तीनों क्वांटाइजेशन विधियों के बीच तकनीकी अंतर
GGUF, AWQ और GPTQ तीनों ही क्वांटाइजेशन विधियाँ हैं जो मॉडल के भार को 16-बिट/32-बिट फ्लोटिंग पॉइंट से लगभग 4-बिट तक कम करती हैं, लेकिन ये तीनों विधियाँ तकनीकी रूप से भिन्न हैं।
GPTQ क्वांटाइजेशन को एक अनुकूलन समस्या के रूप में देखती है। यह लगभग हानि फलन (हेसियन) से द्वितीय-क्रम की जानकारी का उपयोग करके यह निर्धारित करती है कि आउटपुट के लिए किन भारों की राउंडिंग त्रुटियाँ सबसे अधिक मायने रखती हैं, फिर, जैसे-जैसे प्रत्येक भार का क्वांटाइजेशन होता है, यह परिणामी त्रुटि को उसी पंक्ति में अभी तक क्वांटाइज नहीं किए गए भारों में क्षतिपूर्ति के रूप में वितरित करती है। यह विधि GPU इन्फरेंस प्रदर्शन पर केंद्रित है, और एक 7B-पैरामीटर-क्लास मॉडल का क्वांटाइजेशन एक A100 GPU पर लगभग 2-4 घंटे लेता है।
AWQ इसके विपरीत, क्वांटाइजेशन चरण पर नहीं, बल्कि यह पता लगाने पर केंद्रित है कि "वास्तव में कौन से भार मायने रखते हैं।" यह एक कैलिब्रेशन चरण चलाता है जो मॉडल के वास्तविक एक्टिवेशन का अवलोकन करता है, आउटपुट गुणवत्ता को अत्यधिक प्रभावित करने वाले "प्रमुख" भारों की पहचान करता है, और उन भारों को उच्च परिशुद्धता पर रखते हुए बाकी सभी का आक्रामक रूप से क्वांटाइजेशन करता है। इसे GPTQ की तुलना में कम कैलिब्रेशन नमूनों की आवश्यकता होती है (लगभग 128-512, जबकि GPTQ के लिए अक्सर 2,048+ नमूने लगते हैं), जिससे यह काफी तेज हो जाता है - 7B मॉडल के लिए लगभग 10-30 मिनट।
GGUF (llama.cpp का मूल प्रारूप) "K-क्वांट्स" नामक एक योजना का उपयोग करता है, जो प्रत्येक परत के लिए अलग-अलग बिट गहराई निर्दिष्ट करता है - अटेंशन जैसी उच्च-महत्व वाली परत के लिए 6 बिट, फीड-फॉरवर्ड परत के लिए 4 बिट, इत्यादि - जिससे सरल एकसमान 4-बिट क्वांटाइजेशन की तुलना में प्रति बिट उच्च गुणवत्ता प्राप्त होती है। एक प्रतिनिधि सेटिंग, Q4_K_M, मूल मॉडल की गुणवत्ता का लगभग 92% बनाए रखने के लिए जानी जाती है।
ये तकनीकी अंतर सीधे तौर पर यह निर्धारित करते हैं कि कौन सा उपयोग मामला किस विधि के लिए उपयुक्त है। AWQ केवल GPU पर आधारित, उच्च गति वाले इन्फ़रेंस के लिए; GPTQ तब जब एक परिपक्व GPU इकोसिस्टम और पूर्व-क्वांटाइज़्ड मॉडल की एक बड़ी लाइब्रेरी सबसे ज़्यादा मायने रखती है; GGUF (Ollama आदि के माध्यम से) तब जब हाइब्रिड CPU/GPU वातावरण में उपयोग में आसानी प्राथमिकता हो।
llama.cpp: स्थानीय इन्फ़रेंस के पीछे का इंजन कैसे काम करता है
कई स्थानीय LLM रनटाइम, जिनमें Ollama भी शामिल है, के पीछे llama.cpp स्थित है — एक इन्फ़रेंस इंजन जो C/C++ में लिखा गया है — और GGML, इसके नीचे स्थित टेंसर लाइब्रेरी। GGML एक हल्का, कम निर्भरता वाला टेंसर कंप्यूटेशन लाइब्रेरी है जो मोटे तौर पर PyTorch या TensorFlow के समान है, जो एक मॉडल के संपूर्ण कंप्यूटेशन को "कंप्यूटेशन ग्राफ़" के रूप में दर्शाता है। कुछ टेंसर वास्तविक डेटा (जैसे भार) रखते हैं, जबकि अन्य केवल अन्य टेंसरों के बीच एक ऑपरेशन के परिणाम को दर्शाते हैं, जब तक कि कंप्यूटेशन वास्तव में निष्पादित नहीं हो जाता तब तक उनका कोई मान नहीं होता। इस कंप्यूटेशन ग्राफ को सीधे CPU पर चलाया जा सकता है, या इसे एक्सेलेरेटर के लिए निर्देशों में रूपांतरित किया जा सकता है — NVIDIA GPU के लिए CUDA, Apple हार्डवेयर के लिए Metal — और यह पोर्टेबिलिटी, यानी एक ही मॉडल फ़ाइल को विभिन्न हार्डवेयर कॉन्फ़िगरेशन पर चलाने की क्षमता, GGUF प्रारूप की लोकप्रियता का तकनीकी आधार है।
विकास के पीछे के आंकड़े
इसकी तीव्र गति ठोस आंकड़ों में दिखाई देती है। Ollama के मासिक डाउनलोड की संख्या 2023 की पहली तिमाही में 100,000 से बढ़कर 2026 की पहली तिमाही में 52 मिलियन हो गई — तीन वर्षों में 520 गुना वृद्धि। इसी अवधि में Hugging Face पर स्थानीय अनुमान के लिए स्वरूपित GGUF-स्वरूपित मॉडलों की संख्या 200 से बढ़कर 135,000 हो गई। llama.cpp, जो इन सभी का आधार है, GitHub पर 73,000 स्टार्स को पार कर चुका है।
2026 के उत्तरार्ध में मॉडल रिलीज़ परिदृश्य
ओलामा के आधिकारिक ब्लॉग पर नज़र डालें तो, 2026 के उत्तरार्ध में एक के बाद एक कई बड़ी रिलीज़ हुई हैं। 10 अगस्त को, मेटा सुपरइंटेलिजेंस लैब्स ने अपना पहला ओपन मॉडल, "म्यूज़ ग्लिमर" नामक 30 अरब पैरामीटर वाला मल्टीमॉडल मॉडल, अपाचे 2.0 लाइसेंस के तहत जारी किया; ठीक अगले दिन, 11 अगस्त को, एनवीडिया ने "नेमोट्रॉन 3.5 लाइटनिंग" की घोषणा की, जो मल्टी-स्टेप एजेंटिक कार्यों के लिए डिज़ाइन किया गया 30 अरब पैरामीटर वाला मॉडल है। 29 जून को, जेम्मा 4 को ऐप्पल सिलिकॉन के एमएलएक्स रनटाइम पर 90% तक तेज़ बनाने वाला एक अपडेट आया, जिससे कोडिंग-एजेंट उपयोग मामलों के लिए निष्पादन गति को बढ़ाने का प्रयास जारी रहा। ओलामा ने स्वयं 9 जुलाई को 88 मिलियन डॉलर की फंडिंग की घोषणा की और 8.9 मिलियन डेवलपर उपयोगकर्ताओं तक पहुंचने की सूचना दी। ओपन-वेट मॉडल इकोसिस्टम केवल "मॉडल जारी करने" से आगे बढ़कर वास्तविक वाणिज्यिक बुनियादी ढांचे का रूप ले रहा है।
क्वांटाइजेशन का अत्याधुनिक रूप: NVFP4 एक नया विकल्प
GGUF, AWQ और GPTQ के बाद, NVFP4 (NVIDIA के ब्लैकवेल आर्किटेक्चर के लिए डिज़ाइन किया गया एक 4-बिट फ्लोटिंग-पॉइंट फॉर्मेट) पर शोध 2026 तक एक नए क्वांटाइजेशन फॉर्मेट के रूप में तेजी से बढ़ा है। जून 2026 के एक अध्ययन में बताया गया कि 16 का ब्लॉक आकार सटीकता/भंडारण का सर्वोत्तम संतुलन प्रदान करता है, और स्केलस्वीप (मई 2026), जो स्वीप सर्च के माध्यम से प्रारंभिक ब्लॉक-स्केल मानों को अनुकूलित करता है, उन कई विधियों में से एक है जो अब यह रिपोर्ट कर रही हैं कि आक्रामक क्वांटाइजेशन भी पूर्ण-परिशुद्धता प्रदर्शन के 93% से अधिक को संरक्षित कर सकता है। पोस्ट-प्रोसेसिंग तकनीकें भी सामने आई हैं, जैसे एच-स्केल (अगस्त 2026), जो शून्य अतिरिक्त अनुमान-समय ओवरहेड के साथ द्वितीय-क्रम हेसियन-आधारित सन्निकटन का उपयोग करके प्रति-समूह स्केल मानों को परिष्कृत करती है - यह संकेत है कि क्वांटाइजेशन अनुसंधान स्वयं "वजन को कितना कम किया जा सकता है" से "वजन कम करने के बाद सटीकता को कैसे पुनः प्राप्त किया जाए" की ओर बढ़ रहा है।
केवी कैश (मेमोरी क्षेत्र जो जनरेशन के दौरान पिछले टोकन के मध्यवर्ती निरूपणों को रखता है, जो लंबे संदर्भ के साथ बढ़ता है) का संपीड़न भी समानांतर रूप से प्रगति कर रहा है। सेमकेवी (अगस्त 2026), जो महत्व स्कोर के आधार पर प्रति टोकन दो परिशुद्धता स्तरों में से एक को गतिशील रूप से निर्दिष्ट करता है, गुणवत्ता में अचानक गिरावट की समस्या से बचते हुए 6.0 गुना भंडारण कमी प्राप्त करने की रिपोर्ट करता है - और एक अनुकूलित क्वांटाइज़र के साथ जोड़े जाने पर 7.9 गुना कमी प्राप्त करता है। लंबे संदर्भों पर स्थानीय अनुमान के लिए, केवी-कैश संपीड़न उतना ही व्यावहारिक फोकस बन रहा है जितना कि स्वयं भार क्वांटाइजेशन।
क्या अनुमान के लिए मेमोरी में भार फिट करना पर्याप्त है?
KV कैश, वर्कस्पेस और रनटाइम ओवरहेड भी मेमोरी का उपयोग करते हैं।
अनुमान में संदर्भ की लंबाई और समवर्तीता को शामिल करें।संदर्भ
- सर्वश्रेष्ठ ओपन-वेट एलएलएम 2026: डीपसीक बनाम क्वेन बनाम किमी बनाम जीएलएम बनाम लामा
- एलएलएम क्वांटाइजेशन की व्याख्या: जीजीयूएफ बनाम एडब्ल्यूक्यू बनाम जीपीटीक्यू - संपूर्ण 2026 गाइड
- 2026 में स्थानीय एआई: ओलामा बेंचमार्क, $0 इन्फरेंस और प्रति-टोकन मूल्य निर्धारण का अंत
- एलएलएम क्वांटाइजेशन गाइड: जीजीयूएफ बनाम एडब्ल्यूक्यू बनाम जीपीटीक्यू बनाम बिट्सएंडबाइट्स की तुलना (2026)
- llama.cpp GitHub (ggml-org)
- ओलामा आधिकारिक ब्लॉग
- एच-स्केल पेपर (arXiv)
- स्केलस्वीप पेपर (arXiv)
- सेमकेवी पेपर (arXiv)
टिप्पणियाँ
पहले लॉग इन करें।
अभी कोई डेटा नहीं है।