Contents — find the section you need
सिमेंटिक सेगमेंटेशन एक छवि के प्रत्येक पिक्सेल को श्रेणी लेबल प्रदान करने का कार्य है। जहां ऑब्जेक्ट डिटेक्शन एक मोटे तौर पर, बाउंडिंग-बॉक्स स्तर का स्थानीयकरण कार्य है, वहीं सेगमेंटेशन बारीक, पिक्सेल-स्तर का क्षेत्रीय विभाजन करता है। 2026 तक, दो धाराएँ समानांतर रूप से चल रही थीं: ट्रांसफॉर्मर-आधारित विधियों के माध्यम से परिशोधन, और मूलभूत मॉडलों की ओर बदलाव जो किसी संकेत से मनमाना लक्ष्य निकाल सकते हैं।
यह लेख अनुसंधान प्रवृत्तियों पर केंद्रित है और संक्षेप में पहले आवश्यक अवधारणाओं का परिचय देता है।
 Meta AI
छवि: Meta AI लोगो, विकिमीडिया कॉमन्स
.svg)
दो सेगमेंटेशन समस्याएं एक नज़र में
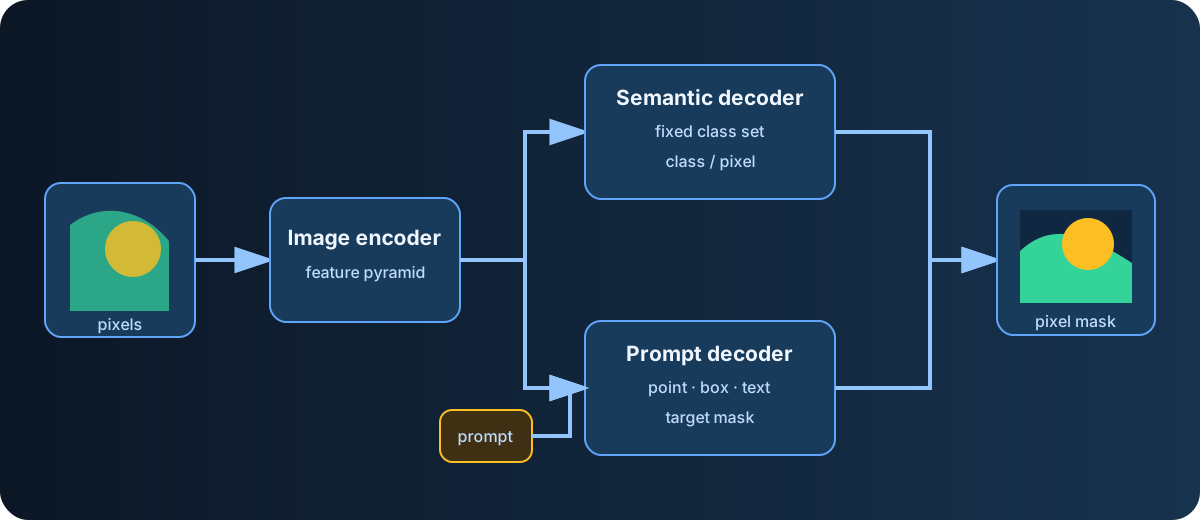
आरेख: डस्ककॉइल। यह निश्चित-श्रेणी लेबलिंग और प्रॉम्प्ट-कंडीशन्ड एक्सट्रैक्शन के बीच अंतर को सरल बनाता है।
वही पिक्सेल-स्तर मास्क दो अलग-अलग सवालों के जवाब दे सकता है। सिमेंटिक सेगमेंटेशन प्रशिक्षण के दौरान तय की गई श्रेणी में प्रत्येक पिक्सेल को असाइन करता है। प्रॉम्प्टेबल सेगमेंटेशन एक बिंदु, बॉक्स या टेक्स्ट द्वारा निर्दिष्ट लक्ष्य को निकालता है। यह अंतर निश्चित-श्रेणी mIoU पर प्रतिस्पर्धा करने वाली वंशावली को सेगमेंट एनीथिंग वंशावली से अलग रखता है, जो नए लक्ष्यों में लचीले स्थानांतरण को प्राथमिकता देती है।
मूल्यांकन मीट्रिक: mIoU
सेगमेंटेशन सटीकता का मूल्यांकन परंपरागत रूप से mIoU (मीन इंटरसेक्शन ओवर यूनियन) से किया जाता है, जो ऑब्जेक्ट डिटेक्शन के IoU को प्रति-श्रेणी आधार पर विस्तारित करता है। किसी दी गई श्रेणी c के लिए, IoU की गणना ग्राउंड-ट्रुथ क्षेत्र G_c और अनुमानित क्षेत्र P_c के बीच ओवरलैप से की जाती है, फिर सभी C श्रेणियों में औसत निकाला जाता है।
जब इसे प्रति-पिक्सेल वर्गीकरण समस्या के रूप में प्रशिक्षित किया जाता है, तो आमतौर पर उपयोग किया जाने वाला हानि फ़ंक्शन प्रति-पिक्सेल होता है। क्रॉस-एंट्रॉपी, सभी पिक्सेल पर औसत और योग किया गया।
यहाँ y_{n,c} ग्राउंड-ट्रुथ लेबल है — 1 यदि पिक्सेल n वास्तव में वर्ग c से संबंधित है, अन्यथा 0 — और \hat{y}_{n,c} मॉडल की अनुमानित संभावना है कि पिक्सेल n वर्ग c से संबंधित है।
ट्रांसफ़ॉर्मर-आधारित विधियों का अंतिम बिंदु: SegFormer और Mask2Former
CNN-आधारित विधियों (FCN, U-Net, आदि) के स्थान पर ट्रांसफ़ॉर्मर पर आधारित विधियाँ मुख्यधारा में आ गईं। SegFormer एक CNN की पदानुक्रमित संरचना को ट्रांसफ़ॉर्मर की वैश्विक मॉडलिंग क्षमता के साथ जोड़ता है, जिसमें एक पदानुक्रमित ट्रांसफ़ॉर्मर एनकोडर को एक हल्के MLP डिकोडर के साथ जोड़ा जाता है। इसे एक विश्वसनीय विधि माना जाता है। फिशआई और स्टैंडर्ड दोनों तरह की इमेज पर उच्च-सटीकता वाली विधि।
Mask2Former एक कदम आगे बढ़कर सेगमेंटेशन को क्वेरी-आधारित मास्क-वर्गीकरण समस्या के रूप में तैयार करता है। यह उच्च-रिज़ॉल्यूशन स्थानिक जानकारी को संरक्षित करने वाले पिक्सेल डिकोडर को एक ट्रांसफ़ॉर्मर डिकोडर के साथ जोड़ता है जो निश्चित संख्या में क्वेरी सीखता है, जहां प्रत्येक क्वेरी एक प्रासंगिक क्षेत्र पर ध्यान केंद्रित करके मास्क और उसकी श्रेणी का अनुमान लगाती है। Swin-L बैकबोन पर निर्मित, यह पैनोप्टिक, इंस्टेंस और सिमेंटिक - तीनों प्रकार के सेगमेंटेशन में अत्याधुनिक प्रदर्शन प्राप्त करता है, और मास्क्ड अटेंशन के परिचय से यह Mask R-CNN की तुलना में 8 गुना तेजी से अभिसरण करता है।
Mask2Former का "मास्क्ड अटेंशन" तेज़ क्यों है
Mask2Former की तेज़ अभिसरण और उच्च सटीकता के संयोजन के पीछे का तकनीकी आधार मास्क्ड अटेंशन है: जहां एक मानक ट्रांसफ़ॉर्मर डिकोडर पूरी इमेज पर क्रॉस-अटेंशन की गणना करता है, वहीं Mask2Former प्रत्येक क्वेरी के अटेंशन को पिछली परत पर अनुमानित मास्क के केवल अग्रभूमि क्षेत्र तक सीमित रखता है। पूरी इमेज की पुन: जांच करने के बजाय। प्रत्येक बार, तत्काल पूर्व भविष्यवाणी द्वारा निहित "स्थानीय रूप से प्रासंगिक क्षेत्र" तक सीमित करने से अनावश्यक गणना में कटौती होती है और स्थानीय विशेषताओं को अधिक सटीकता से निकाला जा सकता है।
समग्र आर्किटेक्चर में एक बैकबोन फीचर एक्सट्रैक्टर, एक पिक्सेल डिकोडर जो उच्च-रिज़ॉल्यूशन स्थानिक जानकारी को संरक्षित करता है, और एक 9-परत ट्रांसफ़ॉर्मर डिकोडर (100 सीखने योग्य क्वेरी रखने वाला) शामिल है। छोटी वस्तुओं को संभालने के लिए, यह एक मल्टी-स्केल रणनीति का भी उपयोग करता है, जिसमें पिक्सेल डिकोडर द्वारा उत्पादित फीचर पिरामिड (तीन रिज़ॉल्यूशन स्तर - 1/8, 1/16, 1/32) को राउंड-रॉबिन तरीके से ट्रांसफ़ॉर्मर-डिकोडर की क्रमिक परतों में फीड किया जाता है। यह डिज़ाइन तीनों प्रकार के विभाजन - पैनोप्टिक, इंस्टेंस और सिमेंटिक - में उत्कृष्ट प्रदर्शन प्राप्त करता है और मास्क आर-सीएनएन की तुलना में 8 गुना तेज़ी से अभिसरित होता है।
प्रॉम्प्ट-आधारित बदलाव: किसी भी चीज़ को विभाजित करने की परंपरा
एक अन्य प्रमुख प्रवृत्ति "प्रॉम्प्ट-आधारित" विभाजन है, जो किसी भी पूर्व निर्धारित निश्चित श्रेणी सूची से बाधित नहीं है। 2023 में मेटा द्वारा जारी किया गया सेगमेंट एनीथिंग मॉडल (SAM), इनपुट के रूप में कई प्रकार के संकेत लेता है — एक बिंदु, एक बाउंडिंग बॉक्स, एक रफ मास्क — और उनसे एक उच्च-गुणवत्ता वाला सेगमेंटेशन मास्क उत्पन्न करता है। यह बदलाव — एक निश्चित क्लास सूची से भविष्यवाणी करने के बजाय, संकेत के आधार पर एक मनमाना लक्ष्य निर्धारित करना — कंप्यूटर विज़न के आधारभूत मॉडलिंग की दिशा में एक महत्वपूर्ण कदम था।
इसके उत्तराधिकारी, SAM 2 ने एकल-स्तरीय ViT को Hiera से बदल दिया, जो मास्क्ड ऑटोएनकोडिंग के माध्यम से पूर्व-प्रशिक्षित एक बहु-स्तरीय पदानुक्रमित विज़न ट्रांसफ़ॉर्मर है, और वीडियो सेगमेंटेशन के लिए समर्थन जोड़ा। यह 37 ज़ीरो-शॉट डेटासेट पर 130 FPS पर चलता है और उच्च सटीकता (mIoU 58.9/81.7) बनाए रखता है।
2026 में मेटा द्वारा SAM 3 आया, जो एक टेक्स्ट संकेत या एक उदाहरण छवि द्वारा निर्दिष्ट "विज़ुअल कॉन्सेप्ट" का पता लगा सकता है, उसे सेगमेंट कर सकता है और ट्रैक कर सकता है। यह उसी दिशा में अगला कदम है — संकेत-आधारित, सामान्य-उद्देश्यीय सेगमेंटेशन — जिसने एक इससे भी आगे बढ़कर, पाठ में अवधारणा को स्पष्ट रूप से परिभाषित करने तक का स्तर हासिल किया जा सकता है।
SAM 3 का वास्तविक दुनिया में उपयोग: वीडियो सेगमेंटेशन प्रतियोगिताओं के परिणाम
2026 की शुरुआत से, SAM 3 पर आधारित व्यावहारिक अनुसंधान विभिन्न क्षेत्रों में तेजी से सामने आ रहा है। SAM 3 की प्रमुख विशेषता — पाठ संकेत के माध्यम से अवधारणा को स्पष्ट करना — को बार-बार विशिष्ट क्षेत्रों में अपनाया गया है: समुद्री निगरानी (MariSat, एक समुद्री डेटासेट जो SAM 3 को अर्ध-स्वचालित एनोटेशन पाइपलाइन में एकीकृत करता है) और संचार टावर निरीक्षण (अस्त-व्यस्त UAV हवाई छवियों से घटकों को अलग करना), आदि।
ECCV 2026 में आयोजित 8वीं LSVOS चैलेंज के MOSEv2 ट्रैक के परिणाम वीडियो सेगमेंटेशन की प्रगति का एक उपयोगी माप प्रदान करते हैं। SAM3Dual, SAM 3 पर आधारित एक प्रशिक्षण-मुक्त विधि जो दो अस्थायी मेमोरी शाखाओं को जोड़ती है — एक हाल के फ्रेम के लिए, दूसरी ऐतिहासिक संदर्भ के लिए — J&F स्कोर के साथ तीसरे स्थान पर रही। 64.37. कॉम्पिटिटिव मेमोरी रीडआउट, जिसने उसी प्रतियोगिता में दूसरा स्थान प्राप्त किया, मेमोरी से लक्ष्य जानकारी प्राप्त करते समय समान श्रेणी के "प्रतिस्पर्धी" वस्तुओं के साक्ष्य को स्पष्ट रूप से शामिल करता है, जिससे प्राथमिक मीट्रिक स्कोर 66.20 प्राप्त होता है। दोनों परिणाम इस बात पर जोर देते हैं कि वीडियो में समय के साथ वस्तु की पहचान को बनाए रखना (एक अनुक्रम में एक ही वस्तु को एक ही लक्ष्य के रूप में ट्रैक करना जारी रखना) एसएएम-परिवार के मॉडल वास्तव में कितना अच्छा प्रदर्शन करते हैं, यह निर्धारित करने वाली मुख्य चुनौती बनी हुई है।
लाइटवेटिंग और फ्यू-शॉट अनुकूलन के ठोस उदाहरण
सेगफॉर्मर/मास्क2फॉर्मर-परिवार की दक्षता को और आगे बढ़ाने के प्रयास भी जारी हैं। डीपीएनईएक्सटी (जुलाई 2026), वीआईटी-आधारित सघन भविष्यवाणी (विभाजन और गहराई अनुमान जैसे बहु-कार्य) के लिए एक हल्का डिकोडर, मानक डीपीटी (सघन भविष्यवाणी ट्रांसफार्मर) की तुलना में प्रशिक्षण योग्य मापदंडों को 78.6% तक कम करता है, जबकि सिटीस्केप्स और एनवाईयूवी2 दोनों पर अत्याधुनिक स्तर का प्रदर्शन बनाए रखता है। बेंचमार्क। ट्रेसक्लिप (जुलाई 2026), एक पूरी तरह से प्रशिक्षण-मुक्त विधि है जो CLIP के CLS-टोकन ध्यान में प्रत्येक पैच के व्यक्तिगत योगदान को अलग करके स्थानीय अर्थ संबंधी जानकारी को पुनर्प्राप्त करती है, और आठ शून्य-शॉट अर्थ संबंधी विभाजन बेंचमार्क में सबसे मजबूत पूर्व विधियों की तुलना में 1.3 से 4.5 अंकों तक mIoU सुधार दर्ज करती है।
कुछ-शॉट अनुकूलन के एक ठोस उदाहरण के लिए, HASTE (जुलाई 2026) है, जो उपग्रह इमेजरी से आपदा के बाद इमारतों को हुए नुकसान का तेजी से आकलन करने का एक मंच है। फाउंडेशन-मॉडल एम्बेडिंग का लाभ उठाकर, यह पूरी तरह से पर्यवेक्षित ResNet-50 बेसलाइन (पूरे डेटासेट के लिए लेबल पर प्रशिक्षित) की सटीकता से मेल खाता है, जबकि केवल बीसवें हिस्से के लेबल का उपयोग करता है, और इसने 2023 से अब तक 30 से अधिक वास्तविक आपदा प्रतिक्रियाओं - भूकंप, तूफान, जंगल की आग - में सहायता की है। यह फाउंडेशन-मॉडल युग में विभाजन के लक्ष्य का एक ठोस उदाहरण है: लेबलिंग के एक अंश पर उत्पादन-स्तरीय सटीकता। लागत।
किस विधि का उपयोग कब करें
इस बिंदु पर व्यावहारिक विश्लेषण इस प्रकार है: किसी निश्चित कार्य के लिए, जहाँ श्रेणियाँ पहले से ज्ञात हों (उदाहरण के लिए, सड़क दृश्य में कारें, पैदल यात्री, संकेत), SegFormer/Mask2Former परिवार की ट्रांसफ़ॉर्मर-आधारित विधियाँ सटीकता और दक्षता दोनों में श्रेष्ठ हैं; अज्ञात लक्ष्यों या सीमित परिणामों से निपटने की स्थितियों में, SAM परिवार के प्रॉम्प्ट-आधारित आधार मॉडल अपनी क्षमता प्रदर्शित करते हैं — और यह कार्य विभाजन और भी पुख्ता होता जा रहा है।
क्या उच्च समग्र mIoU छोटे अवरोधों के अच्छे विभाजन की गारंटी देता है?
औसत वर्ग- या आकार-विशिष्ट कमियों को छिपा सकते हैं। प्रासंगिक वर्गों, सीमाओं, गलत सकारात्मक परिणामों और छूटे हुए क्षेत्रों का निरीक्षण करें।
संदर्भ
- [SegFormer/Mask2Former तुलनात्मक मूल्यांकन पत्र] (MDPI)](https://www.mdpi.com/2073-8994/18/1/68)
- SAM से SAM 2 तक: मेटा के सेगमेंट एनीथिंग मॉडल में सुधारों की खोज (arXiv)
- SAM 3 आधिकारिक दस्तावेज़ीकरण (Ultralytics)
- फाउंडेशन मॉडल के युग में फ्यू-शॉट सिमेंटिक सेगमेंटेशन के लिए एक नया बेंचमार्क (arXiv)
- SAM3Dual (MOSEv2, LSVOS चैलेंज) पेपर (arXiv)
- मजबूत वीडियो ऑब्जेक्ट सेगमेंटेशन के लिए प्रतिस्पर्धी मेमोरी रीडआउट पेपर (arXiv)
- DPNeXt पेपर (arXiv) )
- ट्रेसक्लिप पेपर (arXiv)
- HASTE पेपर (arXiv)
टिप्पणियाँ
पहले लॉग इन करें।
अभी कोई डेटा नहीं है।