Contents — find the section you need
시맨틱 분할은 이미지의 모든 픽셀에 범주 레이블을 할당하는 작업입니다. 객체 탐지가 대략적인 경계 상자 수준의 위치 파악 작업이라면, 분할은 세밀한 픽셀 수준의 영역 분할을 수행합니다. 2026년 기준으로 두 가지 연구 흐름이 병행되고 있습니다. 하나는 트랜스포머 기반 방법을 통한 세분화이고, 다른 하나는 프롬프트에서 임의의 목표물을 추출할 수 있는 기초 모델 개발입니다.
본 글에서는 연구 동향에 초점을 맞추고 먼저 핵심 개념을 간략하게 소개합니다.
 Meta AI
이미지: Meta AI 로고, Wikimedia Commons
.svg)
두 가지 분할 문제 한눈에 보기
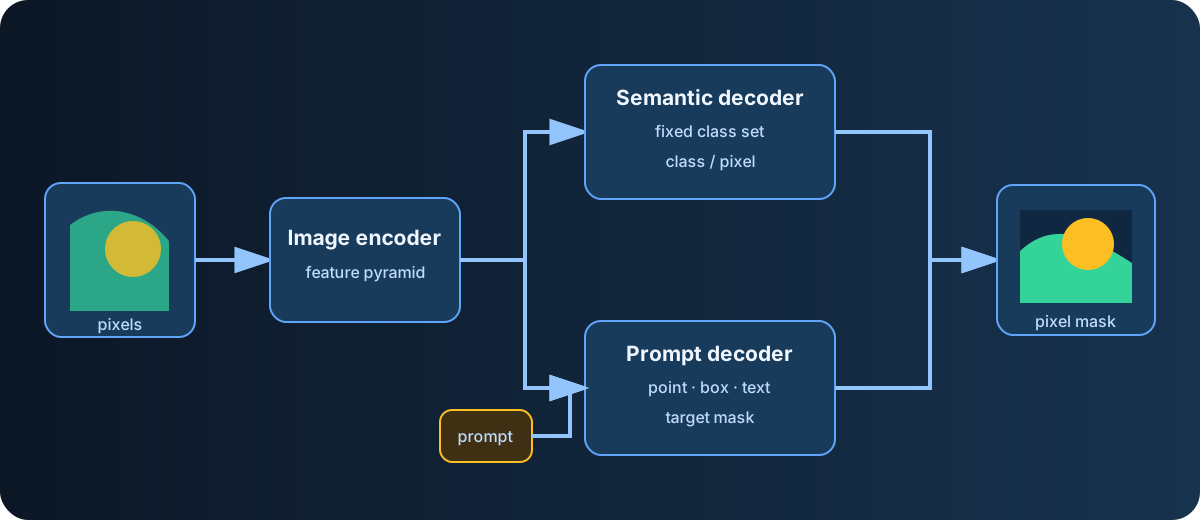
다이어그램: Duskcoil. 고정 클래스 레이블링과 프롬프트 조건부 추출의 차이를 단순화합니다.
동일한 픽셀 수준 마스크가 두 가지 다른 질문에 답할 수 있습니다. 의미론적 분할은 학습 중에 고정된 클래스에 모든 픽셀을 할당합니다. 프롬프트 기반 분할은 점, 상자 또는 텍스트로 지정된 대상을 추출합니다. 이러한 구분은 고정 클래스 mIoU를 기준으로 경쟁하는 계보와 새로운 대상으로의 유연한 전이를 우선시하는 '무엇이든 분할' 계보를 구분하는 데 도움이 됩니다.
평가 지표: mIoU
분할 정확도는 일반적으로 mIoU(평균 IoU)로 평가되며, 이는 객체 탐지의 IoU를 클래스별로 확장한 것입니다. 특정 클래스 c의 경우, IoU는 실제 영역 G_c와 예측 영역 P_c 사이의 겹침을 계산한 다음, 모든 C 클래스에 대해 평균을 냅니다.
픽셀 단위 분류 문제로 학습할 때 일반적으로 사용되는 손실 함수는 픽셀 단위 교차 엔트로피이며, 모든 픽셀에 대해 평균을 내고 합산합니다.
여기서 y_{n,c}는 정답 레이블입니다. 픽셀 n이 실제로 클래스 c에 속하면 1, 그렇지 않으면 0입니다. \hat{y}_{n,c}는 모델이 예측한 픽셀 n이 클래스 c에 속할 확률입니다.
트랜스포머 기반 방법의 최종 단계: SegFormer 및 Mask2Former
CNN 기반 방법(FCN, U-Net 등)을 대체하여 주류가 된 것은 트랜스포머를 기반으로 하는 방법입니다. SegFormer는 계층적 트랜스포머 인코더와 경량 MLP 디코더를 사용하여 CNN의 계층적 구조와 트랜스포머의 전역 모델링 능력을 결합합니다. 이 방법은 어안 렌즈 이미지와 일반 이미지 모두에서 높은 정확도와 신뢰성을 보이는 것으로 평가받고 있습니다.
Mask2Former는 한 단계 더 나아가, 분할을 쿼리 기반 마스크 분류로 공식화합니다. Mask2Former는 고해상도 공간 정보를 보존하는 픽셀 디코더와 고정된 개수의 쿼리를 학습하는 트랜스포머 디코더를 결합하여 문제를 해결합니다. 각 쿼리는 마스크와 그 범주를 예측하기 위해 관련 영역에 집중합니다. Swin-L 백본을 기반으로 구축된 Mask2Former는 파노라마, 인스턴스, 시맨틱 등 세 가지 분할 유형 모두에서 최첨단 성능을 달성하며, 마스크드 어텐션을 도입하여 Mask R-CNN보다 8배 빠른 수렴 속도를 제공합니다.
Mask2Former의 "마스크드 어텐션"이 빠른 이유
Mask2Former가 빠른 수렴과 높은 정확도를 동시에 달성하는 핵심 기술은 마스크드 어텐션입니다. 일반적인 트랜스포머 디코더는 이미지 전체에 대해 교차 어텐션을 수행하는 반면, Mask2Former는 각 쿼리의 어텐션을 이전 레이어에서 예측된 마스크의 전경 영역으로 제한합니다. 매번 이미지 전체를 다시 검사하는 대신, 바로 이전 예측에서 암시하는 "국부적으로 관련 있는 영역"에만 집중함으로써 불필요한 연산을 줄이고 지역 특징을 더욱 정확하게 추출합니다.
전반적으로 이 아키텍처는 백본 특징 추출기, 고해상도 공간 정보를 보존하는 픽셀 디코더, 그리고 9개 레이어로 구성된 트랜스포머 디코더(학습 가능한 쿼리 100개 저장)로 이루어져 있습니다. 작은 객체를 처리하기 위해 멀티스케일 전략을 사용하여 픽셀 디코더가 생성한 특징 피라미드(세 가지 해상도 레벨 - 1/8, 1/16, 1/32)를 라운드 로빈 방식으로 연속적인 트랜스포머-디코더 레이어에 입력합니다. 이 설계는 파노라마, 인스턴스, 시맨틱의 세 가지 분할 유형 모두에서 뛰어난 성능을 달성하며 Mask R-CNN보다 8배 빠르게 수렴합니다.
프롬프트 기반 분할의 변화: Segment Anything의 계보
또 다른 주요 흐름은 미리 정해진 고정된 범주 목록에 구애받지 않는 "프롬프트 기반" 분할입니다. 2023년 Meta에서 출시한 Segment Anything Model(SAM)은 점, 경계 상자, 대략적인 마스크 등 다양한 프롬프트를 입력으로 받아 고품질 분할 마스크를 생성합니다. 고정된 클래스 목록에서 예측하는 대신 프롬프트에 따라 임의의 대상을 분할하는 방식의 변화는 컴퓨터 비전의 기초 모델링에 큰 진전을 가져왔습니다.
후속 버전인 SAM 2는 단일 스케일 ViT를 마스크드 오토인코딩을 통해 사전 학습된 다중 스케일 계층적 비전 트랜스포머인 Hiera로 대체하고 비디오 분할 기능을 추가했습니다. 37개의 제로샷 데이터셋에서 130 FPS의 속도로 실행되면서 높은 정확도(mIoU 58.9/81.7)를 유지합니다.
2026년에는 Meta에서 SAM 3를 출시했는데, 이는 텍스트 프롬프트나 예시 이미지로 지정된 "시각적 개념"을 감지, 분할 및 추적할 수 있습니다. 이는 프롬프트 기반의 범용 분할이라는 동일한 방향의 다음 단계로, 텍스트로 개념을 지정할 수 있도록 한 단계 더 발전한 것입니다.
SAM 3, 실제 적용으로 나아가다: 비디오 분할 경진대회 결과
2026년 초부터 SAM 3를 기반으로 한 응용 연구가 진행되어 왔습니다. SAM 3는 다양한 분야에서 빠르게 등장하고 있습니다. SAM 3의 핵심 특징인 텍스트 프롬프트를 통한 개념 명시는 해양 감시(SAM 3를 반자동 주석 파이프라인에 통합한 해양 데이터셋인 MariSat) 및 통신탑 검사(복잡한 UAV 항공 이미지에서 구성 요소 추출) 등 여러 전문 분야에 적용되어 왔습니다.
ECCV 2026에서 개최된 제8회 LSVOS 챌린지의 MOSEv2 트랙 결과는 비디오 분할 기술의 발전 정도를 가늠하는 유용한 지표를 제공합니다. SAM 3를 기반으로 구축된 학습이 필요 없는 SAM3Dual은 최근 프레임용과 과거 맥락용 두 개의 시간 메모리 분기를 결합하여 J&F 점수 64.37점으로 3위를 차지했습니다. 같은 대회에서 2위를 차지한 Competitive Memory Readout은 메모리에서 목표 정보를 검색할 때 동일 클래스의 "경쟁자" 객체에 대한 정보를 명시적으로 통합하여 66.20점의 주요 지표 점수를 달성했습니다. 비디오에서 시간 경과에 따른 객체 식별 유지(시퀀스 전체에서 동일한 객체를 동일한 대상으로 계속 추적)는 SAM 계열 모델의 실제 성능을 결정하는 핵심 과제로 남아 있음을 강조합니다.
경량화 및 Few-Shot 적응의 구체적인 예
SegFormer/Mask2Former 계열의 효율성을 더욱 향상시키기 위한 노력도 계속되고 있습니다. ViT 기반 밀집 예측(세그멘테이션 및 깊이 추정과 같은 다중 작업)을 위한 경량 디코더인 DPNeXt(2026년 7월)는 표준 DPT(Dense Prediction Transformer) 대비 학습 가능한 매개변수를 78.6% 줄이면서도 Cityscapes 및 NYUv2 벤치마크 모두에서 최첨단 수준의 성능을 유지합니다. 각 패치의 개별적인 기여도를 CLIP의 CLS 토큰 어텐션에 통합하여 지역 의미 정보를 복구하는 완전 학습 불필요 방식인 TraceCLIP(2026년 7월)은 mIoU가 1.3에서 향상되었다고 보고합니다. 8개의 제로샷 시맨틱 분할 벤치마크에서 가장 강력한 기존 방법보다 4.5점 높은 성능을 보였습니다.
소규모 데이터셋 적응의 구체적인 예로는 위성 이미지를 이용해 재난 후 건물 피해를 신속하게 평가하는 플랫폼인 HASTE(2026년 7월 발표)가 있습니다. 기초 모델 임베딩을 활용하여 전체 데이터셋의 레이블로 학습된 완전 지도 학습 ResNet-50 기준 모델과 동일한 정확도를 달성하면서도 레이블 수는 20분의 1에 불과합니다. HASTE는 2023년 이후 지진, 허리케인, 산불 등 30건 이상의 실제 재난 대응에 사용되었습니다. 이는 기초 모델 시대의 분할이 추구하는 목표, 즉 레이블링 비용을 대폭 줄이면서도 생산 수준의 정확도를 달성하는 것을 보여주는 구체적인 사례입니다.
어떤 경우에 어떤 방법을 사용해야 할까요?
실질적인 분류는 다음과 같습니다. 범주가 미리 알려진 고정된 작업(예: 도로 장면의 자동차, 보행자, 표지판)의 경우, 트랜스포머 기반 방법이 적합합니다. SegFormer/Mask2Former 계열은 정확성과 효율성 면에서 우위를 점하고 있습니다. 미지의 목표물이나 소량의 데이터셋을 처리해야 하는 상황에서는 SAM 계열의 프롬프트 기반 모델이 강점을 보이며, 이러한 역할 분담은 점점 더 확고해지고 있습니다.
높은 전체 mIoU가 작은 장애물 분할에서 좋은 결과를 보장합니까?
평균값은 클래스 또는 크기별 약점을 숨길 수 있습니다. 관련 클래스, 경계, 오탐지 및 누락된 영역을 검사하십시오.
댓글
먼저 로그인해 주세요.
아직 데이터가 없습니다.