Contents — find the section you need
Semantik segmentasyon, bir görüntüdeki her bir piksele bir kategori etiketi atama işlemidir. Nesne tespiti kaba, sınırlayıcı kutu düzeyinde bir yerelleştirme görevi iken, segmentasyon ince taneli, piksel düzeyinde bölge bölme işlemi gerçekleştirir. 2026 itibariyle, iki akım paralel olarak ilerlemektedir: transformatör tabanlı yöntemlerle iyileştirme ve bir komuttan keyfi bir hedefi çıkarabilen temel modellere doğru bir kayma.
Bu makale, araştırma eğilimlerine odaklanmakta ve öncelikle temel kavramları kısaca tanıtmaktadır.
 Meta AI
Resim: Meta AI logosu, Wikimedia Commons
.svg)
İki Segmentasyon Problemi Bir Bakışta
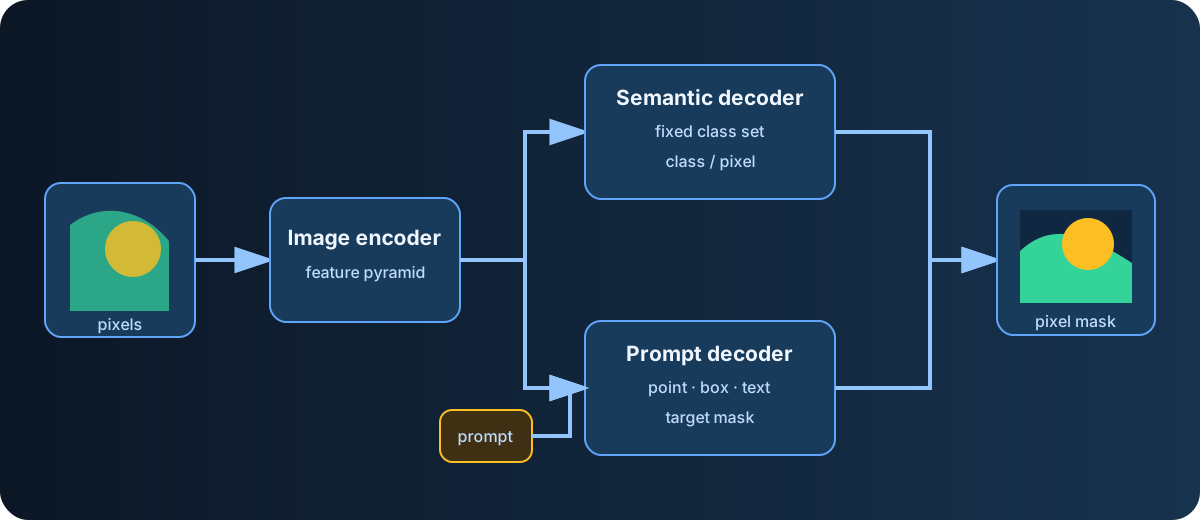
Diyagram: Duskcoil. Sabit sınıflı etiketleme ve istem koşullu çıkarma arasındaki ayrımı basitleştirir.
Aynı piksel düzeyindeki maske iki farklı soruyu yanıtlayabilir. Semantik segmentasyon Her pikseli eğitim sırasında sabitlenmiş bir sınıfa atar. İsteğe bağlı segmentasyon, bir nokta, kutu veya metinle belirtilen hedefi çıkarır. Bu ayrım, sabit sınıf mIoU'da yarışan soy hattını, yeni hedeflere esnek aktarımı önceliklendiren Her Şeyi Segment Et soy hattından ayrı tutar.
Değerlendirme Metriği: mIoU
Segmentasyon doğruluğu geleneksel olarak, nesne algılamanın IoU'sunu sınıf başına bir temele genişleten mIoU (Ortalama Kesişim Üzeri Birleşim) ile değerlendirilir. Belirli bir sınıf c için, IoU, gerçek bölge G_c ile tahmin edilen bölge P_c arasındaki örtüşmeden hesaplanır, ardından tüm C sınıfları arasında ortalama alınır.
Bunu piksel başına sınıflandırma problemi olarak eğitirken, yaygın olarak kullanılan kayıp fonksiyonu, tüm pikseller arasında ortalama alınan ve toplanan piksel başına çapraz entropidir.
Burada y_{n,c} gerçek etikettir — piksel n gerçekten c sınıfına aitse 1, aksi takdirde 0 — ve \hat{y}_{n,c}, modelin piksel n'ün c sınıfına ait olma olasılığını tahmin etmesidir.
Transformer Tabanlı Yöntemlerin Son Noktası: SegFormer ve Mask2Former
CNN tabanlı yöntemlerin (FCN, U-Net ve benzerleri) yerini alan ana akım yöntemler, bir transformer etrafında oluşturulmuş yöntemlerdir. SegFormer, hiyerarşik bir transformer kodlayıcıyı hafif bir MLP kod çözücü ile eşleştirerek, bir CNN'nin hiyerarşik yapısını bir transformer'ın küresel modelleme yeteneğiyle birleştirir. Hem balık gözü hem de standart optiklerde güvenilir, yüksek doğruluklu bir yöntem olarak kabul edilir. Görüntü.
Mask2Former, segmentasyonu sorgu tabanlı bir maske sınıflandırma problemi olarak formüle ederek bir adım daha ileri gidiyor. Yüksek çözünürlüklü uzamsal bilgiyi koruyan bir piksel kod çözücüyü, her sorgunun bir maskeyi ve kategorisini tahmin etmek için ilgili bir bölgeye odaklandığı sabit sayıda sorgu öğrenen bir transformatör kod çözücü ile eşleştiriyor. Swin-L omurgası üzerine kurulu olan bu algoritma, üç segmentasyon türünün (panoptik, örnek ve semantik) tamamında en iyi performansı elde ediyor ve maskeli dikkat mekanizmasının eklenmesiyle Mask R-CNN'den 8 kat daha hızlı yakınsıyor.
Mask2Former'ın "Maskeli Dikkat" Mekanizması Neden Hızlı?
Mask2Former'ın hızlı yakınsamayı yüksek doğrulukla birleştirmesinin teknik çekirdeği maskeli dikkat mekanizmasıdır: standart bir transformatör kod çözücü tüm görüntüye karşı çapraz dikkat hesaplarken, Mask2Former her sorgunun dikkatini yalnızca önceki katmanda tahmin edilen maskenin ön plan bölgesine sınırlandırır. Her seferinde tüm görüntüyü yeniden incelemek yerine, daraltma işlemi... Hemen önceki tahminin ima ettiği "yerel olarak ilgili bölgeye" kadar indirgeme, gereksiz hesaplamaları azaltırken yerel özellikleri daha doğru bir şekilde çıkarır.
Genel mimari, bir omurga özellik çıkarıcı, yüksek çözünürlüklü uzamsal bilgileri koruyan bir piksel kod çözücü ve 9 katmanlı bir transformatör kod çözücüden (100 öğrenilebilir sorgu tutar) oluşur. Küçük nesneleri işlemek için, piksel kod çözücünün ürettiği özellik piramidini (üç çözünürlük seviyesi - 1/8, 1/16, 1/32) ardışık transformatör kod çözücü katmanlarına sırayla besleyen çok ölçekli bir strateji de kullanır. Bu tasarım, üç segmentasyon türünün (panoptik, örnek ve semantik) tamamında güçlü performans elde eder ve Mask R-CNN'den 8 kat daha hızlı yakınsar.
İsteme Dayalı Değişim: Her Şeyi Segmentleme Soy Ağacı
Bir diğer önemli akım ise, önceden belirlenmiş sabit bir kategori listesiyle sınırlı olmayan "isteme tabanlı" segmentasyondur. Her Şeyi Segmentleme Modeli (SAM), Meta tarafından 2023'te piyasaya sürülen SAM, bir nokta, bir sınırlayıcı kutu, kaba bir maske gibi çeşitli girdileri alarak bunlardan yüksek kaliteli bir segmentasyon maskesi oluşturuyor. Bu değişim - sabit bir sınıf listesinden tahmin etmek yerine, bir girdiye dayalı olarak keyfi bir hedef belirleme - bilgisayar görüşünün temel modellemesine doğru büyük bir ivme kazandırdı.
Halefi olan SAM 2, tek ölçekli ViT'yi, maskeli otomatik kodlama yoluyla önceden eğitilmiş çok ölçekli hiyerarşik bir Vision Transformer olan Hiera ile değiştirdi ve video segmentasyonuna destek ekledi. 37 sıfır atışlı veri kümesinde 130 FPS hızında çalışırken yüksek doğruluk (mIoU 58.9/81.7) sağlıyor.
2026'da Meta'dan SAM 3 geldi; bu, bir metin girdisi veya örnek bir görüntü ile belirtilen bir "görsel kavramı" algılayabilir, segmentasyon yapabilir ve izleyebilir. Bu, aynı yönde bir sonraki adımdır - girdi tabanlı, genel amaçlı segmentasyon - bir üst seviyeye, bir kavramı belirtmeye kadar yükseltilmiştir. metin.
SAM 3 Gerçek Dünya Uygulamalarına Ulaşıyor: Video Bölümleme Yarışmalarından Sonuçlar
2026 yılının başından bu yana, SAM 3 üzerine kurulu uygulamalı araştırmalar çeşitli alanlarda hızla ortaya çıkıyor. SAM 3'ün belirleyici özelliği - bir kavramı metin istemiyle belirtme - tekrar tekrar uzmanlaşmış alanlara aktarıldı: denizcilik gözetimi (SAM 3'ü yarı otomatik bir açıklama hattına entegre eden bir denizcilik veri seti olan MariSat) ve iletişim kulesi denetimi (karmaşık İHA hava görüntülerinden bileşenleri ayıklama) gibi.
ECCV 2026'da düzenlenen 8. LSVOS Yarışması'nın MOSEv2 parkurundan elde edilen sonuçlar, video bölümlemenin ne kadar ilerlediğinin yararlı bir göstergesini sunuyor. SAM 3 üzerine kurulu, iki zamansal bellek dalını - biri son kareler için, diğeri geçmiş bağlam için - birleştiren eğitim gerektirmeyen bir yöntem olan SAM3Dual, 64,37'lik bir J&F puanıyla üçüncü oldu. Rekabetçi Aynı yarışmada ikinci olan Memory Readout, hedef bilgileri bellekten alırken aynı sınıfa ait "rakip" nesneler hakkındaki kanıtları açıkça dahil ederek 66,20'lik birincil metrik puanı elde etti. Her iki sonuç da, videoda zaman içinde nesne kimliğini korumanın (bir sekans boyunca aynı nesneyi aynı hedef olarak izlemeye devam etmenin), SAM ailesi modellerinin gerçekte ne kadar iyi performans gösterdiğini belirleyen temel zorluk olmaya devam ettiğini vurguluyor.
Hafifletme ve Az Sayıda Çekimle Uyarlamanın Somut Örnekleri
SegFormer/Mask2Former ailesinin verimliliğini daha da artırma çabaları da devam ediyor. ViT tabanlı yoğun tahmin (segmentasyon artı derinlik tahmini gibi çoklu görev çalışmaları) için hafif bir kod çözücü olan DPNeXt (Temmuz 2026), Cityscapes ve NYUv2 kıyaslamalarında en üst düzey performansı korurken, standart bir DPT'ye (Yoğun Tahmin Dönüştürücüsü) kıyasla eğitilebilir parametreleri %78,6 oranında azaltıyor. TraceCLIP (Temmuz 2026), her bir yamanın CLIP'in CLS-token dikkat mekanizmasına olan bireysel katkısını izole ederek yerel anlamsal bilgiyi geri kazanan, tamamen eğitim gerektirmeyen bir yöntem, sekiz sıfır atışlı anlamsal segmentasyon kıyaslamasında en güçlü önceki yöntemlere göre 1,3 ila 4,5 puanlık mIoU iyileştirmeleri bildirmektedir.
Az sayıda örnekle uyarlamaya somut bir örnek olarak, uydu görüntülerinden afet sonrası bina hasarını hızla değerlendirmek için bir platform olan HASTE (Temmuz 2026) gösterilebilir. Temel model gömülü vektörlerinden yararlanarak, yalnızca yirmi kat daha az etiket kullanarak, tamamen denetimli bir ResNet-50 temel modelinin (tüm veri kümesi için etiketlerle eğitilmiş bir model) doğruluğuna ulaşır ve 2023'ten beri 30'dan fazla gerçek dünya afet müdahalesini (depremler, kasırgalar, orman yangınları) desteklemiştir. Bu, segmentasyonun temel model çağında hedeflediği şeyin somut bir örneğidir: etiketlemenin çok daha azıyla üretim kalitesinde doğruluk. maliyet.
Hangi Akımı Ne Zaman Kullanmalı
Bu noktadaki pratik ayrım şöyledir: Kategorilerin önceden bilindiği sabit bir görev için (örneğin, arabalar, yayalar, yol sahnesindeki işaretler), SegFormer/Mask2Former ailesindeki transformatör tabanlı yöntemler hem doğruluk hem de verimlilik açısından avantajlıdır; bilinmeyen hedefleri veya az sayıda örnek içeren durumları ele almayı gerektiren durumlarda, SAM ailesine ait istem tabanlı temel modeller güçlerini gösterir ve bu iş bölümü giderek daha da sağlamlaşır.
Yüksek genel mIoU, iyi küçük engel segmentasyonunu garanti eder mi?
Ortalamalar, sınıf veya boyuta özgü zayıflıkları gizleyebilir. İlgili sınıfları, sınırları, yanlış pozitifleri ve kaçırılan bölgeleri inceleyin.
Referanslar
- [SegFormer/Mask2Former Karşılaştırmalı Değerlendirme Makalesi] (MDPI)](https://www.mdpi.com/2073-8994/18/1/68)
- SAM'den SAM 2'ye: Meta'nın Her Şeyi Bölümleme Modelindeki İyileştirmeleri Keşfetme (arXiv)
- SAM 3 Resmi Dokümantasyonu (Ultralytics)
- Temel Modeller Çağında Az Sayıda Örnekle Anlamsal Bölümleme için Yeni Bir Kıyaslama (arXiv)
- SAM3Dual (MOSEv2, LSVOS Yarışması) Makalesi (arXiv)
- Sağlam Video Nesne Bölümlemesi için Rekabetçi Bellek Okuma Makalesi (arXiv)
- DPNeXt Makalesi (arXiv)
- TraceCLIP Kağıdı (arXiv)
- HASTE Kağıdı (arXiv)
Yorumlar
Lütfen önce giriş yapın.
Henüz veri yok.