Contents — find the section you need
वर्ल्ड मॉडल एक सामान्य शब्द है जिसका उपयोग उस मॉडल के लिए किया जाता है जो यह अनुमान लगाना सीखता है कि किसी एजेंट द्वारा कोई क्रिया करने पर वातावरण की स्थिति में क्या परिवर्तन आएगा। रोबोटिक्स और रीइन्फोर्समेंट लर्निंग में, यह "वास्तविक दुनिया में कार्य करने से पहले अपने दिमाग में चीजों को आज़माने" के लिए एक आंतरिक सिम्युलेटर के रूप में कार्य करता है; वीडियो जनरेशन एआई के संदर्भ में, यह "न केवल विश्वसनीय दिखने वाले वीडियो उत्पन्न करने, बल्कि भौतिक नियमों के अनुसार वातावरण का अनुकरण करने" के लिए आधार का काम करता है। यह एक ऐसी अवधारणा है जिसने पिछले कुछ वर्षों में दोनों दिशाओं से तेजी से ध्यान आकर्षित किया है।
 NVIDIA Cosmos
छवि: NVIDIA लोगो, विकिमीडिया कॉमन्स। यहां उस कंपनी को दर्शाया गया है जो भौतिक कृत्रिम बुद्धिमत्ता के लिए कॉसमॉस श्रृंखला के विश्व आधार मॉडल विकसित कर रही है।

एक आरेख में विश्व मॉडल
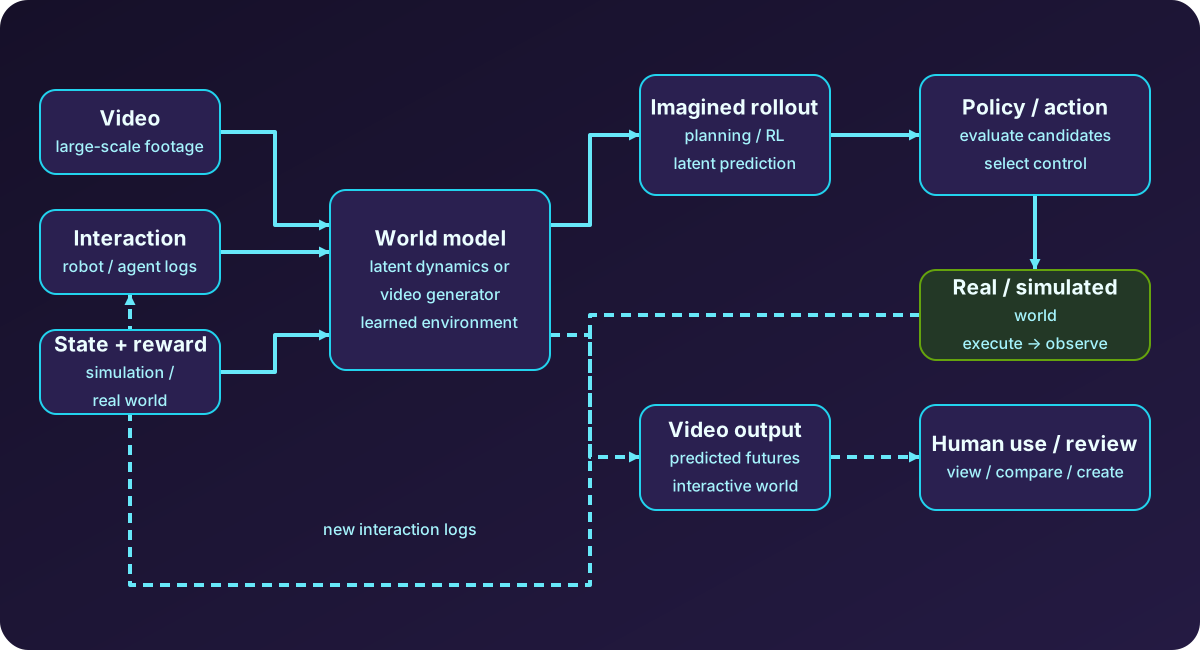
आरेख: डस्ककॉइल द्वारा निर्मित। एक सरलीकृत एकल आरेख जो मॉडल-आधारित सुदृढ़ीकरण अधिगम के लिए आंतरिक सिम्युलेटर के रूप में उपयोग और वीडियो-निर्माण मॉडल के रूप में उपयोग को संयोजित करता है।
विश्व मॉडल को समझने के लिए अक्ष दो प्रश्नों में विभाजित होता है: क्या भविष्यवाणी की जा रही है (कच्चे वीडियो पिक्सेल, या एक संपीड़ित अव्यक्त प्रतिनिधित्व), और इसका उपयोग किस लिए किया जा रहा है (नीति अधिगम के लिए एक आंतरिक सिम्युलेटर, या मानव द्वारा देखने के लिए वीडियो निर्माण)। एक ही शब्द "वर्ल्ड मॉडल" का प्रयोग रोबोट के सिमुलेशन से वास्तविक दुनिया में सीखने की प्रक्रिया को आधार देने वाले संभाव्य अव्यक्त गतिकी मॉडल (जैसे ड्रीमर) या अरबों मापदंडों वाले वीडियो जनरेशन मॉडल (जैसे सोरा या जिनी) के लिए किया जा सकता है। यह एक ऐसा क्षेत्र है जहां संदर्भ स्पष्ट न होने पर चर्चाएँ एक-दूसरे से बेमेल हो सकती हैं।
उत्पत्ति: हा और श्मिधुबर के मूल शोध पत्र से ड्रीमरV3 तक
"वर्ल्ड मॉडल" शब्द का वर्तमान अर्थ में प्रचलन डेविड हा और जुर्गन श्मिधुबर के 2018 के शोध पत्र से शुरू होता है। उनके सेटअप में, एक VAE (वैरिएशनल ऑटोएनकोडर) दृश्य अवलोकनों को एक संक्षिप्त निरूपण में संपीड़ित करता है, और एक RNN (LSTM) यह अनुमान लगाता है कि वह निरूपण समय के साथ कैसे बदलता है; उन्होंने दिखाया कि एक एजेंट इस सीखे हुए अव्यक्त स्थान के "अंदर" ही एक नीति को प्रशिक्षित कर सकता है।
2019 में PlaNet में इस डिज़ाइन को काफी बेहतर बनाया गया, जिसके RSSM (रिकरेंट स्टेट-स्पेस मॉडल) ने नियतात्मक और यादृच्छिक घटकों को मिलाकर बहु-चरणीय पूर्वानुमान की सटीकता और स्थिरता में उल्लेखनीय सुधार किया। जहां PlaNet मॉडल प्रेडिक्टिव कंट्रोल (MPC) के रूप में प्रत्येक चरण पर एक योजना को पुनः हल करता था, वहीं बाद में आए Dreamer ने इसे और आगे बढ़ाया और विश्व मॉडल के भीतर बैकप्रॉपैगेशन के माध्यम से सीधे एक नीति (अभिनेता) और मूल्य फ़ंक्शन (आलोचक) सीखा - यह डिज़ाइन तब से "Dreamer परिवार" के लिए मूल टेम्पलेट बन गया है। DreamerV2 ने असतत अव्यक्त निरूपणों को प्रस्तुत किया, और DreamerV3, जो 2025 में नेचर में प्रकाशित हुआ, ने निश्चित हाइपरपैरामीटर ट्यूनिंग के बिना विविध डोमेन - जिसमें Minecraft में हीरे की खुदाई भी शामिल है - में सामान्यीकृत प्रदर्शन प्रदर्शित किया, जिससे मॉडल-आधारित सुदृढीकरण सीखने में विश्व मॉडल की व्यावहारिक उपयोगिता का स्तर काफी बढ़ गया।
जनरेटिव एआई की ओर से अभिसरण: सोरा, जिनी, वर्ल्ड लैब्स
रीइन्फोर्समेंट लर्निंग से अलग, वीडियो जनरेशन एआई की ओर से भी "वर्ल्ड मॉडल" शब्द का प्रयोग शुरू हुआ। 2024 में, ओपनएआई ने वीडियो जनरेशन मॉडल सोरा पर अपनी तकनीकी रिपोर्ट में तर्क दिया कि "वीडियो जनरेशन मॉडल को स्केल करना भौतिक दुनिया के सामान्य प्रयोजन वाले सिमुलेटर बनाने की दिशा में एक आशाजनक मार्ग है," और कैनवास पर पेंट के निशान बने रहने और हैमबर्गर खाने के बाद बचे हुए दांतों के निशान जैसे उदाहरण देते हुए बताया कि सोरा ने भौतिक नियमों और कार्य-कारण के कुछ पहलुओं को अप्रत्यक्ष रूप से सीख लिया है।
Google DeepMind की Genie श्रृंखला ने इस दिशा में और भी प्रगति की: दिसंबर 2024 में, Genie 2 ने दिखाया कि यह एक ही छवि से एक नियंत्रणीय 3D वातावरण उत्पन्न कर सकता है, और अगस्त 2025 तक, Genie 3 एक टेक्स्ट प्रॉम्प्ट से 24 फ्रेम प्रति सेकंड और 720p रिज़ॉल्यूशन पर स्थायी, मिनटों तक चलने वाले, वास्तविक समय में अन्वेषण योग्य 3D दुनिया उत्पन्न कर सकता है। DeepMind इसे रोबोटिक्स में नेविगेशन, धारणा और दीर्घकालिक तर्क के लिए प्रशिक्षण डेटा उत्पन्न करने के एक स्केलेबल तरीके के रूप में प्रस्तुत करता है, और फरवरी 2026 में यह बताया गया कि Waymo ने स्वायत्त-ड्राइविंग सिमुलेशन के लिए इस तकनीक को अपनाया है।
स्टैनफोर्ड की फी-फी ली द्वारा स्थापित वर्ल्ड लैब्स ने नवंबर 2025 में अपने वाणिज्यिक उत्पाद मार्बल की घोषणा की। मार्बल टेक्स्ट, छवियों या वीडियो के अंशों से स्थायी, डाउनलोड करने योग्य 3D वातावरण (गॉसियन स्प्लैटिंग, मेश या वीडियो के रूप में निर्यात करने योग्य) उत्पन्न करता है। जून 2026 में प्रकाशित एक निबंध में, ली ने विश्व मॉडलों को कार्यात्मक रूप से तीन श्रेणियों में वर्गीकृत किया: रेंडरर (मानव आँखों द्वारा देखने के लिए वीडियो आउटपुट करता है), सिम्युलेटर (एक ज्यामितीय और भौतिक रूप से सटीक प्रतिनिधित्व आउटपुट करता है जिसका उपयोग प्रोग्राम गणना के लिए कर सकता है), और प्लानर (अवलोकनों और एक लक्ष्य से अगली क्रिया आउटपुट करता है) - इस प्रकार सोरा और जिनी जैसे वीडियो-जनरेशन सिस्टम को रेंडरर के करीब, रोबोट-लर्निंग डायनेमिक्स मॉडल को सिम्युलेटर के करीब और वीएलए को प्लानर के करीब रखा गया है।
एनवीडिया कॉसमॉस: रोबोटिक्स के लिए एक विश्व आधार मॉडल
रोबोटिक्स उद्योग में तेजी से लोकप्रिय हो रहा एक दृष्टिकोण एनवीडिया की कॉसमॉस श्रृंखला है। जून 2026 में घोषित कॉसमॉस 3, एक मिश्रित-ट्रांसफॉर्मर आर्किटेक्चर को अपनाता है जो दृश्य तर्क, विश्व निर्माण और क्रिया पूर्वानुमान को एक ही मॉडल में एकीकृत करता है, और एक ही फ्रेमवर्क के भीतर कई तौर-तरीकों - पाठ, छवि, वीडियो, पर्यावरणीय ऑडियो और क्रिया - को संभालता है। इसका लक्ष्य एक डेटा-जनरेशन पाइपलाइन है: वास्तविक रोबोट आर्म पर हजारों घंटों के परीक्षण चलाने के बजाय, किसी कार्य को करते हुए रोबोट के सिम्युलेटेड वीडियो की बड़ी मात्रा उत्पन्न करना, उस डेटा पर एक नीति को प्रशिक्षित करना और फिर उसे वास्तविक हार्डवेयर पर तैनात करना। NVIDIA ने एजाइल रोबोट्स, ब्लैक फॉरेस्ट लैब्स, रनवे और स्किल्ड एआई सहित भागीदारों के साथ कॉसमॉस गठबंधन का गठन किया है, जो वर्ल्ड फाउंडेशन मॉडल के लिए एक खुला पारिस्थितिकी तंत्र विकसित कर रहा है।
जनरेटिव है या नहीं: लेकुन का JEPA प्रति-अक्ष के रूप में
सोरा, जिनी और कॉसमॉस में जो समानता है, वह है पिक्सेल (या उनके निकट का प्रतिनिधित्व) को सीधे उत्पन्न करने वाला डिज़ाइन। मेटा एआई के पूर्व मुख्य एआई वैज्ञानिक यान लेकुन ने जनरेटिव दृष्टिकोण के प्रति हमेशा ही संशयपूर्ण रुख अपनाया है। उनका प्रस्तावित जेईपीए (जॉइंट एम्बेडिंग प्रेडिक्टिव आर्किटेक्चर) एक ऐसा डिज़ाइन है जो एक अमूर्त प्रतिनिधित्व स्थान के भीतर भविष्यवाणी करके और कभी भी पिक्सेल या टोकन उत्पन्न न करके एक स्पष्ट रेखा खींचता है। इस डिज़ाइन दर्शन पर निर्मित वी-जेईपीए 2 ने लगभग दस लाख घंटे के इंटरनेट वीडियो पर पूर्व-प्रशिक्षण और केवल 62 घंटे के रोबोट हेरफेर डेटा पर परिष्करण के बाद शून्य-शॉट रोबोट हेरफेर कार्यों में लगभग 80% सफलता प्राप्त की है। लेकुन ने 2026 की शुरुआत में मेटा को छोड़ दिया, पेरिस में एएमआई लैब्स की स्थापना की और एक अरब डॉलर से अधिक की प्रारंभिक निधि जुटाकर एक सामान्य-उद्देश्यीय विश्व मॉडल के निर्माण पर ध्यान केंद्रित किया - अब वे अपने इस दावे की जाँच कर रहे हैं कि "विश्व मॉडल के रूप में जनरेटिव मॉडल एक गतिरोध हैं"।
2026 तक, जनरेटिव और नॉन-जनरेटिव (JEPA-शैली) दृष्टिकोणों में से कौन सा बेहतर है, यह अभी तक तय नहीं हो पाया है। जनरेटिव मॉडल की खूबी यह है कि वे ऐसा वीडियो बनाते हैं जिसे मनुष्य सीधे अपनी आंखों से देख कर उसका मूल्यांकन कर सकते हैं, जबकि JEPA-शैली के दृष्टिकोणों को अमूर्त निरूपण में भविष्यवाणी करने के कारण गणनात्मक दक्षता और दीर्घकालिक पूर्वानुमान स्थिरता में बढ़त हासिल करने वाला माना जाता है — लेकिन बड़े पैमाने पर वास्तविक दुनिया में तैनाती के मामले में अभी तक किसी भी पक्ष ने निर्णायक बढ़त साबित नहीं की है।
खुली चुनौतियाँ: भौतिक संगति, दीर्घकालिक सुसंगति और मूल्यांकन
भौतिक संगति: सोरा द्वारा बनाए गए वीडियो में भौतिक नियमों के उल्लंघन के कई ठोस उदाहरण सामने आए हैं — गुरुत्वाकर्षण की अनदेखी करते हुए वस्तुओं का तैरना, मोमबत्ती की लौ का न हिलना, चींटी के पैरों की गलत संख्या, कांच के टूटने पर टुकड़ों का असामान्य व्यवहार। विश्लेषण से पता चला है कि शक्तिशाली मॉडल भी गुरुत्वाकर्षण, वस्तु स्थायित्व और कारण-कार्य संगति के मामले में विफल हो जाते हैं। इस समय तटस्थ आकलन यह है कि यद्यपि सोरा 2 ने 3डी संरचना और भौतिक कारण-कार्य संबंध के बारे में "कुछ" सीखा है, लेकिन वह "कुछ" पारंपरिक भौतिकी इंजन के समान नहीं है।
दीर्घकालिक सुसंगति: क्या किसी वातावरण की स्थिति को दसियों सेकंड से अधिक समय तक बिना बिगड़े बनाए रखा जा सकता है, यह एक अनसुलझी चुनौती बनी हुई है। 2026 में प्रस्तावित मूल्यांकन मानदंड, जैसे कि वर्ल्डरोमबेंच, चार अक्षों - क्रिया की सटीकता, दृश्य विघटन (विचलन), भौतिक संगति और स्मृति संगति (क्या पहले देखी गई जगहों और वस्तुओं को याद रखा जाता है) - के आधार पर दीर्घकालिक स्थिरता का आकलन करते हैं और बताते हैं कि कई मौजूदा मूल्यांकन विधियां शुरू से ही केवल 5-10 सेकंड की छोटी अवधियों पर ही विचार कर रही थीं।
मूल्यांकन की कठिनाई: "अच्छे विश्व मॉडल" को मात्रात्मक रूप से कैसे मापा जाए, इस पर भी अभी तक कोई आम सहमति नहीं है। उत्पन्न वीडियो की दृश्यात्मक सहजता और रोबोट नियंत्रण कार्यों में इसकी उपयोगिता हमेशा एक जैसी नहीं होती, और क्योंकि आउटपुट का अर्थपूर्ण पैमाना अलग-अलग मॉडलों में भिन्न होता है, इसलिए यह बताया गया है कि मॉडलों के बीच प्रक्षेप पथों की निष्पक्ष तुलना करना कठिन है।
गणना लागत: बड़े पैमाने पर विश्व मॉडल का मूल्यांकन और प्रशिक्षण महंगा होता है - एक API कॉल की लागत कथित तौर पर एक डॉलर से अधिक हो सकती है। लंबी अवधि के कार्यों को सीखने और उनका मूल्यांकन करने वाले मॉडल एक ही प्रतिक्रिया में लगभग 100,000 टोकन उत्पन्न कर सकते हैं, जो स्वयं अनुसंधान की पुनरुत्पादकता में बाधा बन रहा है।
रोबोट लर्निंग के साथ संबंध बिंदु
रोबोटिक्स में विश्व मॉडल के प्रत्यक्ष अनुप्रयोग का एक प्रमुख उदाहरण वीडियो वर्ल्ड मॉडल 1X टेक्नोलॉजीज द्वारा अपने स्वयं के ह्यूमनॉइड रोबोट, NEO के लिए विकसित किया गया है (विवरण के लिए "मानव रोबोट में प्रौद्योगिकी रुझान" देखें)। वह डिज़ाइन जिसमें 14 अरब पैरामीटर वाला वीडियो जनरेशन मॉडल "कार्य पूर्ण होने का एक छोटा वीडियो" तैयार करता है, जिसे बाद में इनवर्स डायनेमिक्स मॉडल के माध्यम से वास्तविक मोटर कमांड में परिवर्तित किया जाता है, रेंडरर (वीडियो जनरेशन) को प्लानर (एक्शन जनरेशन) से सीधे जोड़ने का एक ठोस उदाहरण है।
क्लासिक रीइन्फोर्समेंट लर्निंग के संदर्भ में, मॉडल-आधारित रीइन्फोर्समेंट लर्निंग (MBRL) ने वर्षों से इस अवधारणा को अधिक व्यावहारिक रूप में प्रस्तुत किया है। एक विश्व मॉडल \hat f_\theta को सीखने का डिज़ाइन, जो एक स्थिति s और क्रिया a से अगली स्थिति का अनुमान लगाता है, वास्तविक हार्डवेयर पर तैनात करने से पहले इसके भीतर संभावित क्रिया अनुक्रमों का मूल्यांकन करना, डोमेन यादृच्छिकीकरण के माध्यम से पूर्वानुमान त्रुटि संचय से कैसे निपटा जाता है, और सिम से वास्तविक में जाने की चरणबद्ध प्रक्रिया — इन सभी का विस्तृत विवरण "मॉडल-आधारित रीइन्फोर्समेंट लर्निंग और सिम-टू-रियल का परिचय" में दिया गया है। वीडियो-जनरेशन शैली के विश्व मॉडल और MBRL के लेटेंट डायनामिक्स मॉडल प्रतिनिधित्व संबंधी संकल्प के विभिन्न स्तरों पर कार्य करते हैं, लेकिन उनका मूल विचार एक ही है: वास्तविक हार्डवेयर पर सब कुछ आज़माने से पहले इसे एक सीखे हुए मॉडल के भीतर आज़माएँ।
वर्तमान स्थिति
- लक्ष्य: मनुष्यों के देखने के लिए वीडियो/आभासी वातावरण: सोरा, जिनी 3 और वर्ल्ड लैब्स के मार्बल जैसे जनरेटिव विश्व मॉडल। देखने में आकर्षक, लेकिन भौतिक सटीकता की गारंटी नहीं
- लक्ष्य: रोबोट नीति सीखने और मूल्यांकन के लिए डेटा उत्पन्न करना: NVIDIA Cosmos और 1X वर्ल्ड मॉडल जैसे डिज़ाइन, जो वीडियो-जनरेशन तकनीक को सीधे रोबोट क्रिया जनरेशन से जोड़ते हैं। वास्तविक हार्डवेयर डेटा संग्रह में आने वाली बाधा को दूर करने की उम्मीद है।
- लक्ष्य: मॉडल-आधारित रीइन्फोर्समेंट लर्निंग के लिए एक आंतरिक सिम्युलेटर: DreamerV3-परिवार के लेटेंट डायनामिक्स मॉडल। अपेक्षाकृत कम गणनात्मक और सीधे नीति-सीखने की प्रक्रिया में आसानी से एकीकृत होने वाले, लेकिन जिन प्रेक्षणों को वे संभाल सकते हैं उनकी जटिलता सीमित है।
- लक्ष्य: प्रतिनिधित्व सीखना और सामान्य-उद्देश्यीय भविष्यवाणी: V-JEPA परिवार में गैर-जनरेटिव दृष्टिकोण। पिक्सेल जनरेशन की लागत से बचते हुए डाउनस्ट्रीम कार्यों के लिए ट्रांसफर परफॉर्मेंस को बेहतर बनाएं।
इन सभी रुझानों का आधार एक ही है — सीखने के माध्यम से वातावरण की गतिशीलता को आत्मसात करना — जबकि ये इस बात पर निर्भर करते हुए अलग-अलग शाखाओं में बंट जाते हैं कि इनका आउटपुट क्या है और ये किसके लिए आउटपुट दे रहे हैं: एक इंसान, एक प्रोग्राम, या एक पॉलिसी-लर्निंग लूप। 2026 तक यही वास्तविकता है।
क्या यथार्थवादी भविष्य का वीडियो सटीक भौतिक भविष्यवाणी स्थापित करता है?
दृश्य संभाव्यता और क्रिया-आधारित गतिशीलता भिन्न होती हैं।
समान क्रियाओं के तहत अनुमानित स्थिति परिवर्तनों की तुलना वास्तविक परिवर्तनों से करें। ## संदर्भ - [विश्व मॉडल, मूल शोध पत्र (हा और श्मिधुबर, 2018)](https://worldmodels.github.io/) - [ड्रीमर्स का आधिकारिक ब्लॉग (गूगल रिसर्च)](https://research.google/blog/introducing-dreamer-scalable-reinforcement-learning-using-world-models/) - [ड्रीमर्सV3 का शोध पत्र, "विश्व मॉडलों के माध्यम से विविध नियंत्रण कार्यों में महारत हासिल करना" (नेचर)](https://www.nature.com/articles/s41586-025-08744-2) - [विश्व सिमुलेटर के रूप में वीडियो जनरेशन मॉडल (ओपनएआई, आधिकारिक)](https://openai.com/index/video-generation-models-as-world-simulators/) - [जीनी 3: विश्व मॉडलों के लिए एक नई सीमा (गूगल डीपमाइंड, आधिकारिक)](https://deepmind.google/blog/genie-3-a-new-frontier-for-world-models/) - [जीनी 2: एक बड़े पैमाने पर आधारभूत विश्व मॉडल (गूगल डीपमाइंड, आधिकारिक)](https://deepmind.google/blog/genie-2-a-large-scale-foundation-world-model/) - [वर्ल्ड लैब्स मार्बल की घोषणा] (टेकक्रंच)](https://techcrunch.com/2025/11/12/fei-fei-lis-world-labs-speeds-up-the-world-model-race-with-marble-its-first-commercial-product/) - [विश्व मॉडलों का एक कार्यात्मक वर्गीकरण (फेई-फेई ली, आधिकारिक ब्लॉग)](https://drfeifei.substack.com/p/a-functional-taxonomy-of-world-models) - [एनवीडिया कॉसमॉस 3 की घोषणा (एनवीडिया न्यूज़ रूम)](https://nvidianews.nvidia.com/news/nvidia-launches-cosmos-3-the-open-frontier-foundation-model-for-physical-ai) - [वी-जेईपीए (मेटा एआई, आधिकारिक)](https://ai.meta.com/blog/v-jepa-yann-lecun-ai-model-video-joint-embedding-predictive-architecture/) - [वर्ल्डरोमबेंच पेपर (arXiv)](https://arxiv.org/abs/2606.31672) - मॉडल-आधारित रीइन्फोर्समेंट लर्निंग और सिम-टू-रियल के बारे में विस्तृत जानकारी के लिए, "[मॉडल-आधारित रीइन्फोर्समेंट लर्निंग और सिम-टू-रियल का परिचय](/hi/blog/posts/reinforcement-model-based.html)" भी देखें।
टिप्पणियाँ
पहले लॉग इन करें।
अभी कोई डेटा नहीं है।