Contents — find the section you need
Um Modelo Mundial é um termo geral para um modelo que aprende a prever como o estado de um ambiente irá transitar quando um agente realiza uma ação. Em robótica e aprendizado por reforço, ele funciona como um simulador interno para "testar coisas mentalmente antes de agir no mundo real"; no contexto de IA para geração de vídeo, ele serve como base não apenas para gerar vídeos com aparência plausível, mas também para simular o próprio ambiente de acordo com as leis da física. É um conceito que tem atraído crescente atenção nos últimos anos, em ambas as áreas.
 NVIDIA Cosmos
Imagem: NVIDIA logo, Wikimedia Commons. Apresentada aqui como a empresa que desenvolve a série Cosmos de Modelos Fundamentais Mundiais para IA física.

Modelos Mundiais em um Diagrama
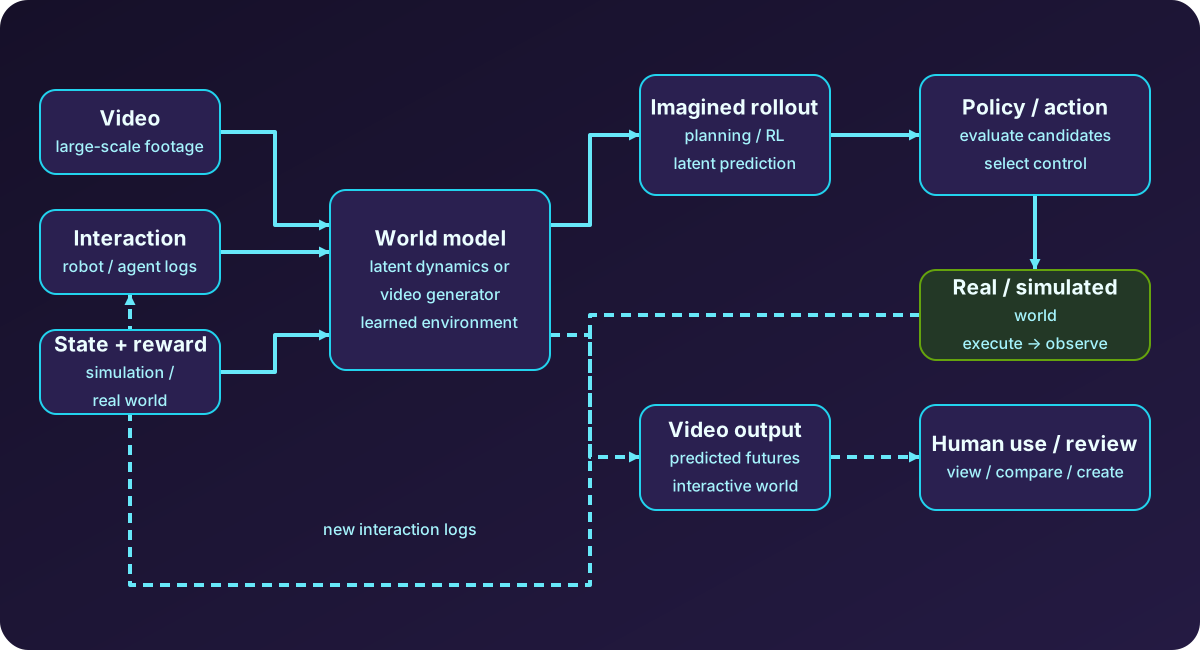
Diagrama: criado pela Duskcoil. Um diagrama único simplificado que combina o uso como um simulador interno para aprendizado por reforço baseado em modelo com o uso como um modelo de geração de vídeo.
O eixo para a compreensão dos Modelos Mundiais se divide em duas perguntas: o que está sendo previsto (pixels de vídeo brutos ou uma representação latente comprimida) e para que está sendo usado (um simulador interno para aprendizado de políticas ou geração de vídeo para um humano assistir). O mesmo termo "Modelo de Mundo" pode se referir a um modelo de dinâmica latente probabilística que sustenta o aprendizado de simulação para realidade de um robô, como no Dreamer, ou a um modelo de geração de vídeo com dezenas de bilhões de parâmetros, como no Sora ou no Genie — este é um campo onde as discussões podem se perder se o contexto não for mantido claro.
Linhagem: Do artigo original de Ha e Schmidhuber ao DreamerV3
O ponto em que o termo "Modelos de Mundo" se popularizou em seu sentido atual remonta a um artigo de 2018 de David Ha e Jürgen Schmidhuber. Em sua configuração, um VAE (autoencoder variacional) comprime observações visuais em uma representação compacta, e uma RNN (LSTM) prevê como essa representação muda ao longo do tempo; eles mostraram que um agente poderia treinar uma política inteiramente "dentro" desse espaço latente aprendido.
Este design foi substancialmente aprimorado no PlaNet em 2019, cujo RSSM (Modelo de Espaço de Estados Recorrente) combinou componentes determinísticos e estocásticos para melhorar significativamente a precisão e a consistência da previsão em múltiplas etapas. Enquanto o PlaNet resolvia novamente um plano a cada passo como controle preditivo baseado em modelo (MPC), o Dreamer subsequente foi além, aprendendo uma política (ator) e uma função de valor (crítico) diretamente por meio de retropropagação dentro do modelo do mundo — um design que se tornou o modelo básico para a "família Dreamer" desde então. O DreamerV2 introduziu representações latentes discretas e o DreamerV3, publicado na Nature em 2025, demonstrou desempenho generalizado em diversos domínios — incluindo mineração de diamantes no Minecraft — sem ajuste fixo de hiperparâmetros, elevando substancialmente o padrão para a utilidade prática de modelos do mundo em aprendizado por reforço baseado em modelos.
Convergência do Lado da IA Generativa: Sora, Genie, World Labs
Independentemente da linhagem de aprendizado por reforço, o termo "Modelo de Mundo" também começou a ser usado no contexto da IA de geração de vídeo. Em 2024, a OpenAI argumentou, em seu relatório técnico sobre o modelo de geração de vídeo Sora, que "escalar modelos de geração de vídeo é um caminho promissor para a construção de simuladores de propósito geral do mundo físico", citando exemplos como pinceladas que persistem em uma tela e marcas de mordida que permanecem após alguém comer um hambúrguer, como evidência de que o Sora havia aprendido implicitamente alguns aspectos das leis da física e da causalidade.
A série Genie do Google DeepMind impulsionou ainda mais essa direção: em dezembro de 2024, o Genie 2 demonstrou ser capaz de gerar um ambiente 3D controlável a partir de uma única imagem e, em agosto de 2025, o Genie 3 conseguiu gerar mundos 3D persistentes, exploráveis em tempo real e com duração de vários minutos, a partir de um texto, a 24 quadros por segundo e resolução de 720p. A DeepMind apresenta isso como uma forma escalável de gerar dados de treinamento para navegação, percepção e raciocínio de longo prazo em robótica, e em fevereiro de 2026 foi noticiado que a Waymo havia adotado a tecnologia para simulação de direção autônoma.
A World Labs, fundada por Fei-Fei Li, de Stanford, anunciou seu produto comercial Marble em novembro de 2025. O Marble gera ambientes 3D persistentes e para download (exportáveis como Gaussian Splatting, malhas ou vídeo) a partir de fragmentos de texto, imagens ou vídeo. Em um ensaio publicado em junho de 2026, Li classificou funcionalmente os Modelos de Mundo em três categorias: Renderizador (gera vídeo para visualização humana), Simulador (gera uma representação geométrica e fisicamente fiel que um programa pode usar para computação) e Planejador (gera a próxima ação a partir de observações e um objetivo) — posicionando sistemas de geração de vídeo como Sora e Genie mais próximos do Renderizador, modelos de dinâmica de aprendizado de robôs mais próximos do Simulador e VLA mais próximo do Planejador.
NVIDIA Cosmos: Um Modelo de Base Mundial para Robótica
Uma abordagem que vem ganhando espaço na indústria da robótica é a série Cosmos da NVIDIA. O Cosmos 3, anunciado em junho de 2026, adota uma arquitetura de mistura de transformadores que unifica raciocínio visual, geração de mundo e previsão de ações em um único modelo, lidando com múltiplas modalidades — texto, imagem, vídeo, áudio ambiental e ação — dentro de uma única estrutura. O objetivo é um pipeline de geração de dados: em vez de executar milhares de horas de testes em um braço robótico real, gerar grandes volumes de vídeo simulado de um robô executando uma tarefa, treinar uma política com esses dados e, em seguida, implantá-la em hardware real. A NVIDIA formou a Cosmos Coalition com parceiros como Agile Robots, Black Forest Labs, Runway e Skild AI, construindo um ecossistema aberto para Modelos de Fundação Mundial.
Generativo ou não: JEPA de LeCun como o Contra-Eixo
O que Sora, Genie e Cosmos têm em comum é um design que gera pixels diretamente (ou uma representação próxima a eles). Yann LeCun, ex-Cientista Chefe de IA da Meta AI, sempre adotou uma postura cética em relação a essa abordagem generativa. Sua proposta de JEPA (Arquitetura Preditiva de Incorporação Conjunta) é um design que traça uma linha clara ao prever dentro de um espaço de representação abstrato e nunca gerar pixels ou tokens. O V-JEPA 2, construído com base nessa filosofia de design, alcançou cerca de 80% de sucesso em tarefas de manipulação robótica sem exemplos prévios, após pré-treinamento com aproximadamente um milhão de horas de vídeos da internet e ajuste fino com apenas 62 horas de dados de manipulação robótica. LeCun deixou a Meta no início de 2026, fundou a AMI Labs em Paris e captou mais de um bilhão de dólares em financiamento inicial para se concentrar na construção de um Modelo Mundial de propósito geral — entrando em uma fase na qual ele está colocando à prova sua própria afirmação de que "modelos generativos são um beco sem saída como Modelos Mundiais".
Em 2026, ainda não se sabe qual das abordagens, generativa ou não generativa (estilo JEPA), é superior. Os modelos generativos têm a vantagem de produzir vídeos que os humanos podem avaliar diretamente a olho nu, enquanto as abordagens no estilo JEPA supostamente têm vantagem em eficiência computacional e estabilidade de previsão a longo prazo, prevendo em uma representação abstrata — mas nenhum dos lados demonstrou ainda uma vantagem decisiva em implantações em larga escala no mundo real.
Desafios em aberto: Consistência física, coerência de longo prazo e avaliação
Consistência física: Numerosos exemplos concretos de violações das leis da física foram apontados no vídeo gerado por Sora — objetos flutuando enquanto ignoram a gravidade, uma chama de vela que não se move, uma formiga com o número errado de patas, comportamento anormal de fragmentos quando o vidro se quebra. Análises mostraram que mesmo modelos poderosos falham em relação à gravidade, à permanência do objeto e à consistência causal, e a avaliação neutra neste momento é que, embora Sora 2 claramente tenha aprendido "algo" sobre estrutura 3D e causalidade física, esse algo não é o mesmo que um motor de física convencional.
Coerência de longo prazo: Se o estado de um ambiente pode ser mantido sem falhas por períodos superiores a dezenas de segundos permanece um desafio não resolvido. Os benchmarks de avaliação propostos em 2026, como o WorldRoamBench, avaliam a estabilidade a longo prazo em quatro eixos — fidelidade da ação, quebra visual (desvio), consistência física e consistência da memória (se locais e objetos visitados anteriormente são lembrados) — e apontam que muitos métodos de avaliação existentes consideravam apenas janelas curtas de 5 a 10 segundos.
Dificuldade de avaliação: Ainda não há consenso sobre como medir quantitativamente um "bom modelo de mundo". A naturalidade visual do vídeo gerado e sua utilidade em tarefas subsequentes de controle de robôs nem sempre se alinham e, como a escala semântica das saídas difere entre os modelos, foi apontado que comparar trajetórias de forma justa entre eles é difícil.
Custo computacional: Avaliar e treinar modelos de mundo em larga escala é caro — uma única chamada de API pode custar mais de um dólar. Modelos que aprendem e avaliam tarefas de longo prazo podem gerar cerca de 100.000 tokens em uma única resposta, o que está se tornando uma barreira para a própria reprodutibilidade da pesquisa.
O Ponto de Conexão com o Aprendizado de Robôs
Um exemplo notável da aplicação direta de Modelos Mundiais à robótica é o Modelo Mundial de Vídeo que a 1X Technologies desenvolveu para seu próprio robô humanoide, o NEO (veja "Tendências Tecnológicas em Robôs Humanoides" para mais detalhes). O projeto, no qual um modelo de geração de vídeo com 14 bilhões de parâmetros imagina "um vídeo curto da tarefa sendo concluída", que é então convertido em comandos motores reais por meio de um Modelo de Dinâmica Inversa, é um exemplo concreto de como conectar um Renderizador (geração de vídeo) diretamente a um Planejador (geração de ações).
No contexto clássico de aprendizado por reforço, o aprendizado por reforço baseado em modelos (MBRL) lida com esse conceito de forma mais concreta há anos. O projeto de aprendizado de um modelo de mundo \hat f_\theta que prevê o próximo estado a partir de um estado s e uma ação a, a avaliação de sequências de ações candidatas dentro dele antes da implantação em hardware real, como o acúmulo de erros de previsão é tratado por meio da randomização de domínio e o processo em etapas para a transição da simulação para o mundo real — tudo isso é abordado em detalhes em "Uma Introdução ao Aprendizado por Reforço Baseado em Modelos e Simulação para Realidade." Modelos de mundo no estilo de geração de vídeo e os modelos de dinâmica latente do MBRL operam em diferentes níveis de resolução representacional, mas compartilham a mesma ideia central: testar dentro de um modelo aprendido antes de testar tudo em hardware real.
Situação Atual
- Objetivo: ambientes virtuais/de vídeo para visualização humana: Modelos de mundo generativos como Sora, Genie 3 e Marble da World Labs. Visualmente atraente, mas o rigor físico não é garantido.
- Objetivo: gerar dados para aprendizado e avaliação de políticas robóticas: Projetos como o NVIDIA Cosmos e o 1X World Model, que conectam a tecnologia de geração de vídeo diretamente à geração de ações robóticas. Espera-se que aliviem o gargalo na coleta de dados com hardware real.
- Objetivo: um simulador interno para aprendizado por reforço baseado em modelos: Modelos de dinâmica latente da família DreamerV3. Computacionalmente leves e fáceis de incorporar diretamente em um ciclo de aprendizado de políticas, mas limitados na complexidade das observações que podem processar.
- Objetivo: aprendizado de representação e previsão de propósito geral: Abordagens não generativas da família V-JEPA. Evitam o custo da geração de pixels enquanto buscam desempenho de transferência para tarefas subsequentes.
Cada uma dessas tendências se baseia no mesmo fundamento — internalizar a dinâmica de um ambiente por meio do aprendizado — enquanto se diferenciam com base no que produzem e para quem (ou o quê) produzem: um humano, um programa ou um ciclo de aprendizado de políticas. Essa é a realidade a partir de 2026.
Vídeos realistas do futuro estabelecem previsões físicas precisas?
A plausibilidade visual e a dinâmica condicionada pela ação diferem.
Compare as mudanças de estado previstas com as transições reais sob as mesmas ações.Referências
- World Models, o artigo original (Ha & Schmidhuber, 2018)
- Blog oficial do Dreamer (Google Research)
- Artigo do DreamerV3, "Dominando diversas tarefas de controle por meio de modelos de mundo" (Nature)
- Modelos de geração de vídeo como simuladores de mundo (OpenAI, oficial)
- Genie 3: Uma nova fronteira para modelos de mundo (Google DeepMind, oficial)
- Genie 2: Um modelo de mundo fundamental em larga escala (Google DeepMind, oficial)
- [World Anúncio do Labs Marble (TechCrunch)
- Uma Taxonomia Funcional de Modelos Mundiais (Fei-Fei Li, blog oficial)
- Anúncio do NVIDIA Cosmos 3 (Sala de Imprensa da NVIDIA)
- V-JEPA (Meta AI, oficial)
- Artigo do WorldRoamBench (arXiv)
- Para detalhes sobre aprendizado por reforço baseado em modelos e simulação para realidade, veja também "Uma Introdução ao Aprendizado por Reforço Baseado em Modelos e Simulação para Realidade"
Comentários
Entre na sua conta para continuar.
Ainda não há dados.