Contents — find the section you need
Os modelos de Visão-Linguagem-Ação (VLA) são uma arquitetura que integra imagens de câmera e instruções em linguagem natural em um único sistema, gerando as ações (comandos motores) de um robô diretamente. Contrariando a tradição da robótica de projetar percepção (reconhecimento) e controle (planejamento e execução) como fluxos de trabalho separados, a ideia central aqui é uma mudança de mentalidade: integrar ambos em um único modelo transformador.
 Visão + Linguagem → Ação
Não foi possível encontrar um logotipo oficial livre de direitos autorais para as principais empresas de VLA (Physical Intelligence, etc.), então um ícone simples representando a integração de visão, linguagem e ação foi criado em seu lugar.
VLA em resumo
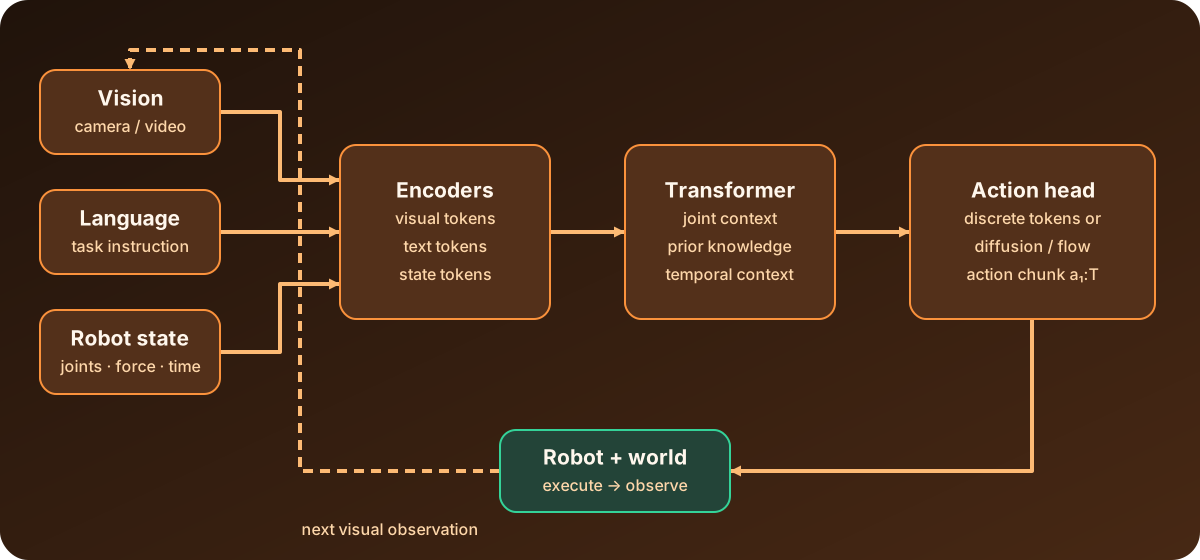
Diagrama: Duskcoil. Ele simplifica uma relação representativa entre a inferência VLA e o feedback do mundo físico.
Um VLA não é meramente um modelo que pode ler imagens e linguagem; faz parte de um circuito fechado cuja saída está conectada à ação física. Imagens, instruções e estado articular são mapeados em uma representação compartilhada, um transformador integra o contexto e um núcleo de ação o converte em um bloco de ação. Como a observação após a execução se torna a próxima entrada, a avaliação prática deve incluir não apenas a precisão do modelo, mas também a latência de inferência, a suavidade da ação e um mecanismo que interrompa o processo com segurança quando o comportamento se tornar anormal.
Linhagem: Do RT-1 ao RT-2 e ao OpenVLA
O RT-1 do Google foi um dos primeiros exemplos emblemáticos, e seu sucessor, o RT-2, desenvolveu ainda mais a ideia, redirecionando o conhecimento de um modelo grande pré-treinado em dados de visão e linguagem em escala web para a geração de ações robóticas. No âmbito do código aberto, modelos como OpenVLA, Octo e CLIP-RT seguiram com arquiteturas baseadas em transformadores construídas em torno da atenção multimodal (um mecanismo de atenção mútua que abrange visão e linguagem). O que todos esses modelos têm em comum é que "ver", "compreender" e "agir" não são divididos em módulos separados — uma única rede é treinada para todas as etapas. do início ao fim, desde a entrada (imagens mais instruções) até a saída (ação).
Estrutura Interna: Três Subsistemas
A arquitetura computacional de um modelo VLA pode ser entendida como composta por três subsistemas. Primeiro, um codificador de visão converte os dados brutos de pixels da câmera em uma representação estruturada de características — geralmente uma combinação de codificadores de imagem pré-treinados, como SigLIP ou DINOv2. Em seguida, vem um módulo de projeção (geralmente um perceptron multicamadas) que mapeia as características visuais extraídas para o espaço de incorporação no qual o modelo de linguagem opera. Finalmente, um transformador somente decodificador processa a sequência concatenada de tokens visuais e de linguagem (instruções) e gera a ação final.
Geração de Ação: Duas Abordagens de Design
Uma vez que a visão e a linguagem são integradas, existem basicamente duas abordagens de design para a geração do comando motor (a ação).
Uma delas utiliza tokens de ação discretos: valores de ação contínuos (ângulos articulares, velocidades e similares) são discretizadas em um número fixo de intervalos (digamos, 256), as IDs dos tokens do vocabulário do modelo de linguagem, que têm pouco uso para outras finalidades, são reaproveitadas para representar ações. A vantagem é que visão, linguagem e ação podem ser tratadas uniformemente como o mesmo tipo de "sequência de tokens", gerando a sequência de ações a_{1:T} de forma autorregressiva — condicionada à observação o, gerando cada token seguinte com base nos tokens gerados anteriormente.
Essa formulação tem exatamente o mesmo formato da predição da próxima palavra na geração de linguagem natural e captura a ideia central da VLA — lidar com visão, linguagem e ação dentro do mesmo modelo probabilístico.
A outra abordagem usa um cabeçalho de ação baseado em difusão: a função do transformador é reduzida a produzir um "token de leitura" que resume as informações visuais e linguísticas, e a geração dos valores de ação contínuos reais é delegada a um modelo de difusão. Ação discreta Os tokens, gerados em etapas, podem por vezes apresentar limitações em termos de capacidade de resposta e fluidez em tempo real, enquanto um controlador de ação baseado em difusão tende a produzir uma saída de ação mais suave e contínua. Combinações dos dois também são cada vez mais comuns — o Octo, por exemplo, alimenta tokens de imagem e linguagem através de um transformador como uma única sequência e, em seguida, passa sua saída (o token de leitura) como uma condição para um controlador de ação baseado em difusão.
O que esse design significa na prática
Um sistema de controle clássico só consegue lidar com uma situação para a qual não foi projetado seguindo seu script e nada mais. A vantagem de um modelo VLA é a possibilidade de generalizar para condições para as quais nunca foi explicitamente treinado. Seu leque de aplicações está se expandindo rapidamente, desde a automação de armazéns até robôs de assistência cirúrgica, e está sendo cada vez mais posicionado como a tecnologia central por trás da IA Incorporada. Ao mesmo tempo, a forte dependência de dados de demonstração humana em larga escala continua sendo um grande desafio, tanto na coleta de dados quanto no custo de treinamento.
A linhagem π0 da Inteligência Física
Um dos nomes que mais tem atraído atenção no VLA recentemente π0 (pi-zero), da Physical Intelligence, uma startup que arrecadou mais de US$ 400 milhões, é um modelo robótico de propósito geral que combina coleta de dados multitarefa em larga escala com múltiplos robôs e uma nova arquitetura de rede capaz de lidar com uma ampla gama de tarefas — como dobrar roupas, limpar uma mesa e coletar grãos de café. A Physical Intelligence disponibilizou o código e os pesos do π0 como código aberto no repositório openpi e continua lançando versões aprimoradas desde então — π0.5, π0.6 e π0.7. O modelo base do π0 foi pré-treinado no conjunto de dados Open X-Embodiment (OXE) juntamente com as sete plataformas robóticas da própria empresa e foi projetado como um modelo de propósito geral para ajuste fino: um modelo zero-shot utilizável para tarefas já cobertas pelos dados de pré-treinamento, mas construído com o ajuste fino como o caminho esperado para um caso de uso específico.
Novidades da Physical Intelligence: π0.7 e além
Acompanhe as informações oficiais da Physical Intelligence De acordo com o blog, a linha π0 continuou adicionando recursos de forma constante até 2026. Março de 2026 trouxe dois lançamentos consecutivos: um método que usa um "Token de Aprendizado por Reforço" extraído do modelo VLA para refinar rapidamente tarefas de manipulação de robôs reais por meio de aprendizado por reforço online, e a "Memória Incorporada Multiescala", que integra memória de longo e curto prazo para lidar com tarefas que duram mais de dez minutos. O π0.7, anunciado em abril, é posicionado como um modelo direcionável — um que pode ser guiado externamente — exibindo recursos emergentes que representam uma "mudança radical" no desempenho de generalização. O foco do desenvolvimento parece estar mudando da imitação de demonstrações pontuais para recursos muito mais próximos da operação robótica genuinamente autônoma: memória, aprendizado online e direcionabilidade.
Saturação do LIBERO e a Corrida pela Velocidade
O LIBERO, o benchmark de simulação que se tornou padrão na pesquisa VLA, viu vários métodos atingirem taxas de sucesso de tarefas acima de 90% no segundo semestre de 2026. 2026 — a precisão está efetivamente se aproximando da saturação. O Temporal Forcing (agosto de 2026), que fortalece a compreensão do contexto temporal alinhando-se a uma representação de cena 4D, alcança 98,8% no LIBERO, elevando o sucesso em uma tarefa mais difícil de "posicionamento oculto" de 20,0% para 43,3% — um sinal de que, à medida que o benchmark padrão satura, o foco da avaliação na área está se deslocando para tarefas de generalização mais complexas.
Com a convergência da precisão entre os métodos, o foco da pesquisa também se voltou para a otimização da velocidade de inferência. O DriftingVLA (agosto de 2026), que substitui o processo convencional de difusão em múltiplas etapas por uma única passagem direta, mantém 98,32% de sucesso no LIBERO, enquanto relata uma aceleração de 3,36 vezes na geração de blocos de ação em comparação com métodos iterativos. O AdaVLA (agosto de 2026, IROS 2026), que acelera modelos já treinados sem a necessidade de retreiná-los, Introduz uma métrica que estima a confiança da geração a partir da curvatura da trajetória de correspondência de fluxo, alcançando acelerações de 1,87x e 2,24x no π0.5 e no X-VLA, respectivamente, sem treinamento adicional. O SMILE (agosto de 2026), voltado para a geração de movimentos suaves em tarefas de longo prazo, também mantém 98,0% de sucesso no LIBERO, enquanto apresenta uma aceleração de 1,1x por meio de um design que prevê coeficientes B-spline — "mais rápido sem sacrificar a precisão" tornou-se um dos principais eixos da pesquisa em VLA no segundo semestre de 2026.
A Expansão de 2026
A pesquisa na área de VLA continuou a surgir em ritmo acelerado até 2026. ABot-M0, que incorpora aprendizado de variedade de ação; ACE-Brain-0.5, um modelo fundamental unificado para IA agente incorporada; Kairos, que integra um modelo de mundo com ação — a pesquisa está se expandindo para além do simples "Ver e mover" em direção à modelagem, memorização e atuação no mundo físico de forma integrada. O conceito de VLA (Avaliação de Inteligência Artificial) está sendo reposicionado — de uma tecnologia específica para robótica a um elemento central da estrutura mais ampla de "IA Física".
Onde a Avaliação Termina e a Operação Real do Robô Começa
Os resultados de benchmark da VLA são medições comparativas sob condições controladas: o robô de treinamento, o posicionamento da câmera, a redação das instruções, o critério de sucesso e o procedimento de reinicialização estão definidos dentro do benchmark. Uma taxa de sucesso no benchmark não pode ser interpretada diretamente como uma garantia de segurança para outro robô ou ambiente de trabalho. Antes da implantação, a saída da ação precisa de uma camada supervisora separada que imponha limites de velocidade, aceleração e articulações, e interrompa o robô em caso de perda de comunicação, tempo limite de inferência ou falha do sensor.
Um bloco de ação gerado por uma VLA é uma previsão baseada na observação disponível no momento da inferência. Se uma pessoa ou objeto se move durante o bloco, executar todo o bloco sem outra observação resulta em comandos baseados em percepções desatualizadas. sistema. Blocos menores com replanejamento mais frequente melhoram a capacidade de resposta, mas aumentam a carga de inferência e comunicação. Blocos maiores podem ser mais eficientes, embora reajam mais lentamente à oclusão ou mudanças de contato. A ponte prática entre a pesquisa e a operação é medir a distância de parada, o período de replanejamento e a taxa de recuperação, além do sucesso da tarefa.
A distribuição dos dados de treinamento também é importante. Iluminação, material, atrito nas juntas e latência da câmera que diferem das condições de treinamento podem aparecer como erros de ação no robô real. A avaliação deve, portanto, separar tarefas conhecidas repetidas de testes com objetos movidos, instruções parafraseadas, recuperação após oclusão e comunicação deliberadamente atrasada. Simplesmente pedir a um modelo para tentar novamente após uma falha não identifica a causa. Armazene a imagem de entrada, a instrução, a ação gerada, os limites de supervisão e o motivo da parada em uma base de tempo compartilhada. Isso facilita a distinção entre um erro de percepção e uma falha mecânica ou de comunicação, além de permitir a repetição da mesma avaliação após uma atualização do modelo.
As decisões de implantação também devem ser escalonadas. O sucesso na simulação, uma condição de parada que funciona em laboratório e a conclusão da tarefa em um ambiente limitado são diferentes tipos de evidência. Antes de prosseguir para Em espaços externos ou compartilhados por humanos, teste objetos desconhecidos, mudanças de iluminação, bateria fraca e perda de rede. Em seguida, documente as condições para confiar no modelo e as condições para devolver o controle a um controlador convencional. Tornar esse limite explícito preserva a flexibilidade de um VLA sem abrir mão da verificabilidade exigida por um sistema de controle.
O registro do experimento deve incluir a versão do modelo e dos pesos, a resolução da entrada, o tempo de inferência, o período de controle e a duração da ação. Sem esses campos, executar o mesmo modelo novamente não produz um resultado comparável. Mesmo "sucesso" pode significar coisas diferentes: posicionar um objeto no alvo, evitar contato ou concluir uma tarefa após a intervenção de um limitador. Defina os critérios de sucesso e interrupção antecipadamente e relate separadamente o que o modelo produziu e o que a camada supervisora permitiu. Para usar os números da pesquisa em uma decisão operacional, as condições de medição e o intervalo não medido devem ser registrados na mesma tabela.
Na operação de rotina, o comportamento pode mudar após a substituição de uma câmera ou uma mudança na iluminação, mesmo quando o modelo em si permanece inalterado. Para detectar mudanças na distribuição, continue registrando os indicadores de confiança, as magnitudes das ações e o número de intervenções. pela camada supervisora. Quando valores anormais persistem, alternar para um modo lento ou operação manual é mais fácil de diagnosticar do que tentar repetidamente de forma automática. Tratar um VLA como um componente em um sistema que separa observação, inferência, limitação e parada favorece tanto a reprodutibilidade quanto a segurança.
A aparente compreensão das instruções garante uma ação segura do robô?
Limites de ação, condições de execução, detecção de falhas e mecanismos de parada continuam sendo necessários. Fluência na linguagem não é evidência de sucesso físico.
Referências
- Modelos de Ação de Linguagem Visual em Manipulação Robótica: Uma Revisão Sistemática (arXiv)
- Blog Oficial do π0: Inteligência Física
- Anúncio Oficial do π0.7
- Artigo π0.7 (Physical Intelligence)
- Manipulação Precisa com RL Online Eficiente (Physical Intelligence)
- VLAs com Memória de Curto e Longo Prazo (Physical Intelligence)
- Cobertura do Repositório GitHub openpi de Physical Intelligence (The Robot Report)
- Modelos de Visão-Linguagem-Ação (VLA) para Robótica (Blog Roboflow)
- Uma Pesquisa sobre Modelos de Visão-Linguagem-Ação: Uma Perspectiva de Tokenização de Ações (arXiv)
- [Physical Intelligence Official Blog
- Artigo sobre Forçamento Temporal (arXiv)
- Artigo sobre DriftingVLA (arXiv)
- Artigo sobre AdaVLA (IROS 2026, arXiv)
- Artigo sobre SMILE (arXiv)
Comentários
Entre na sua conta para continuar.
Ainda não há dados.