Contents — find the section you need
Les modèles Vision-Langage-Action (VLA) constituent une architecture qui intègre les images de la caméra et les instructions en langage naturel au sein d'un système unique, permettant ainsi de générer directement les actions (commandes motrices) du robot. À l'inverse de la tradition en robotique qui conçoit la perception (reconnaissance) et le contrôle (planification et exécution) comme des processus distincts, l'idée centrale réside ici dans un changement de perspective : intégrer les deux au sein d'un modèle de transformation unique.
 Vision + Langage → Action
Aucun logo officiel libre de droits n'ayant été trouvé pour les principales entreprises de VLA (Physical Intelligence, etc.), une icône simple représentant l'intégration de la vision, du langage et de l'action a été créée à la place.
Aperçu de la VLA
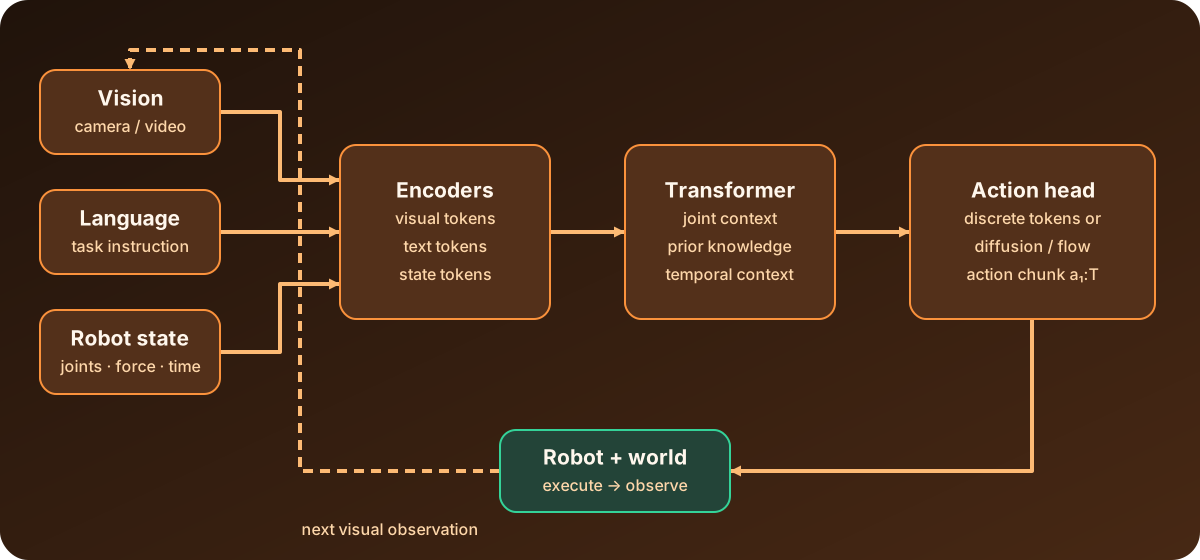
Schéma : Duskcoil. Il simplifie une relation représentative entre l'inférence VLA et le retour d'information du monde physique.
Une VLA n'est pas simplement un modèle capable de lire des images et du langage ; c'est Il s'agit d'une partie d'une boucle fermée dont la sortie est liée à une action physique. Les images, les instructions et l'état des articulations sont mappés dans une représentation partagée, un transformateur intègre le contexte et une tête d'action le convertit en un segment d'action. L'observation après l'exécution devenant l'entrée suivante, l'évaluation pratique doit prendre en compte non seulement la précision du modèle, mais aussi la latence d'inférence, la fluidité de l'action et un mécanisme d'arrêt sécurisé en cas de comportement anormal.
Héritage : De RT-1 à RT-2 puis à OpenVLA
RT-1 de Google fut l'un des premiers exemples phares, et son successeur, RT-2, a approfondi l'idée en réorientant les connaissances d'un vaste modèle pré-entraîné sur des données de vision et de langage à l'échelle du web vers la génération d'actions robotiques. Du côté open source, des modèles comme OpenVLA, Octo et CLIP-RT ont suivi, avec des architectures basées sur des transformateurs et construites autour de l'attention intermodale (un mécanisme d'attention mutuelle couvrant la vision et le langage). Leur point commun ? « Voir », « comprendre » et « agir » ne sont pas séparés en modules distincts : un seul réseau est entraîné de bout en bout, à partir des entrées. (Images et instructions) jusqu'à la sortie (action).
Structure interne : Trois sous-systèmes
L'architecture de calcul d'un modèle VLA peut être globalement divisée en trois sous-systèmes. Premièrement, un encodeur visuel convertit les données brutes de pixels de la caméra en une représentation structurée des caractéristiques — souvent une combinaison d'encodeurs d'images pré-entraînés comme SigLIP ou DINOv2. Vient ensuite un module de projection (généralement un perceptron multicouche) qui projette les caractéristiques visuelles extraites dans l'espace d'intégration du modèle de langage. Enfin, un transformateur décodeur traite la séquence concaténée de jetons visuels et linguistiques (instructions) et génère l'action finale.
Génération de l'action : Deux approches de conception
Une fois la vision et le langage intégrés, deux grandes approches de conception permettent de générer la commande motrice (l'action).
L'une utilise des jetons d'action discrets : les valeurs d'action continues (angles articulaires, vitesses, etc.) sont discrétisées en un nombre fixe de classes (256, Par exemple), et les identifiants de jetons du vocabulaire du modèle de langage peu utilisés sont réaffectés pour représenter des actions. L'avantage est que la vision, le langage et l'action peuvent être traités uniformément comme une même « séquence de jetons », générant la séquence d'actions a_{1:T} de manière autorégressive — conditionnée par l'observation o — chaque jeton suivant étant généré à partir des précédents.
Cette formulation a exactement la même forme que la prédiction du mot suivant en génération de langage naturel, et elle capture l'idée centrale de l'analyse visuelle du langage (VLA) : traiter la vision, le langage et l'action au sein d'un même modèle probabiliste.
L'autre approche utilise une tête d'action basée sur la diffusion : le rôle du transformateur est réduit à produire un « jeton de lecture » qui résume les informations visuelles et linguistiques, et la génération des valeurs d'action continues est confiée à un modèle de diffusion. Les jetons d'action discrets, générés par étapes, peuvent parfois manquer de réactivité et de fluidité en temps réel, tandis que Une tête d'action basée sur la diffusion tend à produire une sortie d'action plus fluide et continue. Les combinaisons des deux sont également de plus en plus courantes : Octo, par exemple, traite les jetons d'image et de langage via un transformateur sous forme d'une séquence unique, puis transmet sa sortie (le jeton de lecture) comme condition à une tête d'action basée sur la diffusion.
Ce que cette conception signifie en pratique
Un système de contrôle classique ne peut gérer une situation pour laquelle il n'a pas été conçu qu'en suivant son script, et rien d'autre. L'avantage d'un modèle VLA réside dans sa capacité à généraliser à des conditions pour lesquelles il n'a jamais été explicitement entraîné. Son champ d'application s'étend rapidement, de l'automatisation d'entrepôts aux robots d'assistance chirurgicale, et il est de plus en plus considéré comme la technologie centrale de l'IA incarnée. Parallèlement, la forte dépendance à l'égard de données de démonstration humaines à grande échelle demeure un défi majeur, tant en termes de collecte de données que de coût d'entraînement.
L'héritage de π0 de Physical Intelligence
L'un des noms qui a le plus retenu l'attention dans le domaine du VLA ces derniers temps est π0 (pi-zéro), de Physical Intelligence, une startup qui a levé plus de 400 millions de dollars. Annoncée comme une politique robotique à usage général, π0 combine la collecte de données multitâches à grande échelle et multi-robots avec une nouvelle architecture réseau, capable de gérer une gamme variée de tâches : plier du linge, débarrasser une table, doser du café en grains. Physical Intelligence a publié le code source et les poids de π0 sur le dépôt openpi et a continué à publier des versions améliorées depuis : π0.5, π0.6 et π0.7. La base π0 a été pré-entraînée sur l’ensemble de données Open X-Embodiment (OXE) avec les sept plateformes robotiques de l’entreprise. Conçue comme un modèle à usage général destiné à l’ajustement fin, elle est utilisable dès le départ pour les tâches déjà couvertes par les données de pré-entraînement, mais est construite avec l’ajustement fin comme voie prévue pour un cas d’utilisation spécifique.
Dernières nouvelles de Physical Intelligence : π0.7 et au-delà
Selon le blog officiel de Physical Intelligence, la gamme π0 a continué à s’enrichir régulièrement de nouvelles fonctionnalités jusqu’en 2026. Mars 2026 a marqué l’arrivée de… Deux versions successives : une méthode utilisant un « jeton RL » extrait du modèle VLA pour affiner rapidement les tâches de manipulation de robots réels grâce à l’apprentissage par renforcement en ligne, et la « mémoire incarnée multi-échelle », qui intègre les mémoires à court et à long terme pour gérer les tâches de plus de dix minutes. π0.7, annoncé en avril, se positionne comme un modèle pilotable – pouvant être guidé de l’extérieur – présentant des capacités émergentes qui constituent un véritable tournant en matière de performances de généralisation. Le développement semble désormais se concentrer sur des capacités bien plus proches d’un fonctionnement robotique véritablement autonome, plutôt que sur l’imitation de démonstrations ponctuelles : mémoire, apprentissage en ligne et pilotabilité.
LIBERO : saturation et course à la vitesse
LIBERO, le banc d’essai de simulation devenu la référence en matière de recherche sur le VLA, a vu plusieurs méthodes atteindre des taux de réussite de tâches supérieurs à 90 % au cours du second semestre 2026 – la précision approche donc de la saturation. Le forçage temporel (août 2026) renforce la compréhension du contexte temporel. En s'alignant sur une représentation de scène 4D, cette méthode atteint 98,8 % de réussite sur LIBERO, tout en faisant passer son taux de succès sur une tâche plus complexe de « placement caché » de 20,0 % à 43,3 %. Ceci indique qu'à mesure que le benchmark standard sature, l'évaluation dans ce domaine se concentre désormais sur des tâches de généralisation plus difficiles.
La précision des différentes méthodes convergeant, la recherche s'oriente également vers l'optimisation de la vitesse d'inférence. DriftingVLA (août 2026), qui remplace le processus de diffusion multi-étapes classique par une seule passe avant, maintient un taux de réussite de 98,32 % sur LIBERO et affiche une accélération de 3,36 fois pour la génération de segments d'action par rapport aux méthodes itératives. AdaVLA (août 2026, IROS 2026), qui accélère les modèles déjà entraînés sans les réentraîner, introduit une métrique qui estime la confiance de la génération à partir de la courbure de la trajectoire de correspondance de flux, atteignant des accélérations de 1,87x et 2,24x. Sur π0.5 et X-VLA respectivement, sans entraînement supplémentaire. SMILE (août 2026), conçu pour la génération de mouvements fluides sur des tâches à long terme, maintient également un taux de réussite de 98,0 % sur LIBERO tout en affichant une accélération de 1,1x grâce à une conception qui prédit les coefficients B-spline. « Plus rapide sans sacrifier la précision » est devenu l'un des principaux axes de recherche sur les VLA au cours du second semestre 2026.
L'essor de 2026
La recherche dans le domaine des VLA a continué de se développer rapidement tout au long de l'année 2026. ABot-M0, qui intègre l'apprentissage de variétés d'actions ; ACE-Brain-0.5, un modèle de base unifié pour l'IA agentive incarnée ; Kairos, qui intègre un modèle du monde à l'action : la recherche s'étend au-delà du simple « voir et bouger » pour s'orienter vers la modélisation, la mémorisation et l'action dans le monde physique de manière intégrée. Le concept même de VLA est en train d'être repositionné : d'une technologie spécifique à la robotique, il devient un élément central de l'IA. Cadre plus large de l'« IA physique ».
Où s'arrête l'évaluation et où commence l'exploitation réelle du robot
Les résultats du benchmark VLA sont des mesures comparatives réalisées dans des conditions contrôlées : le robot d'entraînement, le positionnement de la caméra, le libellé des instructions, le critère de réussite et la procédure de réinitialisation sont définis dans le benchmark. Un taux de réussite de benchmark ne peut être directement interprété comme une garantie de sécurité pour un autre robot ou environnement de travail. Avant déploiement, la sortie d'action nécessite une couche de supervision distincte qui impose les limites de vitesse, d'accélération et d'articulation, et arrête le robot en cas de perte de communication, de dépassement du délai d'inférence ou de défaillance d'un capteur.
Un segment d'action généré par un VLA est une prédiction basée sur l'observation disponible au moment de l'inférence. Si une personne ou un objet se déplace pendant le segment, l'exécution de l'intégralité du segment sans autre observation laisse des commandes basées sur une perception obsolète dans le système. Des segments plus courts avec une replanification plus fréquente améliorent la réactivité, mais augmentent la charge d'inférence et de communication. Des segments plus longs peuvent être plus efficaces, mais réagissent plus lentement aux occlusions ou aux changements de contact. Pour passer concrètement de la recherche à l'exploitation, il est essentiel de mesurer la distance d'arrêt, le temps de replanification et le taux de récupération, en plus de la réussite de la tâche.
La distribution des données d'entraînement est également cruciale. Des conditions d'éclairage, de matériaux, de frottement des articulations et de latence de la caméra différentes de celles de l'entraînement peuvent se traduire par des erreurs d'action sur le robot réel. L'évaluation doit donc distinguer les tâches connues répétées des tests avec des objets déplacés, des instructions reformulées, la récupération après occlusion et les communications délibérément retardées. Demander simplement au modèle de réessayer après un échec ne permet pas d'en identifier la cause. Il est nécessaire de stocker l'image d'entrée, l'instruction, l'action générée, les limites de supervision et la raison de l'arrêt sur une base de temps commune. Cela facilite la distinction entre une erreur de perception et une panne mécanique ou de communication, et permet de répéter la même évaluation après une mise à jour du modèle.
Les décisions de déploiement doivent également être progressives. La réussite en simulation, une condition d'arrêt fonctionnelle en laboratoire et la réalisation de la tâche dans un environnement limité constituent différents éléments de preuve. Avant de déployer le robot en extérieur ou dans des espaces partagés, il convient de tester le comportement avec des objets inconnus, des variations d'éclairage, une batterie faible et une perte de réseau, puis de documenter les conditions de fiabilité du modèle et celles justifiant le retour à un contrôleur conventionnel. L'explicitation de cette limite préserve la flexibilité d'un analyseur de spectre vectoriel (ASV) sans compromettre la vérifiabilité requise par un système de contrôle.
Le compte rendu d'expérience doit inclure la version du modèle et des pondérations, la résolution d'entrée, le temps d'inférence, la période de contrôle et la durée de maintien de l'action. Sans ces champs, la réexécution du même modèle ne produit pas de résultats comparables. Même la notion de « succès » peut varier : placer un objet sur la cible, éviter tout contact ou terminer une tâche après l'intervention d'un limiteur. Définissez à l'avance les critères de succès et d'interruption, et indiquez séparément les résultats du modèle et les actions autorisées par la couche de supervision. Pour utiliser les données de recherche dans une décision opérationnelle, les conditions de mesure et la plage non mesurée doivent être consignées dans le même tableau.
En fonctionnement normal, le comportement peut changer après le remplacement d'une caméra ou une modification de l'éclairage, même si le modèle lui-même reste inchangé. Pour détecter les variations de distribution, enregistrez en continu les indicateurs de confiance, les amplitudes des actions et le nombre d'interventions de la couche de supervision. Si des valeurs anormales persistent, il est plus facile de diagnostiquer un passage en mode lent ou en mode manuel que de procéder à des essais automatiques répétés. Il convient de considérer un ASV comme un composant d'un système qui sépare… L'observation, l'inférence, la limitation et l'arrêt favorisent à la fois la reproductibilité et la sécurité.
La compréhension apparente des instructions garantit-elle une action robotique sûre ?
Les limites d'action, les conditions d'exécution, la détection des défaillances et les mécanismes d'arrêt restent nécessaires. La maîtrise du langage n'est pas une preuve de réussite physique.
Références
-
Vision Language Action Models in Robotic Manipulation: A Systematic Review (arXiv)
-
Precise Manipulation with Efficient Online RL (Intelligence physique)](https://www.pi.website/research/rlt)
-
VLA avec mémoire à court et à long terme (Intelligence physique)
-
Couverture du dépôt GitHub openpi sur l'intelligence physique (The Robot Report)
-
Modèles Vision-Langage-Action (VLA) pour la robotique (Blog Roboflow)
-
Étude sur les modèles Vision-Langage-Action : une perspective de tokenisation des actions (arXiv)
Commentaires
Veuillez vous connecter.
Aucune entrée pour le moment.