Contents — find the section you need
La navigation robotique est la technologie qui consiste à planifier un itinéraire entre la position actuelle et un objectif sur une carte, puis à le suivre en évitant les obstacles. Une approche classique comme Nav2 (celle utilisée par newbot) reste la plus courante en pratique, tandis que la recherche sur les approches de bout en bout basées sur l'apprentissage par renforcement et les modèles vision-langage connaît une croissance rapide.
 ROS 2 / Nav2
Image : Robot Operating System logo, Wikimedia Commons (CC BY-SA 4.0)

Aperçu de la navigation autonome
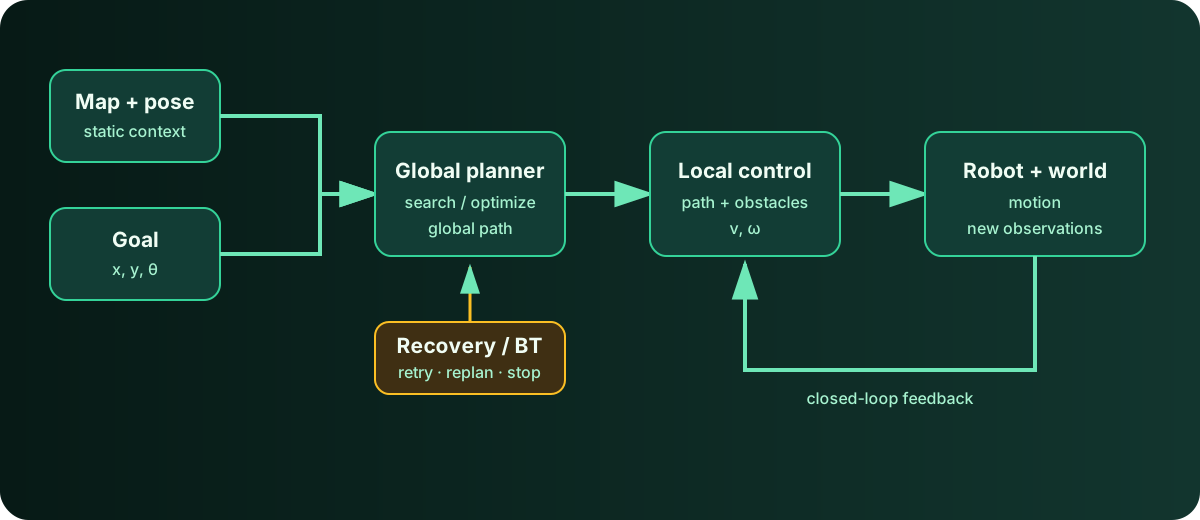
Schéma : Duskcoil. La répartition des responsabilités dans une architecture de navigation hiérarchique comme Nav2 est simplifiée.
La navigation ne se limite pas au calcul ponctuel du chemin le plus court. Un planificateur global analyse la carte, un contrôleur local convertit la trajectoire en commandes de vitesse en tenant compte des obstacles environnants et des contraintes du véhicule, et les observations post-déplacement permettent de mettre à jour la décision suivante. L'arrêt, la replanification et la récupération font également partie intégrante du système. Les sections suivantes peuvent donc être interprétées en se demandant où les instructions de planification, de contrôle, d'apprentissage et de langage interviennent dans cette boucle fermée commune.
Le pipeline classique : Séparation de la carte des coûts et de la planification de trajectoire
Une architecture de navigation classique, dont Nav2 est un exemple, construit une carte des coûts (une carte 2D représentant le risque d'obstacles) à partir des données des capteurs, puis exécute la planification de trajectoire globale et le suivi de trajectoire local comme des modules distincts. Le rôle de chaque module est clair et le comportement qui en résulte est facile à comprendre et à paramétrer, mais sa capacité d'adaptation à un environnement imprévu (une forme d'obstacle inhabituelle, une foule dense) présente des limites réelles. newbot utilise également ce pipeline classique ; voir « Fonctionnement de la cartographie et de la navigation autonome » pour plus de détails sur l’implémentation.
Cinématique sous-jacente : Conversion de vitesse pour un système à entraînement différentiel
Quelle que soit la méthode de navigation utilisée, la sortie finale du contrôleur se résume à deux valeurs : la vitesse de translation v et la vitesse angulaire \omega. Pour un robot à entraînement différentiel comme newbot (deux roues, gauche et droite), le modèle cinématique sous-jacent convertit ces deux valeurs en vitesses de roue gauche/droite v_l, v_r.
L représente la distance entre les roues gauche et droite (la largeur de la voie). La transformation inverse est utilisée pour passer d’une vitesse planifiée (v, \omega) à une vitesse cible pour chaque roue. Ce simple système d'équations capture la contrainte fondamentale de la transmission différentielle (absence de mouvement latéral ; tout virage nécessite une différence de vitesse entre les roues). Quelle que soit la sophistication de la carte de coûts ou de la planification de trajectoire, les moteurs sont finalement pilotés par ce modèle cinématique. L'implémentation de newbot est également décrite dans « Comment fonctionne le contrôle de vitesse sécurisé ».
Au cœur de Nav2 : Carte de coûts, contrôleur, arbre de comportement
Examinons plus concrètement la coopération des modules au sein du pipeline classique : Nav2 construit sa carte de coûts (une carte 2D représentant le risque d'obstacles) en empilant plusieurs « couches ». Une couche reflète les données cartographiques statiques, une couche détecte et suit les obstacles dynamiques à partir des données de la caméra ou du capteur de profondeur, et une couche réécrit la carte de coûts selon des règles. L'empilement de couches aux rôles différents permet d'intégrer une variété de sources d'information, bien plus que n'importe quel algorithme ne pourrait en représenter seul, dans une représentation cartographique unique.
Le serveur de contrôle, chargé de suivre la trajectoire, pilote le robot le long de la dernière trajectoire globale planifiée, en se référant à la carte des coûts locale et en interagissant avec des plugins de support : un vérificateur de progression et un vérificateur d'objectif. Le serveur de comportement, qui gère les comportements de récupération (rotation sur place, marche arrière), est conçu pour référencer la même carte des coûts locale que le serveur de contrôle en temps réel. Cette configuration efficace évite de stocker une représentation de l'environnement dupliquée à plusieurs endroits.
L'ordre et les conditions d'appel de ces serveurs sont contrôlés par l'arbre de comportement. Nav2 utilise la bibliothèque BehaviorTree.CPP, où chaque nœud de l'arbre, à chaque activation (déclenchement de son exécution), appelle un serveur d'action : le planificateur, le contrôleur ou un serveur de comportement. Cette conception permet de réorganiser une logique de branchement complexe – par exemple, « en cas d'échec de la planification de la trajectoire, réessayer jusqu'à N fois avant d'opter pour un autre comportement de récupération » – uniquement via la configuration de l'arbre de comportement, sans modifier le code de chaque serveur.
La diffusion de la navigation apprise de bout en bout
L'approche actuelle, à l'opposé du pipeline classique, est la navigation de bout en bout basée sur l'apprentissage, qui génère des actions directement à partir des données brutes des capteurs. Dans des scénarios coopératifs réalistes, comme le passage d'une porte, certaines études montrent que les méthodes basées sur l'apprentissage surpassent celles basées sur des modèles. L'apprentissage par renforcement profond (DRL) est devenu l'une des principales tendances de la recherche sur la navigation sous ROS. Des algorithmes comme TD3 (Twin-Delayed DDPG), DDPG et DQN ont été appliqués à la détection, au suivi et à la navigation d'objets en temps réel. Des méthodes hybrides, combinant l'apprentissage par imitation (apprentissage d'une politique initiale à partir de démonstrations d'experts) et l'apprentissage par renforcement (amélioration continue de cette politique), ont également émergé.
L'évolution des modèles de navigation fondamentaux
Une approche plus récente consiste à entraîner la navigation elle-même en tant que « modèle fondamental ». Un cadre combinant le pré-entraînement vidéo hors ligne et le post-entraînement par apprentissage par renforcement en simulation (S2E : Voir-à-Expérimenter) vise à renforcer l’interactivité tout en préservant les performances de généralisation. Les recherches intégrant des modèles vision-langage à la navigation (Navi2Gaze, par exemple) progressent également, explorant une approche où la cible de navigation est spécifiée non par des coordonnées sur une carte, mais par le langage naturel ou une image cible (ce domaine recoupe également celui de l’apprentissage du langage visuel – voir « Tendances technologiques en apprentissage du langage visuel » pour plus de détails).
Navigation sociale
Pour un robot d’intérieur évoluant dans un environnement où se déplacent des personnes, adopter un comportement « naturel » – et pas seulement éviter les obstacles – est devenu un axe de recherche important à part entière. Dans le domaine de la navigation sociale, trois défis sont généralement identifiés comme les principaux problèmes de recherche : des modèles capables de prédire avec précision les mouvements humains, des environnements d’apprentissage simulant de manière réaliste des contextes encombrés et des métriques d’évaluation capables de saisir la complexité du monde réel. La recherche active combine plusieurs familles d'algorithmes d'apprentissage par renforcement (basés sur la valeur, basés sur les politiques, acteur-critique) avec diverses architectures de réseaux neuronaux (à propagation directe, récurrents, convolutionnels, graphes, transformeurs).
Résultats concrets de la navigation basée sur l'apprentissage : 2026 en chiffres
Les recherches menées jusqu'en 2026 ont de plus en plus étayé leurs affirmations par des chiffres concrets plutôt que par de vagues « performances améliorées ». CORE Planner (juin 2026), qui explore des environnements inconnus sans carte préalable, combine une représentation par graphe de visibilité clairsemé avec un transformeur et affiche une réduction de 13 % de la distance parcourue par rapport au FAR Planner traditionnel et jusqu'à 48 % par rapport à d'autres systèmes de référence basés sur l'apprentissage, tout en assurant un transfert simulé-réel sans entraînement supplémentaire. FlashNav (juin 2026), qui réduit considérablement le temps d'entraînement, élimine les rendus superflus et la physique haute fidélité de la simulation et exécute un pipeline d'entraînement résident sur GPU, atteint un taux de réussite de 100 % avec un entraînement de la politique terminé en moins de 20 secondes sur une RTX 5090 — et transfère avec succès la politique entraînée à des robots physiques.
Des progrès quantitatifs apparaissent également dans la navigation sociale. HUMA (juillet 2026), une approche hybride qui active sélectivement le raisonnement VLM (Vision-Langage Model) uniquement lorsque des personnes sont à proximité, tout en s'appuyant sinon sur l'efficacité de calcul d'une politique d'apprentissage par renforcement, affiche des améliorations de réussite de tâches de 20 % et 3 % sur les benchmarks Social-MP3D et Social-HM3D, respectivement. La décision de conception clé n'est pas de « toujours exécuter le raisonnement coûteux » mais de « ne l'exécuter que lorsqu'il est réellement nécessaire » — un choix qui concilie précision et coût de calcul.
Modèles de navigation fondamentale : des exemples concrets
L'approche des « modèles de navigation fondamentale » (S2E et autres) s'est concrétisée par des implémentations plus tangibles jusqu'en 2026. SuperMap (août 2026, accepté à RSS 2026) intègre le SLAM géométrique haute fréquence à la perception asynchrone à vocabulaire ouvert pour construire un graphe de scène 4D (espace et temps) prenant en charge les requêtes compositionnelles sur la sémantique et les relations entre les objets. Conçu pour maintenir une identité stable des objets (appariement et reconnaissance d'objets dans l'espace 3D), même dans des environnements dynamiques, il sert de base à la navigation robotique pilotée par des instructions en langage naturel.
Un exemple plus léger est GemNav (juillet 2026), qui adapte un LLM multimodal pré-entraîné et figé pour gérer la navigation par points de passage via des jetons discrets. Il ne nécessite aucun encodeur visuel dédié et se positionne comme une alternative économe en données, permettant un transfert sans exemple vers des environnements intérieurs et extérieurs inconnus à partir d'une petite quantité de données d'entraînement, sans avoir à optimiser entièrement un modèle de base complexe. Une approche de navigation hors ligne par vision et langage (juillet 2026) est également prévue. Fonctionnant entièrement sur l'appareil et sans dépendance au cloud, elle combine la détection d'objets à vocabulaire ouvert, la segmentation par invite et la géométrie LiDAR pour estimer la position des cibles extérieures à l'aide d'un simple modèle de langage. Ces avancées indiquent que la navigation guidée par le langage naturel passe du stade de la recherche à une application concrète.
État des lieux en pratique
Actuellement, aucune de ces solutions n'est en mesure de remplacer un pipeline classique comme Nav2. Les méthodes d'apprentissage automatique donnent d'excellents résultats en recherche, mais le coût de la vérification de leur reproductibilité et de leur sécurité sur du matériel réel est élevé, et leur déploiement en production et à grande échelle reste limité. La conception même de Newbot — un planificateur de trajectoire classique associé à une couche de supervision de sécurité indépendante, incluant un coupe-circuit physique (voir « Comment fonctionne le contrôle de vitesse sécurisé » pour plus de détails) — reflète l'état de l'art pratique actuel. Même si les méthodes d'apprentissage automatique se développent et trouvent des applications concrètes, le choix réaliste, du moins dans un avenir proche, semble être une solution hybride reposant sur des mécanismes de sécurité classiques.
Une localisation précise garantit-elle l'atteinte de l'objectif ?
La cartographie, la gestion des obstacles, la planification et le contrôle doivent également être maîtrisés.
La précision de la localisation ne représente qu'une partie des performances de navigation. ## Références - [Navigation de robots sociaux : revue et évaluation comparative des méthodes d'apprentissage](https://www.ncbi.nlm.nih.gov/pmc/articles/PMC12739477/) - [De la vision à l'expérience : passage à l'échelle des modèles de navigation de base grâce à l'apprentissage par renforcement (arXiv)](https://arxiv.org/abs/2507.22028) - [Nav2 GitHub (ros-navigation)](https://github.com/ros-navigation/navigation2) - [Concepts de navigation — Documentation officielle de Nav2](https://docs.nav2.org/concepts/index.html) - [Présentation détaillée de l'arbre de comportement — Documentation officielle de Nav2](https://docs.nav2.org/behavior_trees/overview/detailed_behavior_tree_walkthrough.html) - [Article CORE Planner (arXiv)](https://arxiv.org/abs/2606.29222) - [Article FlashNav (arXiv)](https://arxiv.org/abs/2606.15846) - [Think When] [Article sur It Matters (HUMA) (arXiv)](https://arxiv.org/abs/2607.10991) - [Article sur SuperMap (RSS 2026, arXiv)](https://arxiv.org/abs/2608.22896) - [Article sur GemNav (arXiv)](https://arxiv.org/abs/2607.06882) - L'implémentation de newbot est également décrite dans « Fonctionnement de la cartographie et de la navigation autonome » et « Fonctionnement du contrôle de vitesse sécurisé ».
Commentaires
Veuillez vous connecter.
Aucune entrée pour le moment.