Contents — find the section you need
机器人导航是指规划从当前位置到地图上目标位置的路径,然后沿着该路径行驶并避开障碍物的技术。像Nav2这样的经典流程(newbot使用的就是这种流程)仍然是实践中的主流选择,而基于强化学习和视觉语言模型的端到端方法的研究正在迅速发展。
 ROS 2 / Nav2
图片:Robot Operating System logo, Wikimedia Commons (CC BY-SA 4.0)

自主导航概览
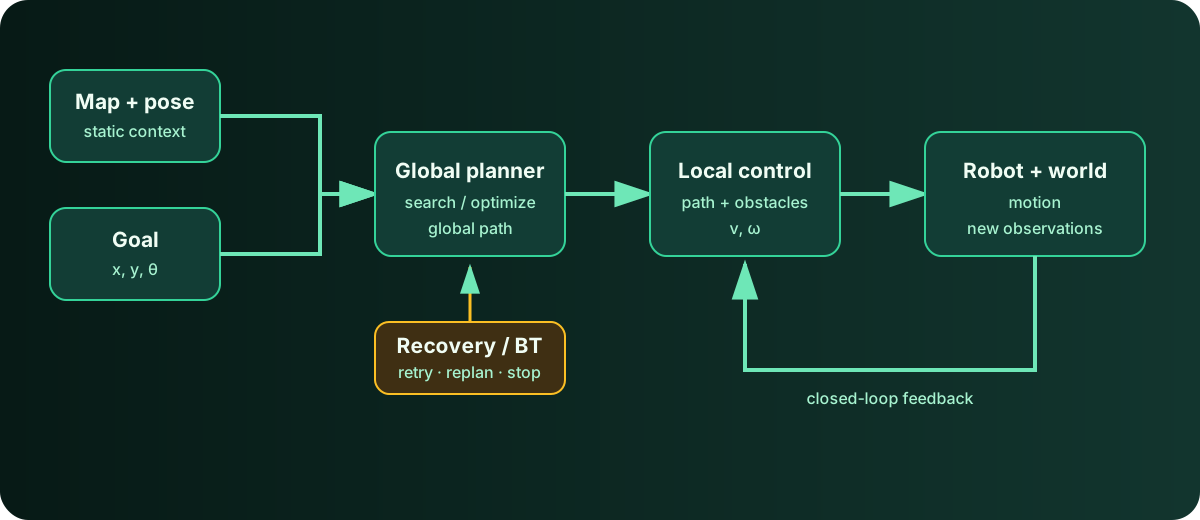
图:Duskcoil。在 Nav2 等分层导航堆栈中,职责划分得到简化。
导航不仅仅是计算一次最短路径。全局规划器会遍历地图,局部控制器会将路径转换为速度指令,同时考虑附近的障碍物和车辆约束,运动后的观测结果会更新下一步决策。停止、重新规划和恢复也是系统的一部分。因此,以下各节可以通过思考规划、控制、学习和语言指令如何融入这个共同的闭环来理解。
经典流程:将代价地图与路径规划分离
以 Nav2 为代表的经典导航协议栈会根据传感器数据构建代价地图(表示障碍物风险的二维地图),然后在此基础上运行全局路径规划和局部轨迹跟踪这两个独立的模块。每个模块的作用都很明确,最终的行为也易于理解和调整,但它适应意外环境(例如不熟悉的障碍物形状、拥挤的人群)的能力却存在局限性。 newbot 也采用了这种经典的流程——有关实现细节,请参阅“地图构建和自主导航的工作原理”部分。
底层运动学:差速驱动速度转换
无论采用何种导航方法,控制器最终输出的都是一对值:平移速度 v 和角速度 \omega。对于像 newbot 这样的差速驱动机器人(左右两轮),其底层基础是运动学模型,该模型将这对速度转换为左右轮的速度 v_l, v_r。
L 是左右轮之间的距离(轮距)。逆变换用于反向转换——从计划的 (v, \omega) 到每个车轮的目标速度。这对简单的方程式捕捉到了差速驱动的基本约束(不能横向移动;转弯始终需要车轮间的速度差)——无论代价地图或路径规划多么复杂,电机最终都是通过这个运动学模型驱动的。newbot 的实现方式在安全速度控制的工作原理中也有介绍。
Nav2 内部结构:代价地图、控制器、行为树
更具体地来看经典流程中各个模块的协作方式:Nav2 通过堆叠多个“层”来构建其代价地图(一个表示障碍物风险的二维地图)。一个反映静态地图数据的层,一个从摄像头或深度传感器数据中检测和跟踪动态障碍物的层,以及一个根据规则重写代价地图的层——像这样堆叠具有不同功能的层,可以将各种信息源(比任何单一算法单独能够表示的信息量都多)集成到一个地图表示中。
控制器服务器负责跟踪路径,它驱动机器人沿着最近规划的全局路径行进,并参考局部代价地图,同时还与支持插件(进度检查器和目标检查器)协同工作。行为服务器负责处理恢复行为(原地旋转、后退),它与控制器服务器实时共享同一个局部代价地图,这种高效的设置避免了在多个位置维护重复的环境表示对象。
行为树控制着各个服务器的调用顺序和条件。Nav2 使用名为 BehaviorTree.CPP 的库,其中树状结构的节点每次被“触发”(执行)时,都会调用一个动作服务器——规划器、控制器或行为服务器。这种设计使得复杂的逻辑分支(例如“如果路径规划失败,则重试最多 N 次,然后再切换到不同的恢复行为”)能够完全通过行为树的配置进行重新排列,而无需修改任何单个服务器的代码。
端到端学习导航的普及
目前,与传统导航流水线相反的是一种端到端的、基于学习的导航方法,它直接从原始传感器输入输出动作。在诸如穿过门之类的真实协作场景中,一些报告显示,基于学习的方法优于基于模型的方法,深度强化学习 (DRL) 已成为基于 ROS 的导航研究的主要趋势之一。TD3(双延迟 DDPG)、DDPG 和 DQN 等算法已被应用于实时目标检测、跟踪和导航,同时,结合模仿学习(从专家演示中学习初始策略)和强化学习(持续改进该策略)的混合方法也应运而生。
导航基础模型的发展方向
一种新的研究方向是尝试将导航本身训练为“基础模型”。一种结合离线视频预训练和通过强化学习在仿真环境中进行后训练(S2E:视觉到体验)的框架旨在增强交互性,同时保持泛化性能。将视觉语言模型融入导航的研究(例如 Navi2Gaze)也在不断推进,探索着导航目标不再由地图坐标指定,而是由自然语言或目标图像来指定这一方向(这与视觉语言分析领域也有重叠——详情请参见视觉语言分析技术趋势)。
社交导航
对于在人群活动环境中运行的室内机器人而言,如何采取“类人”路径——而不仅仅是避开障碍物——本身已成为一个重要的研究课题。在社交导航领域,通常认为三大挑战是主要的研究问题:能够准确预测人类运动的模型、能够真实模拟拥挤环境的学习环境,以及能够捕捉现实世界复杂性的评估指标。目前的研究正积极将多种强化学习算法(例如基于价值的算法、基于策略的算法和 Actor-Critic 算法)与各种神经网络架构(例如前馈神经网络、循环神经网络、卷积神经网络、图神经网络和 Transformer 神经网络)相结合。
基于学习的导航的具体成果:2026 年数据展望
到 2026 年,研究成果越来越多地以具体数据而非模糊的“性能提升”来佐证其结论。CORE Planner(2026 年 6 月发布)无需预先获取地图即可探索未知环境,它结合了稀疏可见性图表示和 Transformer 模型,与传统的 FAR Planner 相比,行驶距离减少了 13%,与其他基于学习的基线模型相比,最多可减少 48%,同时无需额外训练即可实现零样本仿真到实际的迁移。FlashNav(2026 年 6 月发布)大幅缩短了训练时间,它从仿真中剔除了不必要的渲染和高保真物理效果,并运行 GPU 驻留训练流水线,在 RTX 5090 显卡上实现了 100% 的策略训练成功率,仅需不到 20 秒即可完成,并且能够成功地将训练好的策略迁移到实体机器人上。
在社交导航领域,量化进展也正在显现。 HUMA(2026 年 7 月)是一种混合方法,它仅在有人靠近时才选择性地激活视觉语言模型 (VLM) 推理,而在其他情况下则依赖于强化学习策略的计算效率。该方法在 Social-MP3D 和 Social-HM3D 基准测试中分别实现了 20% 和 3% 的任务成功率提升。其关键设计决策并非“始终运行耗时的推理”,而是“仅在真正需要时运行”——这一选择平衡了准确性和计算成本之间的权衡。
导航基础模型走向具体化:VLN 实现示例
“导航基础模型”方向(例如 S2E)在 2026 年前已逐渐形成更具体的实现方案。SuperMap(2026 年 8 月发布,已被 RSS 2026 接收)将高频几何 SLAM 与异步开放词汇感知相结合,构建了一个支持基于对象语义和关系的组合查询的 4D 场景图(空间加时间)。它旨在即使在动态环境中也能保持稳定的对象身份——在 3D 空间中匹配和重新识别对象——并作为由自然语言指令驱动的机器人导航的基础。
一个更轻量级的示例是 GemNav(2026 年 7 月发布),它调整了一个冻结的、预训练的多模态 LLM,以通过离散标记处理航点导航。它无需专用的视觉编码器,定位为“数据高效的替代方案”——仅需少量训练数据即可实现对未见过的室内外环境的零样本迁移,而无需对大型基础模型进行全面微调。此外,还有一种离线视觉语言导航方法(预计于2026年7月发布),完全在设备端运行,无需依赖云端,结合了开放词汇表目标检测、基于提示的分割和激光雷达几何信息,仅使用一个小型语言模型即可估计室外目标位置。总而言之,这些都表明“自然语言导航”正从研究课题走向实际应用。
实践现状
目前,这些方法都还无法取代像Nav2这样的传统导航流程。基于学习的方法在研究环境中表现出色,但在实际硬件上验证其可复现性和安全性的成本很高,因此其在生产环境中的部署和大规模应用仍然有限。 newbot 的自主设计——一个经典的路径规划器,搭配一个独立的安全监督层,包括一个物理紧急停止开关(详情请参见安全速度控制的工作原理)——可以被视为该领域实际应用水平的体现。即使基于学习的方法正朝着实际应用的方向发展,至少在可预见的未来,更现实的选择似乎是围绕经典安全机制构建的混合方案。
精确定位能否保证到达目标?
地图构建、障碍物处理、路径规划和控制也必须成功。
定位精度只是导航性能的一部分。
评论
请先登录。
暂无数据。