Contents — find the section you need
视觉SLAM是一系列仅依赖摄像头拍摄的视频(或摄像头加IMU组合)进行自定位和地图构建的技术。它不需要像激光雷达(LiDAR)那样昂贵的测距传感器,但它也存在一个弱点——对光照变化和纹理粗糙的场景较为敏感——而克服这一弱点的历史本身就是该技术发展趋势的一部分。
 OpenCV
图片:OpenCV logo, Wikimedia Commons (Apache 2.0)

Visual-SLAM 概览
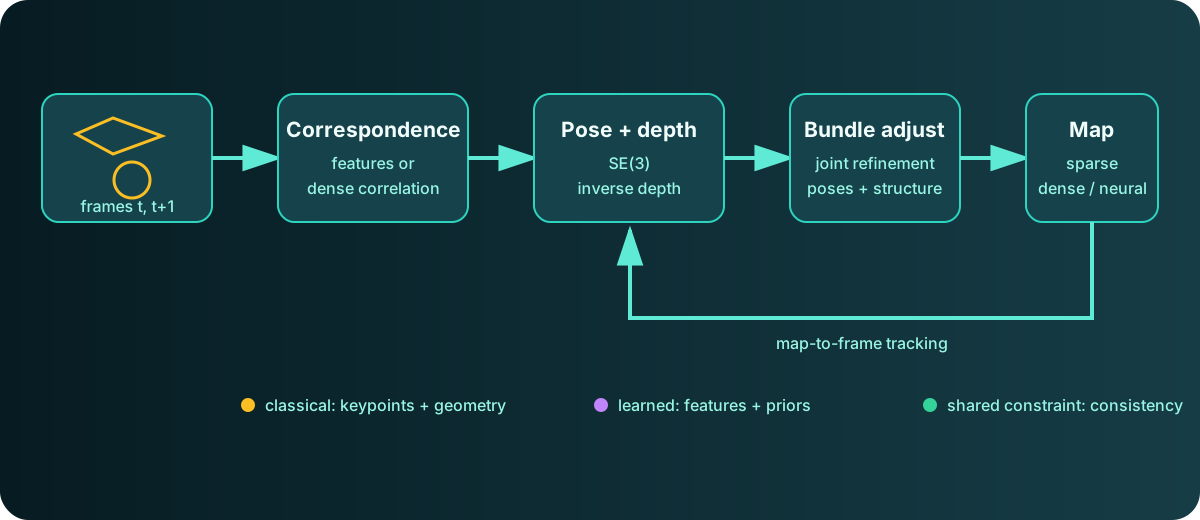
图:Duskcoil。它展示了经典方法和基于学习的方法所共有的几何关系。
Visual-SLAM 的核心问题是将帧间的同一位置关联起来,并联合恢复使这些关联一致的相机运动和 3D 结构。经典方法显式地匹配稀疏关键点;基于学习的方法通过密集特征或学习到的先验信息来推断对应关系。两者都受限于观测姿态与结构的一致性。地图是稀疏点云、密集深度图还是神经表示,是另一个重要的实际选择。
基于特征点的端点:ORB-SLAM3
经典视觉SLAM的一个端点是ORB-SLAM3。它可以实时运行视觉SLAM、视觉惯性SLAM或多地图SLAM,支持单目、双目或RGB-D设置。它使用名为ORB的特征描述符来寻找图像之间的对应关系,然后通过光束法平差优化姿态和地图点。光束法平差最小化的是,在相机姿态(\mathbf{R}_j, \mathbf{t}_j)下,3D地图点\mathbf{X}_i投影到图像中的位置与对应特征点\mathbf{u}_{ij}在图像中实际观测到的位置之间的误差(重投影误差)之和。
这里的 \pi(\cdot) 是基于相机内参的三维点到图像平面的投影函数。联合优化相机位姿和地图点的这个表达式是光束法平差的本质,它在与前面讨论的图优化相同的非线性最小二乘框架下求解(详情请参见SLAM 技术趋势)。发布多年后,它仍然被研究论文引用为比较基准——事实上的标准参考实现。
基于深度学习的端到端:DROID-SLAM
还有一个成熟的趋势是直接用深度学习取代显式的特征提取和匹配过程。DROID-SLAM 就是一个领先的例子,它通过循环迭代更新和密集光束法平差层来估计相机位姿和逐像素深度。尽管仅使用单目视频进行训练,但它足够灵活,可以在测试时利用立体视频或 RGB-D 视频来提高精度。不过,它的计算需求比传统方法更高——仅推理就需要 11 GB 或更多的 GPU 内存。
DROID-SLAM 内部原理:相关体和可微分光束法平差
更深入地了解 DROID-SLAM 如何在不进行显式特征提取的情况下估计姿态和深度:它首先使用两个 CNN(一个用于特征提取,一个用于上下文信息)计算输入分辨率为 1/8 的密集特征图。对于每一对帧,它通过穷举计算每对特征向量之间的点积来构建“4D 相关体”,这成为估计像素级对应关系的基础。
估计本身由迭代更新算子处理。来自相关体的特征,连同上一次迭代的残差(校正值),通过卷积层进入卷积门控循环单元(ConvGRU),该单元输出对流(表观运动)的校正值。门控机制——使网络能够选择性地控制哪些信息被纳入以及哪些信息被舍弃——正是该网络实际学习到的部分。
这种迭代更新的输出被送入一个可微分的密集束调整(DBA)层,该层同时更新相机位姿和逐像素逆深度。通过这种方式将几何约束显式地嵌入网络,即使是单目训练的模型也能灵活地处理立体或RGB-D输入,而无需重新训练。
重塑地图表示:3D高斯散射和NeRF
目前发展最快的领域是对地图表示格式本身的重塑。神经辐射场(NeRF)和三维高斯散射(3DGS)能够将逼真的三维场景表示为一组紧凑的参数,而非简单的点云。这一特性正稳步提升SLAM的建图精度、渲染质量和计算效率。
进入2026年,一系列基于3DGS/NeRF的新方法不断涌现于各大会议和期刊:Splat-SLAM,仅使用RGB视频即可进行全局优化;Gaussian-LIC/Gaussian-LIC2,融合了激光雷达、惯性测量单元(IMU)和相机数据;GTS-SLAM,针对地下矿井等恶劣环境;MTE-SLAM(ICRA 2026),面向语义SLAM;以及PMET-SLAM,兼顾逼真的建图和高效的跟踪。与传统方法相比,渲染质量和地图可重用性(事后从任意视角重新渲染环境的能力)被认为是其显著优势。
2025-2026 年发展趋势:基于前馈 3D 基础模型的 SLAM
MASt3R-SLAM(一篇 CVPR 2025 亮点论文,预计于 2024 年底发布)在 DROID-SLAM 的设计(迭代估计加可微分光束法平差)的基础上更进一步,将 MASt3R(一个在双视图 3D 重建和对应关系上预训练的基础模型)的输出视为“先验知识”。即使在相机内参未知的情况下,它也能在一个框架内处理点图匹配、相机跟踪、局部地图融合和回环检测,在已知相机模型的情况下以 15 FPS 的速度运行,并且据报道在多个基准测试中达到了最先进的精度。
随着2025年VGGT(视觉几何接地Transformer)的问世,这一基础模型发展线获得了进一步的推动。VGGT是一个前馈式3D基础模型,它能够在一次前向传播过程中,同时从多视角图像中输出相机位姿、深度和点云。基于VGGT输出的一系列衍生研究成果在2026年之前陆续涌现。VGGT-SLAM++(2026年4月)将VGGT的Transformer输出与频繁的局部优化(通过共视图和视觉位置识别)相结合,从而将轨迹稳定化,最终形成一个完整的SLAM系统。VGGT-Align(2026年8月)则通过从每个数据块的点云中提取主导几何不变量来约束尺度,从而解决长序列中数据块之间的尺度漂移问题。分析工作也相继涌现,例如 Co-VGGT(2026 年 7 月),该研究表明 VGGT 无需任何显式监督信号即可隐式编码共视性(哪些视点共享同一区域)——这是一项积极探索如何理解这些基础模型内部表征实际捕捉到的信息的研究。
基准测试结果:更精确,但并非万能灵药
2026 年下半年,一系列量化基于基础模型的 SLAM 实际性能的研究相继出现。一项针对 DJI 无人机高空俯视视频的评估比较了五种单目 SLAM 系统,结果发现 MASt3R-SLAM 的平均水平绝对误差最低,仅为路径长度的 0.53%,但同时也指出垂直(高度)精度仍然是一个开放性问题。另一项研究(2026 年 8 月)评估了单目 SLAM 在合成和真实世界数据损坏条件下的性能,发现传统的基于特征的方法在数据劣化条件下往往会出现“灾难性的跟踪失败”,而学习型跟踪器则主要用“持续的、有时甚至是严重的漂移”来替代这种灾难性的失败。换句话说,学习型方法可能用一种更隐蔽的、误差累积不易察觉的模式来取代一种显而易见的、剧烈的失败模式——这提醒我们,仅凭精度指标并不能全面反映哪种方法更优。
对于尺度模糊性——单目数据无法单独恢复绝对距离尺度这一经典弱点——也涌现出了新的方法。Scalix(2026 年 8 月)将学习到的深度预测集成到概率因子图中,并在度量(绝对尺度)和尺度一致(相对尺度)基准测试中均取得了最先进的性能。
实际选择标准
目前实际的选择标准如下:
-
资源受限,但拥有可靠的实际应用记录:ORB-SLAM3 系列中基于特征点的定位方法——即使在嵌入式硬件上,也拥有丰富的实际应用经验
-
精度优先,GPU 资源充足:DROID-SLAM 系列中基于端到端深度学习的定位方法
-
能够泛化到陌生环境,无需校准:MASt3R-SLAM/VGGT 系列中基于前馈 3D 基础模型的定位方法——尽管仍存在一些未解决的问题,例如垂直精度和长时间运行后的漂移
-
需要逼真的地图复用:基于 3DGS/NeRF 的定位方法——尽管许多方法仍处于研究阶段,实际应用仍在发展中
这些定位方法之间并没有真正的相互替代——目前的实际情况是,它们正在根据不同的应用场景进行划分。
良好的新视角渲染能否建立正确的相机姿态?
将渲染质量与几何和轨迹精度分开衡量。
仅凭视觉质量无法对定位方法进行排名。
评论
请先登录。
暂无数据。