Contents — find the section you need
विज़ुअल-एसएलएएम उन तकनीकों का समूह है जो केवल कैमरा फुटेज (या कैमरा-प्लस-आईएमयू संयोजन) के आधार पर स्व-स्थान निर्धारण और मानचित्रण करती हैं। इसमें लिडार जैसे महंगे रेंजिंग सेंसर की आवश्यकता नहीं होती है, लेकिन इसकी एक कमजोरी है - प्रकाश परिवर्तन और कमज़ोर बनावट वाले दृश्यों के प्रति संवेदनशीलता - और इस कमजोरी को दूर करने का इतिहास ही मूल रूप से इस तकनीक का चलन है।
 OpenCV
छवि: OpenCV लोगो, विकिमीडिया कॉमन्स (अपैची 2.0)

विज़ुअल-एसएलएएम एक नज़र में
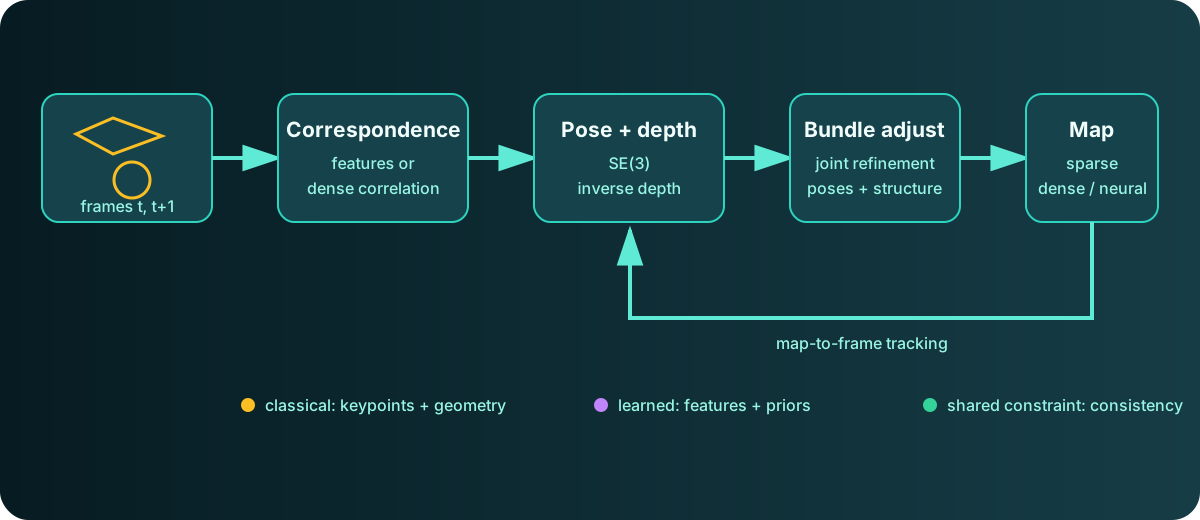
आरेख: डस्ककॉइल। यह शास्त्रीय और अधिगम-आधारित दृष्टिकोणों द्वारा साझा किए गए ज्यामितीय संबंधों को दर्शाता है।
विज़ुअल-एसएलएएम में केंद्रीय समस्या फ़्रेमों में एक ही स्थान को संबद्ध करना और कैमरा गति और 3डी संरचना को संयुक्त रूप से पुनर्प्राप्त करना है जो उन संबद्धताओं को सुसंगत बनाते हैं। शास्त्रीय विधियाँ स्पष्ट रूप से विरल कुंजी बिंदुओं का मिलान करती हैं; अधिगम-आधारित विधियाँ सघन विशेषताओं या सीखे गए पूर्व ज्ञान से पत्राचार का अनुमान लगाती हैं। दोनों अवलोकन-स्थिति-संरचना संगति से बंधी रहती हैं। मानचित्र एक विरल बिंदु क्लाउड है, सघन गहराई है, या एक तंत्रिका प्रतिनिधित्व है, यह एक और महत्वपूर्ण व्यावहारिक विकल्प है।
फ़ीचर-पॉइंट-आधारित एंडपॉइंट: ORB-SLAM3
शास्त्रीय विज़ुअल-एसएलएएम का एक एंडपॉइंट ORB-SLAM3 है। यह मोनोक्युलर, स्टीरियो या RGB-D सेटअपों में वास्तविक समय में विज़ुअल, विज़ुअल-इनर्टियल या मल्टी-मैप एसएलएएम चला सकता है, ORB नामक एक फ़ीचर डिस्क्रिप्टर का उपयोग करके छवियों के बीच पत्राचार ढूंढता है, और फिर बंडल समायोजन के माध्यम से स्थिति और मानचित्र बिंदुओं को अनुकूलित करता है। बंडल एडजस्टमेंट उस बेमेल (रीप्रोजेक्शन त्रुटि) के योग को न्यूनतम करता है जो 3D मानचित्र बिंदु \mathbf{X}_i के उस स्थान के बीच होता है जहाँ उसे कैमरा पोज़ (\mathbf{R}_j, \mathbf{t}_j) के तहत छवि में प्रक्षेपित किया जाता है, और जहाँ संबंधित फ़ीचर बिंदु \mathbf{u}_{ij} वास्तव में छवि में देखा गया था।
यहाँ \pi(\cdot) कैमरे के आंतरिक मापदंडों पर आधारित, 3D बिंदु से छवि तल पर प्रक्षेपण फ़ंक्शन है। कैमरा पोज़ और मानचित्र बिंदुओं दोनों पर इस व्यंजक को संयुक्त रूप से अनुकूलित करना बंडल एडजस्टमेंट का सार है, जिसे उसी अरैखिक न्यूनतम वर्ग ढांचे के भीतर हल किया जाता है जैसा कि पहले वर्णित ग्राफ़ अनुकूलन (विवरण के लिए "SLAM में प्रौद्योगिकी रुझान" देखें)। इसके जारी होने के वर्षों बाद भी, इसे शोध पत्रों में तुलनात्मक आधार रेखा के रूप में उद्धृत किया जाता है - वास्तविक मानक संदर्भ कार्यान्वयन।
डीप लर्निंग के ज़रिए संपूर्ण विश्लेषण: DROID-SLAM
फीचर एक्सट्रैक्शन और मैचिंग की स्पष्ट प्रक्रिया को सीधे डीप लर्निंग से बदलने का चलन भी तेज़ी से बढ़ रहा है। DROID-SLAM इसका प्रमुख उदाहरण है, जो आवर्ती पुनरावृत्ति अपडेट और एक सघन बंडल-एडजस्टमेंट लेयर के माध्यम से कैमरा पोज़ और प्रति-पिक्सेल गहराई का अनुमान लगाता है। हालांकि इसे केवल मोनोक्युलर वीडियो पर प्रशिक्षित किया गया है, लेकिन यह बेहतर सटीकता के लिए परीक्षण के समय स्टीरियो या RGB-D वीडियो का भी उपयोग करने में सक्षम है। हालांकि, इसकी कंप्यूटिंग आवश्यकताएं पारंपरिक विधियों की तुलना में अधिक हैं - केवल इन्फरेंस के लिए ही 11 GB या उससे अधिक GPU मेमोरी की आवश्यकता होती है।
DROID-SLAM के अंदर: सहसंबंध वॉल्यूम और डिफरेंशिएबल बंडल एडजस्टमेंट
DROID-SLAM बिना स्पष्ट फीचर एक्सट्रैक्शन के पोज़ और गहराई का अनुमान कैसे लगाता है, इस पर थोड़ा और गौर करें: यह पहले इनपुट रिज़ॉल्यूशन के 1/8 पर सघन फीचर मैप्स की गणना करता है, जिसमें दो CNN का उपयोग किया जाता है - एक फीचर एक्सट्रैक्शन के लिए, दूसरा प्रासंगिक जानकारी के लिए। प्रत्येक फ्रेम जोड़ी के लिए, यह फीचर वैक्टर की प्रत्येक जोड़ी के बीच डॉट प्रोडक्ट की गणना करके एक "4D सहसंबंध वॉल्यूम" बनाता है, जो पिक्सेल-वार पत्राचार का अनुमान लगाने का आधार बनता है।
यह अनुमान एक पुनरावर्ती अपडेट ऑपरेटर द्वारा नियंत्रित किया जाता है। सहसंबंध वॉल्यूम से प्राप्त फीचर्स, पिछली पुनरावृति से प्राप्त अवशिष्ट (सुधार) के साथ, कनवोल्यूशनल परतों से गुजरते हुए एक ConvGRU (एक कनवोल्यूशनल गेटेड रिकरेंट यूनिट) में जाते हैं, जो प्रवाह (स्पष्ट गति) में सुधार आउटपुट करता है। गेटिंग तंत्र - जो नेटवर्क को चुनिंदा रूप से यह नियंत्रित करने देता है कि कौन सी जानकारी शामिल करनी है और कौन सी छोड़नी है - वह हिस्सा है जिसे नेटवर्क ने वास्तव में सीखा है।
इस पुनरावर्ती अपडेट का आउटपुट एक डिफरेंशिएबल डेंस बंडल एडजस्टमेंट (DBA) परत में जाता है जो कैमरा पोज और प्रति-पिक्सेल व्युत्क्रम गहराई को एक साथ अपडेट करता है। इस प्रकार नेटवर्क में ज्यामितीय बाधाओं को स्पष्ट रूप से शामिल करने से एक मोनोक्युलर-प्रशिक्षित मॉडल को भी बिना पुनः प्रशिक्षण के स्टीरियो या RGB-D इनपुट को संभालने की सुविधा मिलती है।
मानचित्र निरूपण का पुनर्आविष्कार: 3डी गॉसियन स्प्लैटिंग और NeRF
वर्तमान में सबसे तेजी से विकसित हो रहा क्षेत्र मानचित्र निरूपण प्रारूप का पुनर्आविष्कार है। न्यूरल रेडियंस फील्ड्स (NeRF) और 3डी गॉसियन स्प्लैटिंग (3DGS) एक फोटोरियलिस्टिक 3डी दृश्य को साधारण बिंदु क्लाउड के बजाय मापदंडों के एक संक्षिप्त समूह के रूप में निरूपित कर सकते हैं। यह विशेषता SLAM की मानचित्रण सटीकता, प्रतिपादन गुणवत्ता और गणनात्मक दक्षता को लगातार बढ़ा रही है।
2026 तक, प्रमुख सम्मेलनों और पत्रिकाओं में 3DGS/NeRF-आधारित नई विधियों की एक श्रृंखला लगातार सामने आती रही है: स्प्लैट-SLAM, जो केवल RGB वीडियो से वैश्विक अनुकूलन करता है; गॉसियन-LIC/गॉसियन-LIC2, जो LiDAR, IMU और कैमरे को एकीकृत करते हैं; GTS-SLAM, जो भूमिगत खानों जैसे कठोर वातावरणों के लिए लक्षित है; MTE-SLAM (ICRA 2026), जो सिमेंटिक SLAM की ओर उन्मुख है; और PMET-SLAM, जो फोटोरियलिस्टिक मैपिंग और कुशल ट्रैकिंग के बीच संतुलन बनाता है। पारंपरिक विधियों की तुलना में, रेंडरिंग गुणवत्ता और मानचित्र पुन: प्रयोज्यता (किसी भी दृष्टिकोण से बाद में वातावरण को पुनः रेंडर करने की क्षमता) को इसकी स्पष्ट खूबियों के रूप में बताया गया है।
2025-2026 का वर्तमान: फीड-फॉरवर्ड 3D फाउंडेशन मॉडल पर आधारित SLAM
DROID-SLAM के डिज़ाइन — पुनरावृत्ति अनुमान और विभेदनीय बंडल समायोजन — को एक कदम आगे ले जाते हुए, MASt3R-SLAM (एक CVPR 2025 हाईलाइट पेपर), जो 2024 के अंत में प्रकाशित हुआ, MASt3R के आउटपुट — दो-दृश्य 3D पुनर्निर्माण और पत्राचार पर पूर्व-प्रशिक्षित एक फाउंडेशन मॉडल — को "पूर्व ज्ञान" के रूप में मानता है। यह एक ही फ्रेमवर्क के भीतर पॉइंटमैप मैचिंग, कैमरा ट्रैकिंग, लोकल मैप फ्यूजन और लूप-क्लोजर डिटेक्शन को संभालता है, यहां तक कि तब भी जब कैमरा इंट्रिंसिक्स अज्ञात हों। यह ज्ञात कैमरा मॉडल के साथ 15 FPS पर चलता है और कई बेंचमार्क में अत्याधुनिक सटीकता हासिल करने का दावा करता है।
2025 में VGGT (विजुअल ज्योमेट्री ग्राउंडेड ट्रांसफॉर्मर) के आगमन के साथ इस फाउंडेशन-मॉडल श्रृंखला को और गति मिली - एक फीड-फॉरवर्ड 3D फाउंडेशन मॉडल जो एक ही फॉरवर्ड पास में मल्टी-व्यू छवियों से कैमरा पोज, डेप्थ और पॉइंट क्लाउड को एक साथ आउटपुट करता है। VGGT के आउटपुट पर आधारित व्युत्पन्न अनुसंधान की एक लहर 2026 तक जारी रही। VGGT-SLAM++ (अप्रैल 2026) VGGT के ट्रांसफॉर्मर आउटपुट को लगातार लोकल ऑप्टिमाइजेशन - कोविजिबिलिटी ग्राफ और विजुअल प्लेस रिकग्निशन के माध्यम से - के साथ मिलाकर ट्रैजेक्टरी को स्थिर करके एक पूर्ण SLAM सिस्टम में बदल देता है। VGGT-Align (अगस्त 2026) प्रत्येक चंक के पॉइंट क्लाउड से निकाले गए प्रमुख ज्यामितीय अपरिवर्तनीयताओं का उपयोग करके स्केल को सीमित करके लंबी अनुक्रमों पर चंक-दर-चंक स्केल ड्रिफ्ट की समस्या का समाधान करता है। Co-VGGT (जुलाई 2026) जैसे विश्लेषण कार्य भी सामने आए हैं, जिन्होंने दिखाया कि VGGT बिना किसी स्पष्ट पर्यवेक्षी संकेत के सह-दृश्यता (कौन से दृष्टिकोण एक ही क्षेत्र को साझा करते हैं) को अप्रत्यक्ष रूप से एन्कोड करता है - यह समझने का एक सक्रिय प्रयास है कि इन आधारभूत मॉडलों के आंतरिक निरूपण वास्तव में क्या कैप्चर करते हैं।
बेंचमार्क क्या दिखाते हैं: अधिक सटीक, लेकिन अचूक समाधान नहीं
2026 के उत्तरार्ध में आधारभूत मॉडल-आधारित SLAM के वास्तविक दुनिया के प्रदर्शन को मापने वाले अध्ययनों का एक समूह सामने आया। DJI ड्रोन से प्राप्त उच्च-ऊंचाई नादिर फुटेज पर पांच मोनोक्युलर SLAM प्रणालियों की तुलना करने वाले एक मूल्यांकन में पाया गया कि MASt3R-SLAM ने पथ लंबाई के 0.53% पर सबसे कम औसत क्षैतिज निरपेक्ष त्रुटि प्राप्त की, जबकि यह भी नोट किया गया कि ऊर्ध्वाधर (ऊंचाई) सटीकता अभी भी एक अनसुलझी समस्या बनी हुई है। कृत्रिम और वास्तविक दोनों प्रकार की त्रुटियों के तहत मोनोक्युलर SLAM का मूल्यांकन करने वाले एक अलग अध्ययन (अगस्त 2026) में पाया गया कि जहां पारंपरिक फीचर-आधारित विधियां खराब परिस्थितियों में "भयानक ट्रैकिंग विफलता" का शिकार होती हैं, वहीं लर्नड ट्रैकर्स इस भयानक विफलता को काफी हद तक "निरंतर, और कभी-कभी गंभीर, ड्रिफ्ट" से बदल देते हैं। दूसरे शब्दों में, लर्नड विधियां एक नाटकीय, स्पष्ट विफलता के स्थान पर एक शांत विफलता को अपना सकती हैं जहां त्रुटि का पता नहीं चलता - यह इस बात की याद दिलाता है कि केवल सटीकता मेट्रिक्स ही यह पूरी कहानी नहीं बताते कि वास्तव में कौन सा दृष्टिकोण बेहतर है।
स्केल अस्पष्टता - वह क्लासिक कमजोरी जहां केवल मोनोक्युलर फीड से निरपेक्ष दूरी स्केल प्राप्त नहीं किया जा सकता - के संबंध में भी नए दृष्टिकोण सामने आ रहे हैं। Scalix (अगस्त 2026), जो लर्नड डेप्थ प्रेडिक्शन को एक प्रोबेबिलिस्टिक फैक्टर ग्राफ में एकीकृत करता है, मीट्रिक (निरपेक्ष-स्केल) और अप-टू-स्केल (सापेक्ष-स्केल) दोनों बेंचमार्क पर अत्याधुनिक प्रदर्शन की रिपोर्ट करता है।
व्यावहारिक चयन मानदंड
वर्तमान में व्यावहारिक वर्गीकरण इस प्रकार है:
- संसाधन सीमित, सिद्ध ट्रैक रिकॉर्ड: ORB-SLAM3 परिवार में फीचर-पॉइंट आधारित विधियाँ — एम्बेडेड हार्डवेयर पर भी पर्याप्त वास्तविक ट्रैक रिकॉर्ड
- सटीकता को प्राथमिकता, पर्याप्त GPU संसाधन: DROID-SLAM परिवार में एंड-टू-एंड डीप-लर्निंग विधियाँ
- अपरिचित वातावरणों में सामान्यीकरण, अंशांकन की आवश्यकता नहीं: MASt3R-SLAM/VGGT परिवार में फीड-फॉरवर्ड 3D फाउंडेशन-मॉडल विधियाँ — हालांकि ऊर्ध्वाधर सटीकता और दीर्घकालिक संचालन में विचलन जैसी कुछ समस्याएँ अभी भी बनी हुई हैं
- फोटोरियलिस्टिक मानचित्र पुन: उपयोग की आवश्यकता: 3DGS/NeRF आधारित विधियाँ — हालांकि इनमें से कई अभी भी अनुसंधान चरण में हैं, और वास्तविक दुनिया में इनका उपयोग अभी भी विकसित हो रहा है
इनमें से कोई भी परिवार वास्तव में दूसरे का स्थान नहीं ले रहा है — वर्तमान वास्तविकता यह है कि वे उपयोग के मामलों के विभाजन में व्यवस्थित हो रहे हैं।
क्या अच्छे नॉवेल-व्यू रेंडरिंग से सही कैमरा पोज़ स्थापित होते हैं?
ज्यामिति और प्रक्षेपवक्र सटीकता से अलग रेंडरिंग गुणवत्ता का मापन करें।
दृश्य गुणवत्ता मात्र से स्थानीयकरण विधियों का निर्धारण नहीं किया जा सकता। ## संदर्भ - [ORB-SLAM3 GitHub (UZ-SLAMLab)](https://github.com/UZ-SLAMLab/ORB_SLAM3) - [DROID-SLAM GitHub (princeton-vl)](https://github.com/princeton-vl/DROID-SLAM) / [पेपर (arXiv)](https://arxiv.org/abs/2108.10869) - [NeRFs और 3D गॉसियन स्प्लैटिंग SLAM को कैसे नया रूप दे रहे हैं: एक सर्वेक्षण](https://www.semanticscholar.org/paper/How-NeRFs-and-3D-Gaussian-Splatting-are-Reshaping-a-Tosi-Zhang/d48aa5b757b4d05a697ed62484b4e7cd956e97e9) - [Splat-SLAM: 3D गॉसियन के साथ वैश्विक रूप से अनुकूलित RGB-ओनली SLAM (arXiv)](https://arxiv.org/pdf/2405.16544) - [awesome-NeRF-and-3DGS-SLAM (पेपर/कोड राउंडअप, GitHub)](https://github.com/3D-Vision-World/awesome-NeRF-and-3DGS-SLAM) - [MASt3R-SLAM: 3D पुनर्निर्माण प्रायर के साथ रियल-टाइम डेंस SLAM पर शोध पत्र (arXiv)](https://arxiv.org/abs/2412.12392) - [VGGT-Align पर शोध पत्र (arXiv)](https://arxiv.org/abs/2608.15260) - [Scalix: अनिश्चितता-जागरूक स्केल-संगत मोनोक्युलर SLAM पर शोध पत्र (arXiv)](https://arxiv.org/abs/2608.17553)
टिप्पणियाँ
पहले लॉग इन करें।
अभी कोई डेटा नहीं है।