Contents — find the section you need
Visual-SLAM adalah serangkaian teknik yang melakukan lokalisasi dan pemetaan mandiri hanya dengan mengandalkan rekaman kamera (atau kombinasi kamera dan IMU). Teknik ini tidak memerlukan sensor pengukur jarak yang mahal seperti LiDAR, tetapi memiliki kelemahan — sensitivitas terhadap perubahan pencahayaan dan adegan dengan tekstur yang kurang baik — dan sejarah mengatasi kelemahan tersebut pada dasarnya merupakan tren teknologi itu sendiri.
 OpenCV
Gambar: OpenCV logo, Wikimedia Commons (Apache 2.0)

Visual-SLAM Sekilas
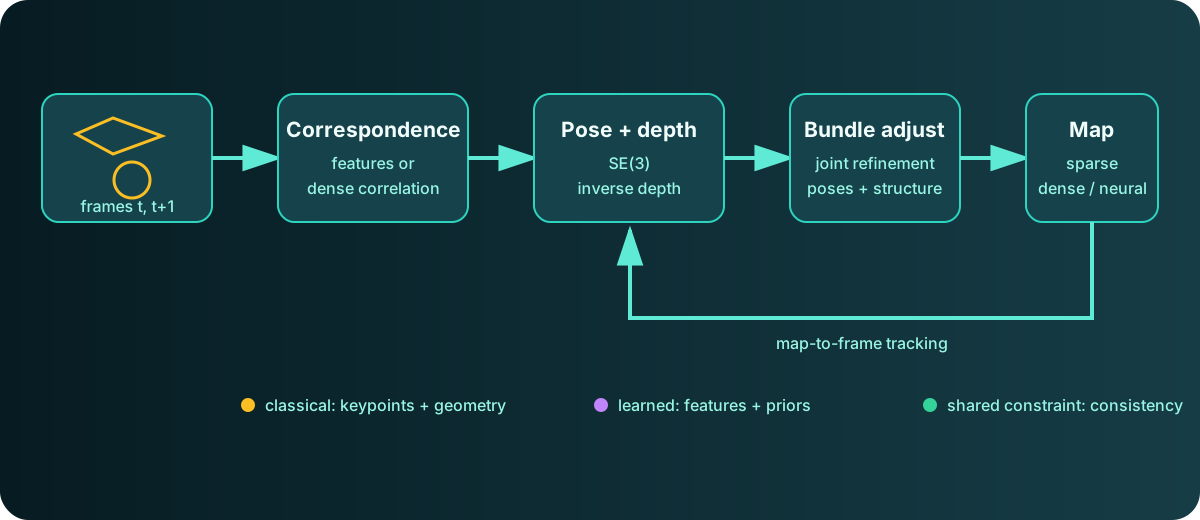
Diagram: Duskcoil. Ini menunjukkan hubungan geometris yang dimiliki oleh pendekatan klasik dan berbasis pembelajaran.
Masalah utama dalam Visual-SLAM adalah untuk mengaitkan tempat yang sama di seluruh frame dan secara bersamaan memulihkan gerakan kamera dan struktur 3D yang membuat asosiasi tersebut konsisten. Metode klasik secara eksplisit mencocokkan titik kunci yang jarang; metode berbasis pembelajaran menyimpulkan korespondensi dari fitur padat atau prioritas yang dipelajari. Keduanya tetap terikat oleh konsistensi observasi-pose-struktur. Apakah peta tersebut berupa awan titik yang jarang, kedalaman padat, atau representasi neural adalah pilihan praktis penting lainnya.
Titik Akhir Berbasis Titik Fitur: ORB-SLAM3
Salah satu titik akhir Visual-SLAM klasik adalah ORB-SLAM3. Ia dapat menjalankan Visual, Visual-Inertial, atau SLAM multi-peta secara real-time di seluruh pengaturan monokular, stereo, atau RGB-D, menemukan korespondensi antar gambar menggunakan deskriptor fitur yang disebut ORB, kemudian mengoptimalkan pose dan titik peta melalui penyesuaian bundel. Yang diminimalkan oleh penyesuaian bundel adalah jumlah ketidakcocokan (kesalahan reproyeksi) antara di mana titik peta 3D \mathbf{X}_i mendarat ketika diproyeksikan ke dalam gambar di bawah pose kamera (\mathbf{R}_j, \mathbf{t}_j), dan di mana titik fitur yang sesuai \mathbf{u}_{ij} sebenarnya diamati dalam gambar.
Di sini \pi(\cdot) adalah fungsi proyeksi dari titik 3D ke bidang gambar, berdasarkan parameter intrinsik kamera. Mengoptimalkan ekspresi ini secara bersamaan atas pose kamera dan titik peta adalah inti dari penyesuaian bundel, yang diselesaikan dalam kerangka kerja kuadrat terkecil nonlinier yang sama dengan optimasi grafik yang dibahas sebelumnya (lihat "Tren Teknologi dalam SLAM" untuk detailnya). Bertahun-tahun setelah dirilis, ia masih dikutip dalam makalah penelitian sebagai dasar perbandingan — implementasi referensi standar de facto.
End-to-End melalui Deep Learning: DROID-SLAM
Ada juga tren yang mapan untuk mengganti proses eksplisit ekstraksi dan pencocokan fitur dengan deep learning secara langsung. DROID-SLAM adalah contoh utama, memperkirakan pose kamera dan kedalaman per piksel melalui pembaruan iteratif berulang dan lapisan penyesuaian bundel yang padat. Meskipun hanya dilatih pada video monokular, ia cukup fleksibel untuk juga memanfaatkan video stereo atau RGB-D pada saat pengujian untuk akurasi yang lebih baik. Namun demikian, kebutuhan komputasinya lebih tinggi daripada metode klasik — inferensi saja membutuhkan memori GPU 11 GB atau lebih.
Di Dalam DROID-SLAM: Volume Korelasi dan Penyesuaian Bundel yang Dapat Didiferensiasi
Melihat lebih dekat bagaimana DROID-SLAM memperkirakan pose dan kedalaman tanpa melalui ekstraksi fitur eksplisit: pertama-tama ia menghitung peta fitur padat pada 1/8 resolusi input, menggunakan dua CNN — satu untuk ekstraksi fitur, satu untuk informasi kontekstual. Untuk setiap pasangan frame, ia membangun "volume korelasi 4D" dengan menghitung secara menyeluruh hasil perkalian titik antara setiap pasangan vektor fitur, yang menjadi dasar untuk memperkirakan korespondensi piksel demi piksel.
Estimasi itu sendiri ditangani oleh operator pembaruan iteratif. Fitur-fitur dari volume korelasi, bersama dengan residual (koreksi) dari iterasi sebelumnya, melewati lapisan konvolusional dan masuk ke ConvGRU (unit rekuren gerbang konvolusional), yang menghasilkan koreksi pada aliran (gerakan tampak). Mekanisme gerbang — yang memungkinkan jaringan untuk secara selektif mengontrol informasi apa yang akan dimasukkan dan apa yang akan dibuang — adalah bagian yang sebenarnya telah dipelajari oleh jaringan ini.
Output dari pembaruan iteratif ini masuk ke lapisan Dense Bundle Adjustment (DBA) yang dapat dibedakan yang memperbarui pose kamera dan kedalaman invers per piksel secara bersamaan. Dengan memasukkan batasan geometris secara eksplisit ke dalam jaringan dengan cara ini, bahkan model yang dilatih secara monokular pun memiliki fleksibilitas untuk menangani input stereo atau RGB-D tanpa pelatihan ulang.
Menemukan Kembali Representasi Peta: 3D Gaussian Splatting dan NeRF
Area yang paling cepat berkembang saat ini adalah penemuan kembali format representasi peta itu sendiri. Neural Radiance Fields (NeRF) dan 3D Gaussian Splatting (3DGS) dapat merepresentasikan adegan 3D fotorealistik sebagai kumpulan parameter yang ringkas, bukan sekadar awan titik biasa. Sifat ini secara konsisten meningkatkan akurasi pemetaan, kualitas rendering, dan efisiensi komputasi SLAM sekaligus.
Hingga tahun 2026, sejumlah metode berbasis 3DGS/NeRF baru terus bermunculan di konferensi dan jurnal utama: Splat-SLAM, yang melakukan optimasi global hanya dari video RGB; Gaussian-LIC/Gaussian-LIC2, yang menggabungkan LiDAR, IMU, dan kamera; GTS-SLAM, yang ditujukan untuk lingkungan yang keras seperti tambang bawah tanah; MTE-SLAM (ICRA 2026), yang berorientasi pada SLAM semantik; dan PMET-SLAM, yang menyeimbangkan pemetaan fotorealistik dengan pelacakan yang efisien. Dibandingkan dengan metode tradisional, kualitas rendering dan kemampuan penggunaan kembali peta (kemampuan untuk merender ulang lingkungan dari sudut pandang sembarang setelahnya) disebut sebagai kekuatan yang jelas.
Tren Terkini 2025-2026: SLAM yang Dibangun di Atas Model Dasar 3D Feed-Forward
Mengembangkan desain DROID-SLAM — estimasi iteratif ditambah penyesuaian bundel yang dapat dibedakan — lebih jauh lagi, MASt3R-SLAM (makalah unggulan CVPR 2025), yang muncul pada akhir tahun 2024, memperlakukan output MASt3R — model dasar yang telah dilatih sebelumnya pada rekonstruksi dan korespondensi 3D dua pandangan — sebagai "pengetahuan awal." Ia menangani pencocokan peta titik, pelacakan kamera, fusi peta lokal, dan deteksi penutupan loop dalam satu kerangka kerja bahkan ketika intrinsik kamera tidak diketahui, berjalan pada 15 FPS dengan model kamera yang diketahui dan dilaporkan mencapai akurasi terbaik di berbagai benchmark.
Garis model dasar ini semakin mendapatkan momentum dengan hadirnya VGGT (Visual Geometry Grounded Transformer) pada tahun 2025 — sebuah model dasar 3D feed-forward yang menghasilkan pose kamera, kedalaman, dan point cloud secara simultan dari gambar multi-view dalam satu kali proses maju. Gelombang penelitian turunan yang dibangun di atas output VGGT telah berlanjut hingga tahun 2026. VGGT-SLAM++ (April 2026) mengubah output transformer VGGT menjadi sistem SLAM lengkap dengan menggabungkannya dengan optimasi lokal yang sering dilakukan — melalui grafik kovisibilitas dan pengenalan tempat visual — untuk menstabilkan lintasan. VGGT-Align (Agustus 2026) menyelesaikan pergeseran skala antar-chunk pada urutan panjang dengan membatasi skala menggunakan invarian geometris dominan yang diekstrak dari point cloud setiap chunk. Analisis juga telah muncul, seperti Co-VGGT (Juli 2026), yang menunjukkan bahwa VGGT secara implisit mengkodekan kovisibilitas (sudut pandang mana yang berbagi wilayah yang sama) tanpa sinyal pengawasan eksplisit apa pun — upaya aktif untuk memahami apa yang sebenarnya ditangkap oleh representasi internal model dasar ini.
Apa yang Ditunjukkan oleh Tolok Ukur: Lebih Akurat, Tetapi Bukan Solusi Ampuh
Sejumlah studi yang mengukur kinerja dunia nyata SLAM berbasis model dasar muncul pada paruh kedua tahun 2026. Evaluasi yang membandingkan lima sistem SLAM monokular pada rekaman nadir ketinggian tinggi dari drone DJI menemukan bahwa MASt3R-SLAM mencapai kesalahan absolut horizontal rata-rata terendah pada 0,53% dari panjang lintasan, sementara mencatat bahwa akurasi vertikal (ketinggian) tetap menjadi masalah yang belum terselesaikan. Sebuah studi terpisah (Agustus 2026) yang mengevaluasi SLAM monokular di bawah gangguan sintetis dan dunia nyata menemukan bahwa sementara metode berbasis fitur klasik cenderung mengalami "kegagalan pelacakan yang dahsyat" di bawah kondisi yang terdegradasi, pelacak yang dipelajari sebagian besar hanya mengganti kegagalan dahsyat tersebut dengan "pergeseran yang berkelanjutan, dan terkadang parah." Dengan kata lain, metode yang dipelajari dapat menukar mode kegagalan yang dramatis dan terlihat dengan mode yang lebih tenang di mana kesalahan terakumulasi tanpa disadari — sebuah pengingat bahwa metrik akurasi saja tidak menceritakan keseluruhan cerita tentang pendekatan mana yang sebenarnya lebih baik.
Pada ambiguitas skala — kelemahan klasik di mana umpan monokular saja tidak dapat memulihkan skala jarak absolut — pendekatan baru juga muncul. Scalix (Agustus 2026), yang mengintegrasikan prediksi kedalaman yang dipelajari ke dalam grafik faktor probabilistik, melaporkan kinerja terbaik pada tolok ukur metrik (skala absolut) dan hingga skala (skala relatif).
Kriteria Seleksi Praktis
Rincian praktis saat ini adalah sebagai berikut:
- Keterbatasan sumber daya, rekam jejak terbukti: metode berbasis titik fitur dalam keluarga ORB-SLAM3 — banyak rekam jejak di dunia nyata bahkan pada perangkat keras tertanam
- Akurasi utama, sumber daya GPU yang melimpah: metode pembelajaran mendalam ujung-ke-ujung dalam keluarga DROID-SLAM
- Generalisasi ke lingkungan yang tidak dikenal, tidak memerlukan kalibrasi: metode model dasar 3D umpan maju dalam keluarga MASt3R-SLAM/VGGT — meskipun masih ada masalah yang belum terselesaikan, seperti akurasi vertikal dan pergeseran selama operasi jangka panjang
- Penggunaan kembali peta fotorealistik diperlukan: metode berbasis 3DGS/NeRF — meskipun banyak yang masih dalam tahap penelitian, dan penerapan di dunia nyata masih berkembang
Tidak satu pun dari keluarga ini yang benar-benar menggantikan yang lain — realitas saat ini adalah bahwa mereka mulai terbagi berdasarkan kasus penggunaan.
Apakah rendering tampilan novel yang baik menghasilkan pose kamera yang benar?
Ukur kualitas rendering secara terpisah dari akurasi geometri dan lintasan.
Kualitas visual saja tidak dapat menentukan peringkat metode lokalisasi.Referensi
- ORB-SLAM3 GitHub (UZ-SLAMLab)
- DROID-SLAM GitHub (princeton-vl) / Makalah (arXiv)
- Bagaimana NeRF dan 3D Gaussian Splatting Membentuk Ulang SLAM: Sebuah Survei
- Splat-SLAM: SLAM RGB-only yang Dioptimalkan Secara Global dengan Gaussian 3D (arXiv)
- awesome-NeRF-and-3DGS-SLAM (kumpulan makalah/kode, GitHub)
- [MASt3R-SLAM: Makalah Real-Time Dense SLAM dengan Prior Rekonstruksi 3D (arXiv)
- Makalah VGGT-Align (arXiv)
- Makalah Scalix: Uncertainty-Aware Scale-Consistent Monocular SLAM (arXiv)
Komentar
Silakan masuk terlebih dahulu.
Belum ada data.