Contents — find the section you need
Visual-SLAM ist eine Gruppe von Verfahren, die Selbstlokalisierung und Kartierung allein anhand von Kameraaufnahmen (oder einer Kombination aus Kamera und IMU) durchführen. Es benötigt keinen teuren Entfernungsmesser wie LiDAR, weist aber eine Schwäche auf: die Empfindlichkeit gegenüber Lichtveränderungen und texturarmen Szenen. Die Geschichte der Überwindung dieser Schwäche ist im Wesentlichen der technologische Trend selbst.
Visual-SLAM ist eine Familie von Verfahren, die Selbstlokalisierung und Kartierung allein anhand von Kameraaufnahmen (oder einer Kombination aus Kamera und IMU) ermöglichen.
 OpenCV
Bild: OpenCV logo, Wikimedia Commons (Apache 2.0)

Visual-SLAM auf einen Blick
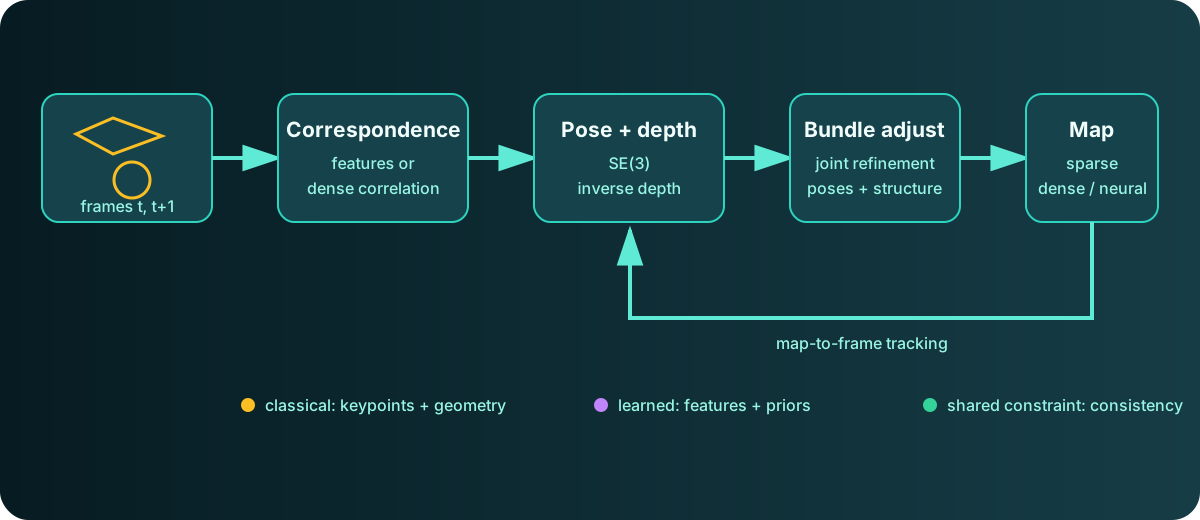
Diagramm: Duskcoil. Es zeigt die geometrischen Beziehungen, die klassischen und lernbasierten Ansätzen gemeinsam sind.
Das zentrale Problem von Visual-SLAM besteht darin, denselben Ort über Frames hinweg zuzuordnen und Kamerabewegung und 3D-Struktur gemeinsam zu rekonstruieren, die diese Zuordnungen konsistent machen. Klassische Methoden ordnen spärliche Schlüsselpunkte explizit zu; lernbasierte Methoden leiten Korrespondenzen aus dichten Merkmalen oder gelernten Vorinformationen ab. Beide unterliegen der Konsistenz von Beobachtung, Pose und Struktur. Ob die Karte eine spärliche Punktwolke, dichte Tiefeninformationen oder eine neuronale Repräsentation darstellt, ist eine weitere wichtige praktische Entscheidung.
Der merkmalspunktbasierte Endpunkt: ORB-SLAM3
Ein Endpunkt des klassischen Visual-SLAM ist ORB-SLAM3. Es kann Visual-, Visual-Inertial- oder Multi-Map-SLAM in Echtzeit auf monokularen, Stereo- oder RGB-D-Systemen ausführen, indem es Korrespondenzen zwischen Bildern mithilfe eines Merkmalsdeskriptors namens ORB findet und anschließend Pose und Kartenpunkte durch Bündelausgleich optimiert. Die Bündelausgleichung minimiert die Summe der Abweichungen (Reprojektionsfehler) zwischen der Position eines 3D-Kartenpunkts \mathbf{X}_i, der unter der Kameraposition (\mathbf{R}_j, \mathbf{t}_j) in das Bild projiziert wird, und der tatsächlichen Position des entsprechenden Merkmalspunkts \mathbf{u}_{ij} im Bild.
Dabei ist \pi(\cdot) die Projektionsfunktion von einem 3D-Punkt auf die Bildebene, basierend auf den intrinsischen Kameraparametern. Die gemeinsame Optimierung dieses Ausdrucks hinsichtlich Kameraposition und Kartenpunkten ist das Wesen der Bündelausgleichung. Sie wird im selben nichtlinearen Kleinste-Quadrate-Verfahren gelöst wie die zuvor beschriebene Graphoptimierung (siehe „Technology Trends in SLAM“ für Details). Jahre nach ihrer Veröffentlichung wird sie in Forschungsarbeiten immer noch als Vergleichsbasis zitiert – die faktische Standardreferenzimplementierung.
End-to-End via Deep Learning: DROID-SLAM
Es gibt einen etablierten Trend, die explizite Merkmalsextraktion und das Feature-Matching vollständig durch Deep Learning zu ersetzen. DROID-SLAM ist das führende Beispiel dafür. Es schätzt die Kamerapose und die Tiefe pro Pixel durch rekurrente iterative Aktualisierungen und eine dichte Bundle-Adjustment-Schicht. Obwohl es nur mit monokularen Videos trainiert wurde, ist es flexibel genug, um zur Testzeit auch Stereo- oder RGB-D-Videos für eine höhere Genauigkeit zu nutzen. Allerdings ist der Rechenaufwand höher als bei klassischen Methoden – allein die Inferenz benötigt 11 GB oder mehr GPU-Speicher.
DROID-SLAM im Detail: Korrelationsvolumina und differenzierbare Bundle Adjustment
DROID-SLAM schätzt Pose und Tiefe genauer, ohne explizite Merkmalsextraktion durchzuführen: Zunächst berechnet es dichte Feature-Maps mit 1/8 der Eingangsauflösung mithilfe zweier CNNs – eines für die Merkmalsextraktion, das andere für Kontextinformationen. Für jedes Bildpaar wird ein „4D-Korrelationsvolumen“ erstellt, indem das Skalarprodukt zwischen allen Paaren von Merkmalsvektoren vollständig berechnet wird. Dies bildet die Grundlage für die Schätzung der pixelweisen Korrespondenz.
Die Schätzung selbst erfolgt durch einen iterativen Aktualisierungsoperator. Merkmale aus dem Korrelationsvolumen werden zusammen mit dem Residuum (der Korrektur) der vorherigen Iteration durch Faltungsschichten und an eine ConvGRU (eine Convolutional Gated Recurrent Unit) weitergeleitet, die eine Korrektur der Bewegungsrichtung (scheinbare Bewegung) ausgibt. Der Gating-Mechanismus – der es dem Netzwerk ermöglicht, selektiv zu steuern, welche Informationen einbezogen und welche verworfen werden – ist der Teil, den dieses Netzwerk tatsächlich gelernt hat.
Die Ausgabe dieser iterativen Aktualisierung wird in eine differenzierbare Dense Bundle Adjustment (DBA)-Schicht eingespeist, die die Kamerapose und die inverse Tiefe pro Pixel gleichzeitig aktualisiert. Durch das explizite Einbetten geometrischer Beschränkungen in das Netzwerk erhält selbst ein monokular trainiertes Modell die Flexibilität, Stereo- oder RGB-D-Eingaben ohne erneutes Training zu verarbeiten.
Kartendarstellung revolutionieren: 3D Gaussian Splatting und NeRF
Derzeit entwickelt sich die Kartendarstellung selbst rasant weiter. Neural Radiance Fields (NeRF) und 3D Gaussian Splatting (3DGS) ermöglichen die Darstellung fotorealistischer 3D-Szenen als kompakten Parametersatz anstelle einer einfachen Punktwolke. Diese Eigenschaft verbessert kontinuierlich die Genauigkeit der SLAM-Kartierung, die Rendering-Qualität und die Recheneffizienz.
Bis 2026 wurden auf wichtigen Konferenzen und in Fachzeitschriften immer wieder neue 3DGS/NeRF-basierte Methoden vorgestellt: Splat-SLAM, das allein auf RGB-Videodaten basiert; Gaussian-LIC/Gaussian-LIC2, die LiDAR, IMU und Kameradaten kombinieren; GTS-SLAM, speziell für anspruchsvolle Umgebungen wie Untertagebergwerke; und MTE-SLAM (ICRA 2026), das auf semantisches SLAM ausgerichtet ist. und PMET-SLAM, das fotorealistische Kartierung mit effizientem Tracking kombiniert. Im Vergleich zu traditionellen Methoden werden die hohe Rendering-Qualität und die Wiederverwendbarkeit der Karten (die Möglichkeit, die Umgebung nachträglich aus einem beliebigen Blickwinkel neu zu rendern) als klare Stärken genannt.
Aktueller Stand 2025–2026: SLAM basierend auf Feedforward-3D-Fundamentmodellen
MASt3R-SLAM (ein Highlight-Paper der CVPR 2025), das Ende 2024 erschien, baut auf dem Design von DROID-SLAM auf – iterative Schätzung plus differenzierbare Bündelausgleichung – und nutzt die Ausgabe von MASt3R – einem auf Zwei-Ansichten-3D-Rekonstruktion und Korrespondenz vortrainierten Fundamentmodell – als „Vorwissen“. Es bewältigt Punktkartenabgleich, Kamera-Tracking, lokale Kartenfusion und Schleifenschlusserkennung in einem einzigen Framework, selbst wenn die Kameraparameter unbekannt sind. Mit bekannten Kameramodellen erreicht es 15 FPS und erzielt Berichten zufolge in mehreren Benchmarks höchste Genauigkeit.
Diese Entwicklung im Bereich der Grundlagenmodelle gewann mit der Einführung von VGGT (Visual Geometry Grounded Transformer) im Jahr 2025 weiter an Dynamik. VGGT ist ein Feedforward-3D-Grundlagenmodell, das Kameraposition, Tiefe und Punktwolken gleichzeitig aus Mehransichtsbildern in einem einzigen Vorwärtsdurchlauf ausgibt. Auf den Ergebnissen von VGGT aufbauend, folgte bis 2026 eine Welle von Folgeforschungen. VGGT-SLAM++ (April 2026) erweitert die Transformatorausgabe von VGGT zu einem vollständigen SLAM-System, indem es sie mit häufiger lokaler Optimierung – mittels Kovisibilitätsgraphen und visueller Ortserkennung – kombiniert, um Trajektorien zu stabilisieren. VGGT-Align (August 2026) behebt Skalierungsdrift zwischen einzelnen Chunks über lange Sequenzen, indem es die Skalierung mithilfe dominanter geometrischer Invarianten beschränkt, die aus der Punktwolke jedes Chunks extrahiert werden. Es sind auch Analysen entstanden, wie beispielsweise Co-VGGT (Juli 2026). Diese zeigten, dass VGGT die gemeinsame Sichtbarkeit (welche Blickpunkte denselben Bereich teilen) implizit ohne explizites Steuerungssignal kodiert – ein aktiver Versuch, zu verstehen, was die internen Repräsentationen dieser Basismodelle tatsächlich erfassen.
Was die Benchmarks zeigen: Höhere Genauigkeit, aber keine Wunderlösung
In der zweiten Jahreshälfte 2026 erschien eine Reihe von Studien, die die Leistung von SLAM-Systemen auf Basis von Basismodellen in der Praxis quantifizierten. Eine Evaluierung, die fünf monokulare SLAM-Systeme anhand von Nadir-Aufnahmen aus großer Höhe von DJI-Drohnen verglich, ergab, dass MASt3R-SLAM mit 0,53 % der Pfadlänge den niedrigsten mittleren horizontalen absoluten Fehler erzielte. Gleichzeitig wurde festgestellt, dass die vertikale Genauigkeit (Höhengenauigkeit) weiterhin ein ungelöstes Problem darstellt. Eine separate Studie (August 2026), die monokulares SLAM unter synthetischen und realen Störungen untersuchte, ergab, dass klassische, merkmalsbasierte Methoden unter solchen Bedingungen häufig zu einem „katastrophalen Tracking-Versagen“ neigen, während gelernte Tracker dieses Versagen größtenteils durch „anhaltendes und mitunter starkes Driften“ ersetzen. Anders ausgedrückt: Gelernte Methoden tauschen ein dramatisches, sichtbares Versagen gegen ein unauffälligeres ein, bei dem sich Fehler unbemerkt anhäufen – ein Hinweis darauf, dass Genauigkeitsmetriken allein nicht die ganze Wahrheit darüber aussagen, welcher Ansatz tatsächlich besser ist.
Auch im Hinblick auf die Skalenmehrdeutigkeit – die klassische Schwäche, bei der ein monokulares Bild allein die absolute Entfernungsskala nicht rekonstruieren kann – zeichnen sich neue Ansätze ab. Scalix (August 2026), das gelernte Tiefenvorhersagen in einen probabilistischen Faktorgraphen integriert, erzielt Bestleistungen sowohl bei metrischen (absoluten) als auch bei relativen (relativen) Benchmarks.
Praktische Auswahlkriterien
Die praktische Aufschlüsselung sieht derzeit wie folgt aus:
- Ressourcenbeschränkt, bewährte Leistung: Feature-Point-basierte Methoden der ORB-SLAM3-Familie – umfangreiche Praxiserfahrung, auch auf eingebetteter Hardware
- Höchste Genauigkeit, ausreichend GPU-Ressourcen: End-to-End-Deep-Learning-Methoden der DROID-SLAM-Familie
- Generalisierung auf unbekannte Umgebungen, keine Kalibrierung erforderlich: Feedforward-3D-Foundation-Model-Methoden der MASt3R-SLAM/VGGT-Familie – allerdings bestehen weiterhin offene Probleme, wie z. B. die vertikale Genauigkeit und Drift im Langzeitbetrieb
- Wiederverwendung fotorealistischer Karten erforderlich: 3DGS/NeRF-basierte Methoden – viele befinden sich jedoch noch im Forschungsstadium, und der Einsatz in der Praxis ist noch in der Entwicklung
Keine dieser Familien ersetzt die anderen vollständig – vielmehr differenzieren sie sich in unterschiedliche Anwendungsfälle.
Sorgt gutes Rendering neuer Ansichten für korrekte Kamerapositionen?
Die Renderingqualität sollte unabhängig von Geometrie- und Trajektoriengenauigkeit gemessen werden. Die visuelle Qualität allein reicht nicht aus, um Lokalisierungsmethoden zu bewerten.
## Referenzen - [ORB-SLAM3 GitHub (UZ-SLAMLab)](https://github.com/UZ-SLAMLab/ORB_SLAM3) - [DROID-SLAM GitHub (princeton-vl)](https://github.com/princeton-vl/DROID-SLAM) / [Paper (arXiv)](https://arxiv.org/abs/2108.10869) - [Wie NeRFs und 3D-Gaussian-Splatting SLAM verändern: Eine Übersicht](https://www.semanticscholar.org/paper/How-NeRFs-and-3D-Gaussian-Splatting-are-Reshaping-a-Tosi-Zhang/d48aa5b757b4d05a697ed62484b4e7cd956e97e9) - [Splat-SLAM: Global optimiertes RGB-only SLAM mit 3D-Gaussians (arXiv)](https://arxiv.org/pdf/2405.16544) - [awesome-NeRF-and-3DGS-SLAM (Paper/Code-Übersicht, GitHub)](https://github.com/3D-Vision-World/awesome-NeRF-and-3DGS-SLAM) - [MASt3R-SLAM: Echtzeitfähiges dichtes SLAM mit 3D-Rekonstruktions-Priors (arXiv)](https://arxiv.org/abs/2412.12392) - [VGGT-Align (arXiv)](https://arxiv.org/abs/2608.15260) - [Scalix: Unsicherheitsbewusstes, skalierungskonsistentes monokulares SLAM (arXiv)](https://arxiv.org/abs/2608.17553)
Kommentare
Bitte zuerst anmelden.
Noch keine Einträge.