Contents — find the section you need
Le Visual-SLAM regroupe les techniques d'auto-localisation et de cartographie réalisées à partir d'images de caméra (ou d'une combinaison caméra-IMU). Contrairement au LiDAR, qui nécessite un capteur de télémétrie coûteux, le Visual-SLAM présente une faiblesse : sa sensibilité aux variations de luminosité et aux scènes pauvres en textures. L'évolution de cette technologie repose essentiellement sur la recherche de solutions pour pallier cette faiblesse.
 OpenCV
Image : OpenCV logo, Wikimedia Commons (Apache 2.0)

Aperçu du Visual-SLAM
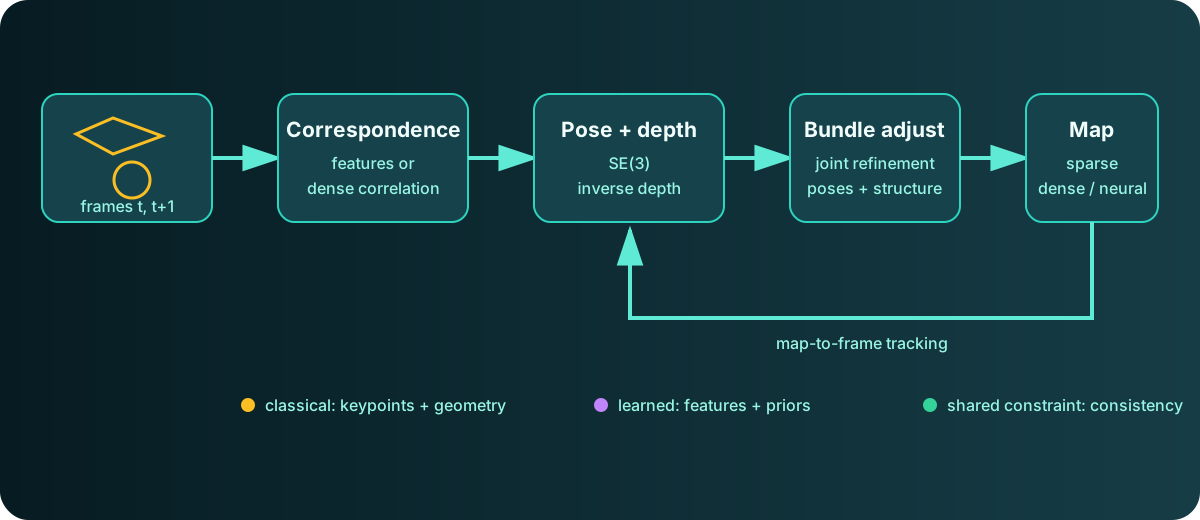
Diagramme : Duskcoil. Il illustre les relations géométriques communes aux approches classiques et basées sur l'apprentissage.
Le problème central du Visual-SLAM est d'associer un même lieu entre les images et de reconstruire conjointement le mouvement de la caméra et la structure 3D afin de garantir la cohérence de ces associations. Les méthodes classiques font correspondre explicitement des points clés épars ; les méthodes d'apprentissage infèrent la correspondance à partir de caractéristiques denses ou de connaissances a priori. Les deux restent soumises à la cohérence observation-pose-structure. Le choix entre un nuage de points épars, une image de profondeur dense ou une représentation neuronale constitue un autre choix pratique important.
Le point d'accès basé sur les points caractéristiques : ORB-SLAM3
L'un des points d'accès du SLAM visuel classique est ORB-SLAM3. Il peut exécuter du SLAM visuel, visuel-inertiel ou multi-cartes en temps réel sur des configurations monoculaires, stéréoscopiques ou RGB-D, en trouvant la correspondance entre les images à l'aide d'un descripteur de caractéristiques appelé ORB, puis en optimisant la pose et les points de la carte par ajustement de faisceaux. L'ajustement de faisceaux minimise la somme des erreurs de reprojection (écart) entre la position d'un point 3D de la carte (\mathbf{X}_i) projeté sur l'image selon la pose de la caméra ((\mathbf{R}_j, \mathbf{t}_j)) et la position réelle du point caractéristique correspondant (\mathbf{u}_{ij}) sur l'image.
Ici, \pi(\cdot) représente la fonction de projection d'un point 3D sur le plan image, basée sur les paramètres intrinsèques de la caméra. L'optimisation conjointe de cette expression, prenant en compte à la fois la pose de la caméra et les points de la carte, constitue l'essence de l'ajustement de faisceaux. Cette optimisation est réalisée dans le même cadre de moindres carrés non linéaires que l'optimisation de graphes présentée précédemment (voir « Tendances technologiques en SLAM » pour plus de détails). Des années après sa publication, elle reste une référence dans les articles de recherche, servant de base de comparaison et constituant l'implémentation de référence standard de facto.
De bout en bout via l'apprentissage profond : DROID-SLAM
Il existe une tendance bien établie consistant à remplacer le processus explicite d'extraction et de mise en correspondance de caractéristiques par l'apprentissage profond. DROID-SLAM en est le principal exemple : il estime la pose de la caméra et la profondeur par pixel grâce à des mises à jour itératives récurrentes et une couche dense d'ajustement de faisceaux. Bien qu'entraîné uniquement sur de la vidéo monoculaire, il est suffisamment flexible pour exploiter également la vidéo stéréo ou RGB-D lors des tests afin d'améliorer la précision. Cependant, ses exigences de calcul sont plus élevées que celles des méthodes classiques : l'inférence à elle seule nécessite 11 Go ou plus de mémoire GPU.
Au cœur de DROID-SLAM : Volumes de corrélation et ajustement de faisceaux différentiable
Examinons de plus près comment DROID-SLAM estime la pose et la profondeur sans extraction explicite de caractéristiques : il calcule d'abord des cartes de caractéristiques denses à 1/8 de la résolution d'entrée, à l'aide de deux CNN : l'un pour l'extraction de caractéristiques, l'autre pour les informations contextuelles. Pour chaque paire d'images, un « volume de corrélation 4D » est construit en calculant exhaustivement le produit scalaire de chaque paire de vecteurs de caractéristiques. Ce volume sert de base à l'estimation de la correspondance pixel par pixel.
L'estimation est gérée par un opérateur de mise à jour itératif. Les caractéristiques issues du volume de corrélation, combinées au résidu (correction) de l'itération précédente, sont traitées par des couches convolutionnelles puis intégrées à une ConvGRU (unité récurrente convolutionnelle à porte), qui corrige le flux (mouvement apparent). Le mécanisme de sélection des informations, permettant au réseau de les intégrer et de les ignorer, est la partie apprise par ce réseau.
La sortie de cette mise à jour itérative alimente une couche d'ajustement de faisceaux denses différentiable (DBA) qui met à jour simultanément la pose de la caméra et la profondeur inverse par pixel. L'intégration explicite des contraintes géométriques au sein du réseau confère à un modèle entraîné en vision monoculaire la flexibilité nécessaire pour traiter des entrées stéréo ou RGB-D sans réentraînement.
Réinventer la représentation cartographique : 3D Gaussian Splatting et NeRF
Le domaine le plus dynamique actuellement est la réinvention du format de représentation cartographique lui-même. Les champs de radiance neuronaux (NeRF) et le 3D Gaussian Splatting (3DGS) permettent de représenter une scène 3D photoréaliste sous la forme d'un ensemble compact de paramètres, plutôt que d'un simple nuage de points. Cette propriété améliore constamment la précision de la cartographie, la qualité de rendu et l'efficacité de calcul du SLAM.
Jusqu'en 2026, de nombreuses nouvelles méthodes basées sur 3DGS/NeRF ont continué d'être présentées lors de conférences et dans des revues scientifiques majeures : Splat-SLAM, qui effectue une optimisation globale à partir de la seule vidéo RGB ; Gaussian-LIC/Gaussian-LIC2, qui fusionnent les données LiDAR, IMU et caméra ; GTS-SLAM, destiné aux environnements difficiles comme les mines souterraines ; et MTE-SLAM (ICRA 2026), orienté vers le SLAM sémantique. et PMET-SLAM, qui allie cartographie photoréaliste et suivi efficace. Comparé aux méthodes traditionnelles, la qualité de rendu et la réutilisabilité des cartes (la possibilité de redessiner l'environnement depuis un point de vue arbitraire a posteriori) sont citées comme des atouts majeurs.
Les tendances 2025-2026 : SLAM basé sur des modèles 3D à propagation directe
Pousser le concept de DROID-SLAM (estimation itérative et ajustement de faisceaux différentiable) un cran plus loin : MASt3R-SLAM (article phare de CVPR 2025), paru fin 2024, considère la sortie de MASt3R (un modèle de base pré-entraîné sur la reconstruction et la correspondance 3D à deux vues) comme une « connaissance a priori ». Il gère la mise en correspondance des cartes de points, le suivi de la caméra, la fusion de cartes locales et la détection de boucles de fermeture au sein d'un cadre unique, même lorsque les paramètres intrinsèques de la caméra sont inconnus. Il fonctionne à 15 images par seconde avec des modèles de caméra connus et atteint, selon les informations disponibles, une précision de pointe sur de nombreux benchmarks.
Cette lignée de modèles de base a pris un nouvel essor avec l'arrivée en 2025 de VGGT (Visual Geometry Grounded Transformer), un modèle de base 3D à propagation directe qui génère simultanément la pose de la caméra, la profondeur et les nuages de points à partir d'images multivues en une seule passe. Une vague de recherches dérivées, s'appuyant sur les résultats de VGGT, s'est poursuivie jusqu'en 2026. VGGT-SLAM++ (avril 2026) transforme les résultats du transformateur VGGT en un système SLAM complet en les combinant à une optimisation locale fréquente – via des graphes de covisibilité et la reconnaissance visuelle des lieux – afin de stabiliser les trajectoires. VGGT-Align (août 2026) résout le problème de la dérive d'échelle entre les segments sur de longues séquences en contraignant l'échelle à l'aide d'invariants géométriques dominants extraits du nuage de points de chaque segment. Des travaux d'analyse ont également émergé, tels que Co-VGGT (juillet 2026), qui a démontré que VGGT encode implicitement la covisibilité (les points de vue partageant la même région) sans signal de supervision explicite – un effort actif pour comprendre ce que les représentations internes de ces modèles de base capturent réellement.
Ce que montrent les benchmarks : Plus précis, mais pas de solution miracle
Un ensemble d'études quantifiant les performances réelles du SLAM basé sur un modèle de base est apparu au cours du second semestre 2026. Une évaluation comparant cinq systèmes SLAM monoculaires sur des images nadir haute altitude de drones DJI a révélé que MASt3R-SLAM atteignait l'erreur absolue horizontale moyenne la plus faible, à 0,53 % de la longueur du trajet, tout en notant que la précision verticale (altitude) reste un problème ouvert. Une étude distincte (août 2026) évaluant le SLAM monoculaire en présence de corruptions synthétiques et réelles a révélé que, tandis que les méthodes classiques basées sur les caractéristiques ont tendance à subir une « défaillance catastrophique du suivi » en conditions dégradées, les systèmes de suivi appris remplacent généralement cette défaillance catastrophique par une « dérive soutenue, parfois importante ». Autrement dit, les méthodes apprises peuvent troquer un mode de défaillance spectaculaire et visible contre un mode plus discret où l'erreur s'accumule sans être détectée ; ceci nous rappelle que les mesures de précision, à elles seules, ne permettent pas de déterminer avec certitude quelle approche est réellement la meilleure.
Concernant l'ambiguïté d'échelle – la faiblesse classique qui empêche un flux monoculaire de reconstituer l'échelle de distance absolue – de nouvelles approches émergent également. Scalix (août 2026), qui intègre la prédiction de profondeur apprise dans un graphe de facteurs probabilistes, affiche des performances de pointe sur les benchmarks métriques (échelle absolue) et d'échelle relative.
Critères de sélection pratiques
À ce stade, la répartition pratique est la suivante :
-
Ressources limitées, performances éprouvées : méthodes basées sur les points caractéristiques de la famille ORB-SLAM3 – largement éprouvées en conditions réelles, même sur du matériel embarqué.
-
Priorité à la précision, ressources GPU importantes : méthodes d’apprentissage profond de bout en bout de la famille DROID-SLAM.
-
Généralisation à des environnements inconnus, aucun étalonnage requis : méthodes de modélisation 3D à propagation directe de la famille MASt3R-SLAM/VGGT – malgré quelques problèmes persistants, tels que la précision verticale et la dérive lors d’opérations de longue durée.
-
Nécessité de réutiliser des cartes photoréalistes : méthodes basées sur 3DGS/NeRF – bien que nombre d’entre elles soient encore au stade de la recherche et que leur déploiement en conditions réelles soit encore en développement.
Aucune de ces familles ne remplace véritablement les autres ; la réalité actuelle est qu’elles se répartissent progressivement selon des cas d’utilisation spécifiques.
Un bon rendu de nouvelles vues permet-il d'établir des poses de caméra correctes ?
Mesurez la qualité du rendu indépendamment de la précision de la géométrie et de la trajectoire. La qualité visuelle seule ne permet pas de classer les méthodes de localisation.
## Références - [ORB-SLAM3 GitHub (UZ-SLAMLab)](https://github.com/UZ-SLAMLab/ORB_SLAM3) - [DROID-SLAM GitHub (princeton-vl)](https://github.com/princeton-vl/DROID-SLAM) / [Article (arXiv)](https://arxiv.org/abs/2108.10869) - [Comment les NeRF et le splatting gaussien 3D transforment le SLAM : une étude](https://www.semanticscholar.org/paper/How-NeRFs-and-3D-Gaussian-Splatting-are-Reshaping-a-Tosi-Zhang/d48aa5b757b4d05a697ed62484b4e7cd956e97e9) - [Splat-SLAM : SLAM RGB optimisé globalement avec des gaussiennes 3D (arXiv)](https://arxiv.org/pdf/2405.16544) - [awesome-NeRF-and-3DGS-SLAM (récapitulatif d'articles et de codes, GitHub)](https://github.com/3D-Vision-World/awesome-NeRF-and-3DGS-SLAM) ) - [MASt3R-SLAM : SLAM dense en temps réel avec a priori de reconstruction 3D (article, arXiv)](https://arxiv.org/abs/2412.12392) - [VGGT-Align (article, arXiv)](https://arxiv.org/abs/2608.15260) - [Scalix : SLAM monoculaire cohérent à l'échelle et prenant en compte l'incertitude (article, arXiv)](https://arxiv.org/abs/2608.17553)
Commentaires
Veuillez vous connecter.
Aucune entrée pour le moment.