Contents — find the section you need
Il Visual-SLAM è la famiglia di tecniche che eseguono l'autolocalizzazione e la mappatura basandosi esclusivamente sulle riprese video (o su una combinazione di telecamera e IMU). Non necessita di un costoso sensore di distanza come il LiDAR, ma presenta un punto debole: la sensibilità alle variazioni di illuminazione e alle scene con scarsa texture. Superare questa debolezza rappresenta essenzialmente la tendenza tecnologica stessa.
 OpenCV
Immagine: OpenCV logo, Wikimedia Commons (Apache 2.0)

Visual-SLAM in sintesi
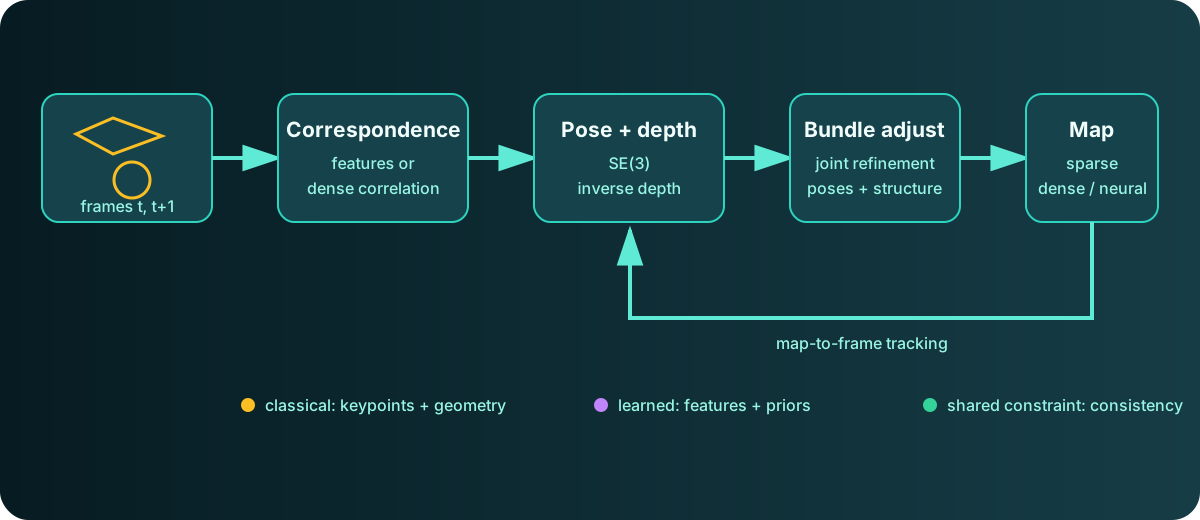
Diagramma: Duskcoil. Mostra le relazioni geometriche condivise dagli approcci classici e da quelli basati sull'apprendimento automatico.
Il problema centrale del Visual-SLAM è associare lo stesso punto tra i fotogrammi e ricostruire congiuntamente il movimento della telecamera e la struttura 3D che rendono tali associazioni coerenti. I metodi classici associano esplicitamente punti chiave sparsi; i metodi basati sull'apprendimento automatico inferiscono la corrispondenza da caratteristiche dense o da informazioni a priori apprese. Entrambi rimangono vincolati dalla coerenza tra osservazione, posa e struttura. Un'altra scelta pratica rilevante è se la mappa sia una nuvola di punti sparsa, una profondità densa o una rappresentazione neurale.
L'endpoint basato su punti caratteristici: ORB-SLAM3
Un endpoint del Visual-SLAM classico è ORB-SLAM3. Può eseguire SLAM visivo, visivo-inerziale o multi-mappa in tempo reale su configurazioni monoculari, stereo o RGB-D, trovando la corrispondenza tra le immagini utilizzando un descrittore di caratteristiche chiamato ORB, quindi ottimizzando la posa e i punti della mappa tramite bundle adjustment. Ciò che il bundle adjustment minimizza è la somma della discrepanza (errore di riproiezione) tra la posizione in cui un punto della mappa 3D \mathbf{X}_i atterra quando proiettato nell'immagine con la posizione della telecamera (\mathbf{R}_j, \mathbf{t}_j) e la posizione in cui il corrispondente punto caratteristico \mathbf{u}_{ij} è stato effettivamente osservato nell'immagine.
Qui \pi(\cdot) è la funzione di proiezione da un punto 3D al piano dell'immagine, basata sui parametri intrinseci della telecamera. Ottimizzare congiuntamente questa espressione sia sulla posizione della telecamera che sui punti della mappa è l'essenza del bundle adjustment, risolto all'interno dello stesso framework dei minimi quadrati non lineari utilizzato per l'ottimizzazione del grafo precedentemente trattato (vedere "Technology Trends in SLAM" per i dettagli). Anni dopo la sua uscita, è ancora citato negli articoli di ricerca come punto di riferimento per i confronti: di fatto, l'implementazione standard di riferimento.
End-to-End tramite Deep Learning: DROID-SLAM
Esiste anche una consolidata tendenza a sostituire il processo esplicito di estrazione e corrispondenza delle caratteristiche con il deep learning. DROID-SLAM ne è l'esempio principale, stimando la posizione della telecamera e la profondità per pixel tramite aggiornamenti iterativi ricorrenti e un livello di bundle-adjustment denso. Pur essendo stato addestrato solo su video monoculari, è sufficientemente flessibile da sfruttare anche video stereo o RGB-D in fase di test per una maggiore precisione. Detto questo, i suoi requisiti computazionali sono più elevati rispetto ai metodi classici: la sola inferenza richiede 11 GB o più di memoria GPU.
All'interno di DROID-SLAM: Volumi di correlazione e regolazione differenziabile del bundle
Esaminando più da vicino come DROID-SLAM stima la posa e la profondità senza ricorrere all'estrazione esplicita delle caratteristiche: innanzitutto, calcola mappe di caratteristiche dense a 1/8 della risoluzione di input, utilizzando due reti neurali convoluzionali (CNN): una per l'estrazione delle caratteristiche e una per le informazioni contestuali. Per ogni coppia di fotogrammi, costruisce un "volume di correlazione 4D" calcolando in modo esaustivo il prodotto scalare tra ogni coppia di vettori di caratteristiche, che diventa la base per la stima della corrispondenza a livello di pixel.
La stima stessa è gestita da un operatore di aggiornamento iterativo. Le caratteristiche del volume di correlazione, insieme al residuo (correzione) dell'iterazione precedente, passano attraverso strati convoluzionali e in una ConvGRU (un'unità ricorrente convoluzionale con gating), che produce una correzione al flusso (movimento apparente). Il meccanismo di gating, che permette alla rete di controllare selettivamente quali informazioni incorporare e quali scartare, è la parte che questa rete ha effettivamente appreso.
L'output di questo aggiornamento iterativo alimenta un layer Dense Bundle Adjustment (DBA) differenziabile che aggiorna simultaneamente la posa della telecamera e la profondità inversa per pixel. L'integrazione esplicita dei vincoli geometrici nella rete in questo modo conferisce anche a un modello addestrato con una singola immagine la flessibilità di gestire input stereo o RGB-D senza bisogno di un nuovo addestramento.
Reinventare la rappresentazione delle mappe: 3D Gaussian Splatting e NeRF
L'area in più rapida evoluzione al momento è la reinvenzione del formato di rappresentazione delle mappe stesse. I Neural Radiance Fields (NeRF) e il 3D Gaussian Splatting (3DGS) possono rappresentare una scena 3D fotorealistica come un insieme compatto di parametri, anziché come una semplice nuvola di punti. Questa proprietà sta costantemente migliorando la precisione della mappatura, la qualità del rendering e l'efficienza computazionale di SLAM, tutto in una volta.
Nel corso del 2026, una serie di nuovi metodi basati su 3DGS/NeRF hanno continuato a essere presentati in importanti conferenze e riviste: Splat-SLAM, che esegue l'ottimizzazione globale a partire da soli video RGB; Gaussian-LIC/Gaussian-LIC2, che integrano LiDAR, IMU e telecamera; GTS-SLAM, pensato per ambienti ostili come le miniere sotterranee; MTE-SLAM (ICRA 2026), orientato verso lo SLAM semantico; e PMET-SLAM, che bilancia la mappatura fotorealistica con un tracciamento efficiente. Rispetto ai metodi tradizionali, la qualità del rendering e la riutilizzabilità della mappa (la capacità di rielaborare l'ambiente da un punto di vista arbitrario in un secondo momento) sono citate come chiari punti di forza.
La tendenza 2025-2026: SLAM basato su modelli 3D feed-forward
Partendo dal design di DROID-SLAM — stima iterativa più bundle adjustment differenziabile — MASt3R-SLAM (un articolo di spicco del CVPR 2025), pubblicato alla fine del 2024, tratta l'output di MASt3R — un modello di base pre-addestrato sulla ricostruzione e corrispondenza 3D a due viste — come "conoscenza a priori". Gestisce la corrispondenza di mappe di punti, il tracciamento della telecamera, la fusione di mappe locali e il rilevamento della chiusura di loop all'interno di un unico framework, anche quando le caratteristiche intrinseche della telecamera sono sconosciute, eseguendo a 15 FPS con modelli di telecamera noti e raggiungendo, a quanto pare, un'accuratezza all'avanguardia su diversi benchmark.
Questa linea di modelli di base ha acquisito ulteriore slancio con l'arrivo nel 2025 di VGGT (Visual Geometry Grounded Transformer), un modello di base 3D feed-forward che produce simultaneamente pose della telecamera, profondità e nuvole di punti da immagini multivista in un singolo passaggio in avanti. Un'ondata di ricerche derivate, basate sull'output di VGGT, ha fatto seguito fino al 2026. VGGT-SLAM++ (aprile 2026) trasforma l'output del trasformatore di VGGT in un sistema SLAM completo, combinandolo con frequenti ottimizzazioni locali, tramite grafici di covisibilità e riconoscimento visivo del luogo, per stabilizzare le traiettorie. VGGT-Align (agosto 2026) risolve la deriva di scala tra i chunk su lunghe sequenze, vincolando la scala utilizzando invarianti geometriche dominanti estratte dalla nuvola di punti di ciascun chunk. Sono emersi anche studi di analisi, come Co-VGGT (luglio 2026), che ha dimostrato come VGGT codifichi implicitamente la covisibilità (quali punti di vista condividono la stessa regione) senza alcun segnale di supervisione esplicito: un impegno attivo per comprendere cosa catturino effettivamente le rappresentazioni interne di questi modelli di base.
Cosa mostrano i benchmark: più accurato, ma non una soluzione miracolosa
Nella seconda metà del 2026 è emerso un gruppo di studi che quantificano le prestazioni reali dello SLAM basato su modelli di base. Una valutazione che confrontava cinque sistemi SLAM monoculari su filmati nadir ad alta quota acquisiti da droni DJI ha rilevato che MASt3R-SLAM ha ottenuto l'errore assoluto orizzontale medio più basso, pari allo 0,53% della lunghezza del percorso, pur sottolineando che l'accuratezza verticale (altitudine) rimane un problema aperto. Uno studio separato (agosto 2026) che ha valutato lo SLAM monoculare in presenza di artefatti sia sintetici che reali ha rilevato che, mentre i metodi classici basati sulle caratteristiche tendono a subire "fallimenti catastrofici del tracciamento" in condizioni degradate, i tracker basati sull'apprendimento automatico sostituiscono sostanzialmente tale fallimento catastrofico con una "deriva prolungata e talvolta grave". In altre parole, i metodi basati sull'apprendimento automatico possono scambiare una modalità di fallimento drammatica e visibile con una più silenziosa, in cui l'errore si accumula inosservato: un promemoria del fatto che le sole metriche di accuratezza non raccontano tutta la storia di quale approccio sia effettivamente migliore.
Anche per quanto riguarda l'ambiguità di scala, la classica debolezza per cui un feed monoculare da solo non è in grado di recuperare la scala di distanza assoluta, stanno emergendo nuovi approcci. Scalix (agosto 2026), che integra la predizione della profondità appresa in un grafo fattoriale probabilistico, riporta prestazioni all'avanguardia sia su benchmark metrici (scala assoluta) che su benchmark up-to-scale (scala relativa).
Criteri di selezione pratici
A questo punto, la suddivisione pratica si presenta come segue:
- Risorse limitate, comprovata esperienza: metodi basati su feature point della famiglia ORB-SLAM3 — con una solida esperienza sul campo, anche su hardware embedded
- Priorità all'accuratezza, ampie risorse GPU: metodi di deep learning end-to-end della famiglia DROID-SLAM
- Generalizzazione ad ambienti non familiari, nessuna calibrazione richiesta: metodi feed-forward basati su modelli 3D di base della famiglia MASt3R-SLAM/VGGT — sebbene permangano alcune problematiche aperte, come l'accuratezza verticale e la deriva durante operazioni di lunga durata
- Necessità di riutilizzo di mappe fotorealistiche: metodi basati su 3DGS/NeRF — sebbene molti siano ancora in fase di ricerca e l'implementazione sul campo sia ancora in fase di sviluppo
Nessuna di queste famiglie sta realmente sostituendo le altre: la realtà attuale è che si stanno definendo in base ai casi d'uso.
Un buon rendering della visuale inedita stabilisce le pose corrette della telecamera?
Misura la qualità del rendering separatamente dalla precisione geometrica e della traiettoria.
La sola qualità visiva non è sufficiente per classificare i metodi di localizzazione.Riferimenti
- ORB-SLAM3 GitHub (UZ-SLAMLab)
- DROID-SLAM GitHub (princeton-vl) / Articolo (arXiv)
- Come NeRF e 3D Gaussian Splatting stanno rimodellando SLAM: una panoramica
- Splat-SLAM: SLAM RGB-only ottimizzato globalmente con gaussiane 3D (arXiv)
- awesome-NeRF-and-3DGS-SLAM (raccolta di articoli/codici, GitHub)
- MASt3R-SLAM: SLAM denso in tempo reale con prior di ricostruzione 3D (articolo su arXiv)
- VGGT-Align (articolo su arXiv)
- Scalix: SLAM monoculare a scala coerente e consapevole dell'incertezza (articolo su arXiv)
Commenti
Accedi per continuare.
Nessun dato disponibile.