Contents — find the section you need
O SLAM visual é o conjunto de técnicas que realiza autolocalização e mapeamento utilizando apenas imagens de câmeras (ou uma combinação de câmera e IMU). Não necessita de um sensor de alcance caro como o LiDAR, mas apresenta uma desvantagem — a sensibilidade a mudanças de iluminação e cenas com pouca textura — e a busca por soluções para essa desvantagem é essencialmente a própria tendência tecnológica.
O SLAM visual é o conjunto de técnicas que realiza autolocalização e mapeamento utilizando apenas imagens de câmeras (ou uma combinação de câmera e IMU).
 OpenCV
Imagem: OpenCV logo, Wikimedia Commons (Apache 2.0)

Visão geral do Visual-SLAM
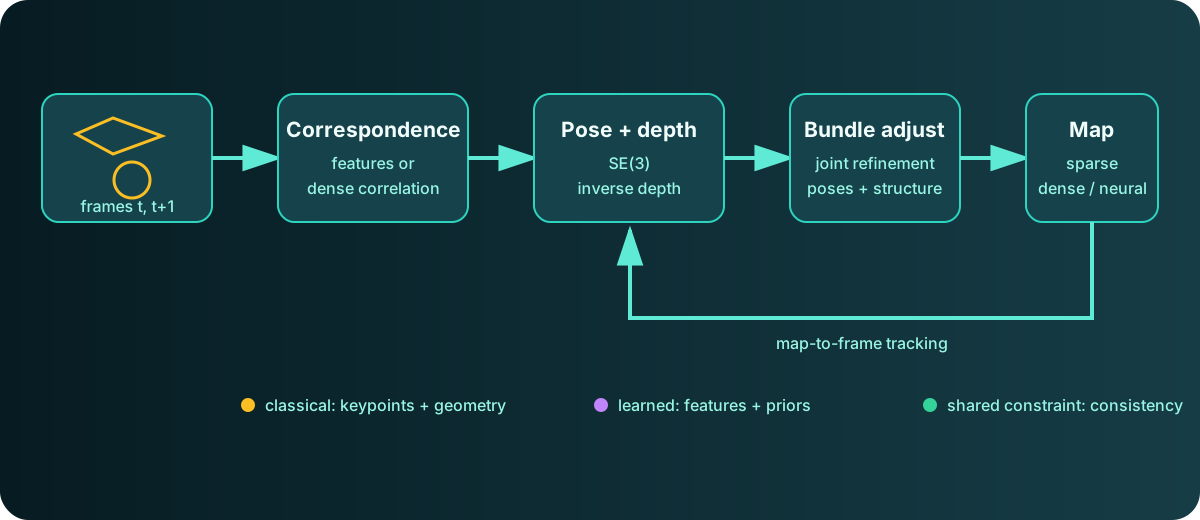
Diagrama: Duskcoil. Mostra as relações geométricas compartilhadas pelas abordagens clássicas e baseadas em aprendizado.
O principal problema do Visual-SLAM é associar o mesmo local entre frames e recuperar conjuntamente o movimento da câmera e a estrutura 3D que tornam essas associações consistentes. Os métodos clássicos correspondem explicitamente a pontos-chave esparsos; os métodos baseados em aprendizado inferem correspondências a partir de características densas ou conhecimentos prévios aprendidos. Ambos permanecem limitados pela consistência entre observação, pose e estrutura. Se o mapa é uma nuvem de pontos esparsa, uma representação de profundidade densa ou uma representação neural é outra escolha prática importante.
O Endpoint Baseado em Pontos de Características: ORB-SLAM3
Um endpoint do SLAM visual clássico é o ORB-SLAM3. Ele pode executar SLAM visual, visual-inercial ou multi-mapa em tempo real em configurações monoculares, estéreo ou RGB-D, encontrando correspondências entre imagens usando um descritor de características chamado ORB e, em seguida, otimizando a pose e os pontos do mapa por meio de ajuste de feixe. O que o ajuste de feixe minimiza é a soma da discrepância (erro de reprojeção) entre onde um ponto do mapa 3D \mathbf{X}_i é projetado na imagem sob a pose da câmera (\mathbf{R}_j, \mathbf{t}_j) e onde o ponto de recurso correspondente \mathbf{u}_{ij} foi realmente observado na imagem.
Aqui, \pi(\cdot) é a função de projeção de um ponto 3D para o plano da imagem, com base nos parâmetros intrínsecos da câmera. A otimização conjunta dessa expressão, considerando tanto a pose da câmera quanto os pontos do mapa, é a essência do ajuste de feixe, resolvido dentro da mesma estrutura de mínimos quadrados não lineares da otimização de grafos abordada anteriormente (consulte "Technology Trends in SLAM" para obter detalhes). Anos após seu lançamento, ele ainda é citado em artigos de pesquisa como uma linha de base de comparação — a implementação de referência padrão de fato. ## Aprendizado Profundo de Ponta a Ponta: DROID-SLAM
Há também uma tendência consolidada de substituir o processo explícito de extração e correspondência de características por aprendizado profundo. O DROID-SLAM é o principal exemplo, estimando a pose da câmera e a profundidade por pixel por meio de atualizações iterativas recorrentes e uma camada densa de ajuste de feixe. Apesar de ser treinado apenas com vídeo monocular, ele é flexível o suficiente para também explorar vídeo estéreo ou RGB-D durante o teste para obter maior precisão. Dito isso, suas demandas computacionais são maiores do que as dos métodos clássicos — somente a inferência requer 11 GB ou mais de memória da GPU.
Por Dentro do DROID-SLAM: Volumes de Correlação e Ajuste de Feixe Diferenciável
Analisando mais de perto como o DROID-SLAM estima a pose e a profundidade sem passar pela extração explícita de características: ele primeiro computa mapas de características densos em 1/8 da resolução de entrada, usando duas CNNs — uma para extração de características e outra para informações contextuais. Para cada par de frames, o sistema constrói um "volume de correlação 4D" calculando exaustivamente o produto escalar entre cada par de vetores de características, o qual se torna a base para estimar a correspondência pixel a pixel.
A estimativa em si é feita por um operador de atualização iterativa. As características do volume de correlação, juntamente com o resíduo (correção) da iteração anterior, passam por camadas convolucionais e chegam a uma ConvGRU (unidade recorrente convolucional com portão), que gera uma correção para o fluxo (movimento aparente). O mecanismo de portão — que permite à rede controlar seletivamente quais informações incorporar e quais descartar — é a parte que esta rede realmente aprendeu.
A saída desta atualização iterativa alimenta uma camada de Ajuste Denso de Feixe (DBA) diferenciável, que atualiza simultaneamente a pose da câmera e a profundidade inversa por pixel. Incorporar restrições geométricas explicitamente na rede dessa forma confere até mesmo a um modelo treinado com visão monocular a flexibilidade para lidar com entradas estéreo ou RGB-D sem a necessidade de retreinamento.
Reinventando a Representação de Mapas: Splatting Gaussiano 3D e NeRF
A área de desenvolvimento mais rápido atualmente é a reinvenção do próprio formato de representação de mapas. Os Campos de Radiância Neural (NeRF) e o Splatting Gaussiano 3D (3DGS) podem representar uma cena 3D fotorrealista como um conjunto compacto de parâmetros, em vez de uma simples nuvem de pontos. Essa propriedade está elevando de forma constante a precisão do mapeamento, a qualidade da renderização e a eficiência computacional do SLAM simultaneamente.
Até meados de 2026, uma série de novos métodos baseados em 3DGS/NeRF continuaram a surgir em importantes conferências e periódicos: Splat-SLAM, que realiza otimização global apenas a partir de vídeo RGB; Gaussian-LIC/Gaussian-LIC2, que combinam LiDAR, IMU e câmera; GTS-SLAM, voltado para ambientes hostis como minas subterrâneas; MTE-SLAM (ICRA 2026), orientado para SLAM semântico; e o PMET-SLAM, que equilibra mapeamento fotorrealista com rastreamento eficiente. Comparado aos métodos tradicionais, a qualidade de renderização e a reutilização do mapa (a capacidade de renderizar novamente o ambiente a partir de um ponto de vista arbitrário posteriormente) são citadas como pontos fortes evidentes.
O cenário atual de 2025-2026: SLAM baseado em modelos 3D Feed-Forward
Levando o design do DROID-SLAM — estimativa iterativa mais ajuste de feixe diferenciável — um passo adiante, o MASt3R-SLAM (um artigo de destaque da CVPR 2025), publicado no final de 2024, trata a saída do MASt3R — um modelo base pré-treinado em reconstrução e correspondência 3D de duas vistas — como "conhecimento prévio". Ele lida com correspondência de mapas de pontos, rastreamento de câmera, fusão de mapas locais e detecção de fechamento de loop em uma única estrutura, mesmo quando os parâmetros intrínsecos da câmera são desconhecidos, rodando a 15 FPS com modelos de câmera conhecidos e, segundo relatos, alcançando precisão de última geração em diversos benchmarks. Essa linha de modelos fundamentais ganhou ainda mais impulso com a chegada do VGGT (Visual Geometry Grounded Transformer) em 2025 — um modelo fundamental 3D de propagação direta que gera simultaneamente pose da câmera, profundidade e nuvens de pontos a partir de imagens multiview em uma única passagem direta. Uma onda de pesquisas derivadas, construídas sobre a saída do VGGT, seguiu até 2026. O VGGT-SLAM++ (abril de 2026) transforma a saída do transformador do VGGT em um sistema SLAM completo, combinando-a com otimização local frequente — por meio de grafos de covisibilidade e reconhecimento visual de localização — para estabilizar trajetórias. O VGGT-Align (agosto de 2026) resolve a deriva de escala entre blocos em sequências longas, restringindo a escala usando invariantes geométricos dominantes extraídos da nuvem de pontos de cada bloco. Também surgiram análises, como a do Co-VGGT (julho de 2026), que mostrou que o VGGT codifica implicitamente a covisibilidade (quais pontos de vista compartilham a mesma região) sem qualquer sinal de supervisão explícito — um esforço ativo para entender o que as representações internas desses modelos fundamentais realmente capturam.
O que os benchmarks mostram: Mais preciso, mas não uma solução definitiva
Um conjunto de estudos que quantificam o desempenho no mundo real do SLAM baseado em modelos fundamentais surgiu no segundo semestre de 2026. Uma avaliação comparando cinco sistemas SLAM monoculares em filmagens nadir de alta altitude feitas por drones DJI descobriu que o MASt3R-SLAM alcançou o menor erro absoluto horizontal médio, com 0,53% do comprimento do percurso, embora tenha observado que a precisão vertical (altitude) permanece um problema em aberto. Um estudo separado (agosto de 2026) que avaliou o SLAM monocular sob condições de corrupção sintéticas e reais descobriu que, enquanto os métodos clássicos baseados em características tendem a sofrer "falhas catastróficas de rastreamento" em condições degradadas, os rastreadores aprendidos simplesmente substituem essa falha catastrófica por "desvios sustentados e, às vezes, severos". Em outras palavras, os métodos aprendidos podem trocar um modo de falha dramático e visível por um mais silencioso, onde o erro se acumula despercebido — um lembrete de que as métricas de precisão, por si só, não contam toda a história sobre qual abordagem é realmente melhor.
Em relação à ambiguidade de escala — a fraqueza clássica em que uma imagem monocular sozinha não consegue recuperar a escala de distância absoluta — novas abordagens também estão surgindo. O Scalix (agosto de 2026), que integra a previsão de profundidade aprendida em um grafo de fatores probabilístico, apresenta desempenho de última geração em benchmarks tanto de escala métrica (absoluta) quanto de escala relativa.
Critérios Práticos de Seleção
A análise prática neste momento se apresenta da seguinte forma:
- Recursos limitados, histórico comprovado: métodos baseados em pontos de referência da família ORB-SLAM3 — com amplo histórico de uso em aplicações reais, inclusive em hardware embarcado.
- Prioridade à precisão, recursos de GPU abundantes: métodos de aprendizado profundo de ponta a ponta da família DROID-SLAM.
- Generalização para ambientes desconhecidos, sem necessidade de calibração: métodos de modelo de base 3D feed-forward da família MASt3R-SLAM/VGGT — embora ainda existam problemas em aberto, como precisão vertical e deriva em operações de longa duração.
- Necessidade de reutilização de mapas fotorrealistas: métodos baseados em 3DGS/NeRF — embora muitos ainda estejam em fase de pesquisa e a implementação em aplicações reais ainda esteja em desenvolvimento.
Nenhuma dessas famílias está realmente substituindo as outras — a realidade atual é que elas estão se consolidando em uma divisão de casos de uso.
A renderização de uma nova perspectiva estabelece poses de câmera corretas?
Meça a qualidade da renderização separadamente da precisão da geometria e da trajetória. A qualidade visual por si só não classifica os métodos de localização.
## Referências - [ORB-SLAM3 GitHub (UZ-SLAMLab)](https://github.com/UZ-SLAMLab/ORB_SLAM3) - [DROID-SLAM GitHub (princeton-vl)](https://github.com/princeton-vl/DROID-SLAM) / [Artigo (arXiv)](https://arxiv.org/abs/2108.10869) - [Como NeRFs e 3D Gaussian Splatting estão remodelando o SLAM: uma pesquisa](https://www.semanticscholar.org/paper/How-NeRFs-and-3D-Gaussian-Splatting-are-Reshaping-a-Tosi-Zhang/d48aa5b757b4d05a697ed62484b4e7cd956e97e9) - [Splat-SLAM: SLAM somente RGB otimizado globalmente com Gaussianas 3D (arXiv)](https://arxiv.org/pdf/2405.16544) - [awesome-NeRF-and-3DGS-SLAM (resumo de artigos/códigos, GitHub)](https://github.com/3D-Vision-World/awesome-NeRF-and-3DGS-SLAM) ) - [MASt3R-SLAM: SLAM denso em tempo real com informações prévias de reconstrução 3D (artigo no arXiv)](https://arxiv.org/abs/2412.12392) - [VGGT-Align (artigo no arXiv)](https://arxiv.org/abs/2608.15260) - [Scalix: SLAM monocular consistente em escala e com reconhecimento de incerteza (artigo no arXiv)](https://arxiv.org/abs/2608.17553)
Comentários
Entre na sua conta para continuar.
Ainda não há dados.