Contents — find the section you need
Visual-SLAM es una familia de técnicas que realiza la autolocalización y el mapeo basándose únicamente en imágenes de cámara (o una combinación de cámara e IMU). No requiere un sensor de distancia costoso como LiDAR, pero presenta una limitación: su sensibilidad a los cambios de iluminación y a las escenas con poca textura. La historia de cómo superar esta limitación constituye, en esencia, la propia tendencia tecnológica.
 OpenCV
Imagen: OpenCV logo, Wikimedia Commons (Apache 2.0)

Visual-SLAM en resumen
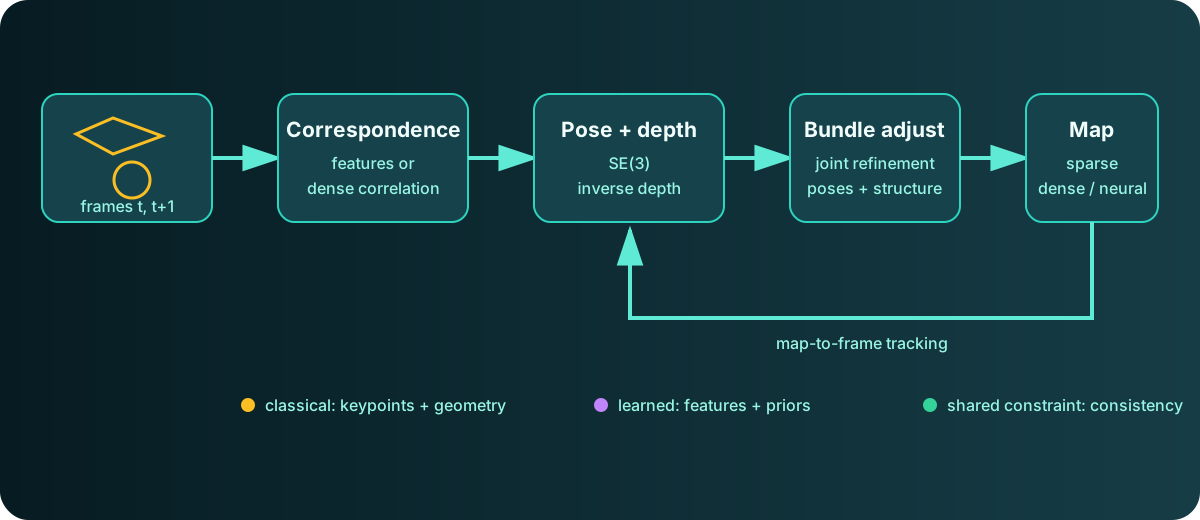
Diagrama: Duskcoil. Muestra las relaciones geométricas compartidas por los enfoques clásicos y basados en aprendizaje.
El problema central en Visual-SLAM es asociar el mismo lugar entre fotogramas y recuperar conjuntamente el movimiento de la cámara y la estructura 3D que hacen que esas asociaciones sean consistentes. Los métodos clásicos emparejan explícitamente puntos clave dispersos; los métodos basados en aprendizaje infieren la correspondencia a partir de características densas o información previa aprendida. Ambos están sujetos a la consistencia entre observación, pose y estructura. El hecho de que el mapa sea una nube de puntos dispersa, una profundidad densa o una representación neuronal es otra decisión práctica importante.
El punto final basado en puntos característicos: ORB-SLAM3
Un punto final del SLAM visual clásico es ORB-SLAM3. Puede ejecutar SLAM visual, visual-inercial o multimapa en tiempo real en configuraciones monoculares, estéreo o RGB-D, encontrando correspondencia entre imágenes mediante un descriptor de características llamado ORB, y luego optimizando la pose y los puntos del mapa mediante ajuste de haces. El ajuste de haces minimiza la suma de la discrepancia (error de reproyección) entre la posición de un punto del mapa 3D \mathbf{X}_i al proyectarse en la imagen bajo la pose de la cámara (\mathbf{R}_j, \mathbf{t}_j) y la posición del punto característico correspondiente \mathbf{u}_{ij} observado en la imagen.
Aquí, \pi(\cdot) es la función de proyección desde un punto 3D al plano de la imagen, basada en los parámetros intrínsecos de la cámara. La optimización conjunta de esta expresión sobre la pose de la cámara y los puntos del mapa constituye la esencia del ajuste de haces, resuelto dentro del mismo marco de mínimos cuadrados no lineales que la optimización de grafos descrita anteriormente (véase "Tendencias tecnológicas en SLAM" para más detalles). Años después de su lanzamiento, aún se cita en artículos de investigación como referencia comparativa: la implementación de referencia estándar de facto.
De extremo a extremo mediante aprendizaje profundo: DROID-SLAM
También existe una tendencia bien establecida a reemplazar el proceso explícito de extracción y coincidencia de características directamente con aprendizaje profundo. DROID-SLAM es el ejemplo más destacado, ya que estima la pose de la cámara y la profundidad por píxel mediante actualizaciones iterativas recurrentes y una densa capa de ajuste de haces. Aunque se entrenó únicamente con vídeo monocular, es lo suficientemente flexible como para aprovechar también vídeo estéreo o RGB-D durante las pruebas para una mayor precisión. Sin embargo, sus requisitos computacionales son mayores que los de los métodos clásicos: solo la inferencia requiere 11 GB o más de memoria GPU.
Dentro de DROID-SLAM: Volúmenes de correlación y ajuste de haces diferenciable
Analizando con más detalle cómo DROID-SLAM estima la pose y la profundidad sin realizar una extracción explícita de características: primero calcula mapas densos de características a 1/8 de la resolución de entrada, utilizando dos CNN: una para la extracción de características y otra para la información contextual. Para cada par de fotogramas, construye un "volumen de correlación 4D" calculando exhaustivamente el producto escalar entre cada par de vectores de características, lo que constituye la base para estimar la correspondencia píxel a píxel.
La estimación en sí se gestiona mediante un operador de actualización iterativo. Las características del volumen de correlación, junto con el residuo (corrección) de la iteración anterior, pasan por capas convolucionales y llegan a una ConvGRU (unidad recurrente convolucional con compuerta), que genera una corrección al flujo (movimiento aparente). El mecanismo de compuerta, que permite a la red controlar selectivamente qué información incorporar y cuál descartar, es la parte que esta red ha aprendido.
La salida de esta actualización iterativa se introduce en una capa de Ajuste de Paquetes Densos (DBA) diferenciable que actualiza simultáneamente la pose de la cámara y la profundidad inversa por píxel. Al incorporar explícitamente restricciones geométricas en la red de esta manera, incluso un modelo entrenado con visión monocular adquiere la flexibilidad necesaria para procesar entradas estéreo o RGB-D sin necesidad de reentrenamiento.
Reinventando la Representación de Mapas: Splatting Gaussiano 3D y NeRF
El área de mayor avance actualmente es la reinvención del formato de representación de mapas. Los campos de radiación neuronal (NeRF) y la dispersión gaussiana 3D (3DGS) permiten representar una escena 3D fotorrealista como un conjunto compacto de parámetros, en lugar de una simple nube de puntos. Esta propiedad está mejorando progresivamente la precisión del mapeo, la calidad de renderizado y la eficiencia computacional de SLAM.
En 2026, se siguieron presentando en importantes congresos y revistas una serie de nuevos métodos basados en 3DGS/NeRF: Splat-SLAM, que realiza una optimización global a partir únicamente de vídeo RGB; Gaussian-LIC/Gaussian-LIC2, que combinan LiDAR, IMU y cámara; GTS-SLAM, diseñado para entornos hostiles como minas subterráneas; MTE-SLAM (ICRA 2026), orientado a SLAM semántico; y PMET-SLAM, que equilibra el mapeo fotorrealista con un seguimiento eficiente. En comparación con los métodos tradicionales, la calidad de renderizado y la reutilización de mapas (la capacidad de volver a renderizar el entorno desde cualquier punto de vista posteriormente) se destacan como ventajas evidentes.
Actualidad 2025-2026: SLAM basado en modelos 3D de propagación directa
Dando un paso más allá al diseño de DROID-SLAM —estimación iterativa más ajuste de haces diferenciable—, MASt3R-SLAM (un artículo destacado de CVPR 2025), publicado a finales de 2024, trata la salida de MASt3R —un modelo base preentrenado en reconstrucción y correspondencia 3D de dos vistas— como "conocimiento previo". Gestiona la coincidencia de mapas de puntos, el seguimiento de la cámara, la fusión de mapas locales y la detección de cierre de bucle dentro de un único marco, incluso cuando se desconocen las características intrínsecas de la cámara, funcionando a 15 FPS con modelos de cámara conocidos y, según se informa, logrando una precisión de vanguardia en múltiples pruebas comparativas.
Esta línea de modelos fundamentales cobró mayor impulso con la llegada en 2025 de VGGT (Visual Geometry Grounded Transformer), un modelo fundamental 3D de alimentación directa que genera simultáneamente la pose de la cámara, la profundidad y las nubes de puntos a partir de imágenes multivista en una sola pasada hacia adelante. Una ola de investigación derivada basada en la salida de VGGT continuó hasta 2026. VGGT-SLAM++ (abril de 2026) convierte la salida del transformador de VGGT en un sistema SLAM completo al combinarlo con optimización local frecuente (a través de gráficos de covisibilidad y reconocimiento visual de lugares) para estabilizar trayectorias. VGGT-Align (agosto de 2026) resuelve la deriva de escala entre fragmentos en secuencias largas al restringir la escala utilizando invariantes geométricos dominantes extraídos de la nube de puntos de cada fragmento. También han surgido trabajos de análisis, como Co-VGGT (julio de 2026), que demostró que VGGT codifica implícitamente la covisibilidad (qué puntos de vista comparten la misma región) sin ninguna señal de supervisión explícita; un esfuerzo activo por comprender qué capturan realmente las representaciones internas de estos modelos base.
Lo que muestran las pruebas comparativas: Mayor precisión, pero no la solución definitiva
En la segunda mitad de 2026, apareció un conjunto de estudios que cuantificaban el rendimiento en el mundo real de SLAM basado en modelos base. Una evaluación que comparaba cinco sistemas SLAM monoculares en imágenes nadir de gran altitud de drones DJI reveló que MASt3R-SLAM logró el menor error absoluto horizontal promedio, con un 0,53 % de la longitud de la trayectoria, si bien señaló que la precisión vertical (altitud) sigue siendo un problema abierto. Un estudio independiente (agosto de 2026) que evaluó el SLAM monocular bajo condiciones sintéticas y reales reveló que, si bien los métodos clásicos basados en características tienden a sufrir "fallos de seguimiento catastróficos" en condiciones degradadas, los algoritmos de seguimiento basados en aprendizaje automático simplemente reemplazan ese fallo catastrófico con una "deriva sostenida, y a veces severa". En otras palabras, los métodos basados en aprendizaje automático pueden intercambiar un modo de fallo drástico y visible por uno más sutil, donde el error se acumula sin ser detectado; esto nos recuerda que las métricas de precisión por sí solas no revelan la historia completa sobre qué enfoque es realmente mejor.
En cuanto a la ambigüedad de escala —la debilidad clásica donde una transmisión monocular por sí sola no puede recuperar la escala de distancia absoluta— también están surgiendo nuevos enfoques. Scalix (agosto de 2026), que integra la predicción de profundidad aprendida en un grafo de factores probabilísticos, reporta un rendimiento de vanguardia tanto en pruebas de referencia métricas (escala absoluta) como de escala relativa.
Criterios de Selección Prácticos
El análisis práctico actual es el siguiente:
- Recursos limitados, historial comprobado: métodos basados en puntos característicos de la familia ORB-SLAM3 — amplio historial en entornos reales, incluso en hardware embebido.
- Prioridad a la precisión, amplios recursos de GPU: métodos de aprendizaje profundo de extremo a extremo de la familia DROID-SLAM.
- Generalización a entornos desconocidos, sin necesidad de calibración: métodos de modelo base 3D de propagación directa de la familia MASt3R-SLAM/VGGT — aunque persisten problemas, como la precisión vertical y la deriva en operaciones de larga duración.
- Reutilización de mapas fotorrealistas necesaria: métodos basados en 3DGS/NeRF — aunque muchos aún se encuentran en fase de investigación y su implementación en entornos reales aún está en desarrollo.
Ninguna de estas familias reemplaza realmente a las demás; la realidad actual es que se están consolidando en una división de casos de uso.
¿Una buena renderización de vistas novedosas establece poses de cámara correctas?
Mide la calidad de la renderización por separado de la precisión de la geometría y la trayectoria.
La calidad visual por sí sola no permite clasificar los métodos de localización. ## Referencias - [ORB-SLAM3 GitHub (UZ-SLAMLab)](https://github.com/UZ-SLAMLab/ORB_SLAM3) - [DROID-SLAM GitHub (princeton-vl)](https://github.com/princeton-vl/DROID-SLAM) / [Artículo (arXiv)](https://arxiv.org/abs/2108.10869) - [Cómo NeRF y la dispersión gaussiana 3D están transformando SLAM: una revisión](https://www.semanticscholar.org/paper/How-NeRFs-and-3D-Gaussian-Splatting-are-Reshaping-a-Tosi-Zhang/d48aa5b757b4d05a697ed62484b4e7cd956e97e9) - [Splat-SLAM: SLAM optimizado globalmente solo con RGB y gaussianas 3D (arXiv)](https://arxiv.org/pdf/2405.16544) - [awesome-NeRF-and-3DGS-SLAM (recopilación de artículos y código, GitHub)](https://github.com/3D-Vision-World/awesome-NeRF-and-3DGS-SLAM) - [MASt3R-SLAM: SLAM denso en tiempo real con información a priori de reconstrucción 3D (arXiv)](https://arxiv.org/abs/2412.12392) - [VGGT-Align (arXiv)](https://arxiv.org/abs/2608.15260) - [Scalix: SLAM monocular con escala consistente y sensible a la incertidumbre (arXiv)](https://arxiv.org/abs/2608.17553)
Comentarios
Inicia sesión para continuar.
Todavía no hay datos.