Contents — find the section you need
Roboternavigation ist die Technologie, einen Pfad von der aktuellen Position zu einem Ziel auf einer Karte zu planen und diesem dann unter Vermeidung von Hindernissen zu folgen. Klassische Pipelines wie Nav2 – die auch newbot verwendet – sind in der Praxis weiterhin die gängigste Wahl, während die Forschung an durchgängigen Ansätzen auf Basis von Reinforcement Learning und Bildverarbeitungsmodellen rasant zunimmt.
Roboternavigation ist die Technologie, einen Pfad von der aktuellen Position zu einem Ziel auf einer Karte zu planen und diesem dann zu folgen, wobei Hindernissen ausgewichen werden.
 ROS 2 / Nav2
Bild: Robot Betriebssystem Logo, Wikimedia Commons (CC BY-SA 4.0)

Autonome Navigation auf einen Blick
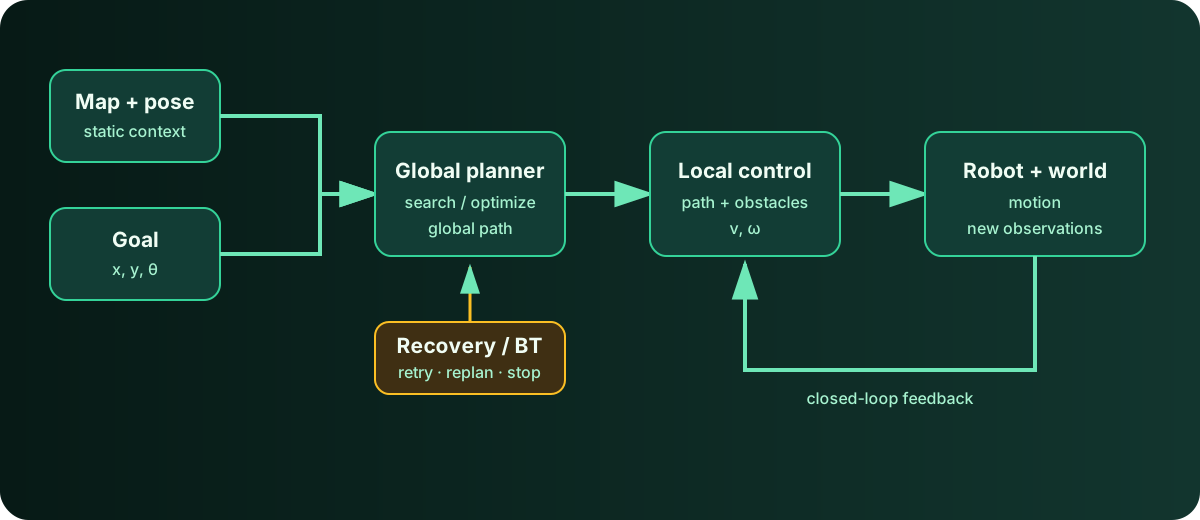
Diagramm: Duskcoil. Die Aufteilung der Verantwortlichkeiten in einem hierarchischen Navigationsstack wie Nav2 ist vereinfacht.
Navigation ist mehr als die einmalige Berechnung des kürzesten Pfades. Ein globaler Planer analysiert die Karte, ein lokaler Controller wandelt den Pfad in Geschwindigkeitsbefehle um und berücksichtigt dabei Hindernisse in der Nähe sowie Fahrzeugbeschränkungen. Beobachtungen nach der Bewegung aktualisieren die nächste Entscheidung. Anhalten, Neuplanung und Wiederherstellung sind ebenfalls Teil des Systems. Die folgenden Abschnitte lassen sich daher so interpretieren, dass man sich fragt, wo Planung, Steuerung, Lernen und Sprachbefehle in diesen gemeinsamen geschlossenen Regelkreis einfließen.
Die klassische Pipeline: Trennung von Kostenkarte und Pfadplanung
Ein klassischer Navigationsstack, wie er beispielsweise in Nav2 verwendet wird, erstellt aus Sensordaten eine Kostenkarte (eine 2D-Karte, die das Hindernisrisiko darstellt) und führt darauf aufbauend globale Pfadplanung und lokale Trajektorienverfolgung als separate Module aus. Die Rolle jedes Moduls ist klar definiert, und das resultierende Verhalten ist leicht verständlich und anpassbar. Die Anpassungsfähigkeit an unerwartete Umgebungen (z. B. ungewohnte Hindernisformen, Menschenmengen) stößt jedoch an Grenzen. Newbot verwendet ebenfalls diese klassische Pipeline – Implementierungsdetails finden Sie unter „How Mapping and Autonomous Navigation Work“.
Die zugrundeliegende Kinematik: Umrechnung der Differentialantriebsgeschwindigkeit
Unabhängig von der verwendeten Navigationsmethode reduziert sich die Ausgabe des Controllers letztendlich auf zwei Werte: die Translationsgeschwindigkeit v und die Winkelgeschwindigkeit \omega. Bei einem Differentialantriebsroboter wie Newbot (zwei Räder, links und rechts) bildet das kinematische Modell die Grundlage, welches dieses Wertepaar in die Radgeschwindigkeiten v_l, v_r umrechnet.
L ist der Abstand zwischen den linken und rechten Rädern (die Spurbreite). Die inverse Transformation wird verwendet, um den umgekehrten Weg zu gehen – von einer geplanten (v, \omega) zu einer Zielgeschwindigkeit für jedes Rad. Dieses einfache Gleichungspaar erfasst die grundlegende Einschränkung des Differenzialantriebs (keine Seitwärtsbewegung; Kurvenfahrten erfordern stets eine Drehzahldifferenz zwischen den Rädern) – unabhängig von der Komplexität der Kostenkarte oder der Pfadplanung werden die Motoren letztendlich durch dieses kinematische Modell angesteuert. Die Implementierung von Newbot wird auch in „How Safe Velocity Control Works“ beschrieben.
Nav2 im Detail: Kostenkarte, Controller, Verhaltensbaum
Betrachten wir die Zusammenarbeit der Module innerhalb der klassischen Pipeline etwas genauer: Nav2 erstellt seine Kostenkarte (eine 2D-Karte, die das Hindernisrisiko darstellt) durch das Übereinanderlegen mehrerer „Ebenen“. Eine Ebene spiegelt statische Kartendaten wider, eine Ebene erkennt und verfolgt dynamische Hindernisse anhand von Kamera- oder Tiefensensordaten, und eine Ebene überschreibt die Kostenkarte regelbasiert. Durch das Übereinanderlegen von Ebenen mit unterschiedlichen Funktionen können vielfältige Informationsquellen, mehr als ein einzelner Algorithmus allein darstellen könnte, in eine einzige Kartendarstellung integriert werden.
Der Controller-Server, zuständig für die Pfadverfolgung, steuert den Roboter entlang des zuletzt geplanten globalen Pfades. Dabei greift er auf die lokale Kostenkarte zurück und arbeitet mit unterstützenden Plugins zusammen – einem Fortschritts- und einem Zielprüfer. Der Verhaltensserver, der für Wiederherstellungsverhalten (Drehen auf der Stelle, Rückwärtsfahren) zuständig ist, verwendet dieselbe lokale Kostenkarte wie der Controller-Server in Echtzeit. Diese effiziente Konfiguration vermeidet die mehrfache Speicherung eines Umgebungsdarstellungsobjekts.
Die Reihenfolge und die Bedingungen für den Aufruf dieser Server werden durch den Verhaltensbaum gesteuert. Nav2 verwendet die Bibliothek BehaviorTree.CPP. Jeder Knoten in diesem Baum ruft bei jedem „Tick“ (Auslösen) einen Aktionsserver auf – den Planer, den Controller oder einen Verhaltensserver. Dank dieses Designs lassen sich komplexe Verzweigungslogiken – „Bei Fehlern in der Pfadplanung bis zu N-mal wiederholen, bevor ein anderes Wiederherstellungsverhalten angewendet wird“ – ausschließlich über die Konfiguration des Verhaltensbaums anpassen, ohne den Code einzelner Server zu verändern.
Die Verbreitung von durchgängiger, lernbasierter Navigation
Derzeit entwickelt sich als Gegenpol zur klassischen Pipeline die durchgängige, lernbasierte Navigation, die Aktionen direkt aus den Rohdaten der Sensoren generiert. In realistischen, kooperativen Szenarien, wie beispielsweise dem Durchqueren einer Tür, zeigen einige Studien, dass lernbasierte Methoden modellbasierte übertreffen. Deep Reinforcement Learning (DRL) hat sich zu einem der wichtigsten Trends in der ROS-basierten Navigationsforschung entwickelt. Algorithmen wie TD3 (Twin-Delayed DDPG), DDPG und DQN wurden für die Echtzeit-Objekterkennung, -verfolgung und -navigation eingesetzt. Zudem sind Hybridmethoden entstanden, die Imitationslernen (Lernen einer initialen Strategie anhand von Expertendemonstrationen) mit Reinforcement Learning (kontinuierliche Verbesserung dieser Strategie) kombinieren.
Die Entwicklung von Navigationsgrundlagenmodellen
Ein neuerer Ansatz ist der Versuch, die Navigation selbst als „Grundlagenmodell“ zu trainieren. Ein Framework, das Offline-Video-Pretraining mit Posttraining mittels Reinforcement Learning in Simulationen kombiniert (S2E: Seeing-to-Experiencing), zielt darauf ab, die Interaktivität zu verbessern und gleichzeitig die Generalisierungsfähigkeit zu erhalten. Auch die Forschung zur Integration von Vision-Language-Modellen in die Navigation (z. B. Navi2Gaze) schreitet voran. Dabei wird ein Ansatz verfolgt, bei dem das Navigationsziel nicht durch Koordinaten auf einer Karte, sondern durch natürliche Sprache oder ein Zielbild spezifiziert wird (dies überschneidet sich auch mit dem VLA-Bereich – siehe „Technology Trends in VLA“ für Details).
Soziale Navigation
Für einen Indoor-Roboter, der in einer Umgebung mit sich bewegenden Menschen operiert, ist das Bewegen nach einem „menschenähnlichen“ Pfad – und nicht nur das Ausweichen vor Hindernissen – zu einem wichtigen Forschungsthema geworden. Im Bereich der sozialen Navigation werden typischerweise drei Herausforderungen als zentrale Forschungsprobleme identifiziert: Modelle, die menschliche Bewegungen präzise vorhersagen können, Lernumgebungen, die belebte Umgebungen realistisch simulieren, und Bewertungsmetriken, die die Komplexität der realen Welt erfassen. Aktuelle Forschung kombiniert verschiedene Familien von Reinforcement-Learning-Algorithmen – wertbasierte, richtlinienbasierte und Actor-Critic-Algorithmen – mit einer Reihe von neuronalen Netzwerkarchitekturen – Feedforward-, rekurrente, konvolutionelle, Graph- und Transformer-Netzwerke.
Konkrete Ergebnisse lernbasierter Navigation: Zahlen bis 2026
Die Forschung bis 2026 untermauert zunehmend Behauptungen mit konkreten Zahlen anstatt mit vagen Aussagen zur „verbesserten Leistung“. CORE Planner (Juni 2026), der unbekannte Umgebungen ohne vorherige Karte erkundet, kombiniert eine spärliche Sichtbarkeitsgraph-Repräsentation mit einem Transformer und erzielt eine Reduzierung der Reisestrecke um 13 % gegenüber dem traditionellen FAR Planner und um bis zu 48 % gegenüber anderen lernbasierten Vergleichsmethoden. Zudem erreicht er einen Zero-Shot-Simulations-zu-Real-Transfer ohne zusätzliches Training. FlashNav (Juni 2026) reduziert die Trainingszeit drastisch, indem es unnötiges Rendering und hochpräzise Physiksimulationen entfernt und eine GPU-basierte Trainingspipeline nutzt. Dadurch erreicht es eine Erfolgsquote von 100 % und das Policy-Training ist auf einer RTX 5090 in unter 20 Sekunden abgeschlossen. Die trainierte Policy lässt sich erfolgreich auf physische Roboter übertragen.
Auch im Bereich der sozialen Navigation sind quantitative Fortschritte zu verzeichnen. HUMA (Juli 2026), ein Hybridansatz, der VLM-Logik (Vision-Language Model) nur dann aktiviert, wenn sich Personen in der Nähe befinden, und ansonsten auf die Recheneffizienz einer Reinforcement-Learning-Policy setzt, erzielt bei den Benchmarks Social-MP3D und Social-HM3D Verbesserungen der Aufgabenerfüllung um 20 % bzw. 3 %. Die zentrale Designentscheidung lautet nicht: „Die rechenintensive Logik immer ausführen“, sondern „Sie nur dann ausführen, wenn sie tatsächlich benötigt wird“ – eine Wahl, die den Zielkonflikt zwischen Genauigkeit und Rechenaufwand löst.
Navigationsgrundlagenmodelle werden konkret: Beispiele für die Implementierung von VLN
Die Richtung der „Navigationsgrundlagenmodelle“ (S2E o. Ä.) hat sich bis 2026 zu konkreteren Implementierungen entwickelt. SuperMap (August 2026, angenommen auf der RSS 2026) integriert hochfrequentes geometrisches SLAM mit asynchroner Open-Vocabular-Perzeption, um einen 4D-Szenengraphen (Raum und Zeit) zu erstellen, der kompositionelle Abfragen über Objektsemantik und -beziehungen unterstützt. Es ist darauf ausgelegt, die stabile Objektidentität zu erhalten – Objekte im 3D-Raum abzugleichen und wiederzuerkennen – selbst in dynamischen Umgebungen, und dient als Grundlage für die Roboternavigation mittels natürlichsprachlicher Anweisungen.
Ein leichteres Beispiel ist GemNav (Juli 2026), das ein statisches, vortrainiertes multimodales LLM anpasst, um die Wegpunktnavigation mittels diskreter Token zu handhaben. Es benötigt keinen dedizierten visuellen Encoder und positioniert sich als „dateneffiziente Alternative“ – es ermöglicht die Übertragung von Navigationsergebnissen in unbekannte Innen- und Außenumgebungen mit nur wenigen Trainingsdaten, ohne ein umfangreiches Basismodell feinabstimmen zu müssen. Zudem gibt es einen Offline-Ansatz für die sprachbasierte Navigation (Juli 2026), der vollständig lokal auf dem Gerät läuft und keine Cloud-Abhängigkeit aufweist. Dieser kombiniert Objekterkennung mit offenem Vokabular, promptbasierte Segmentierung und LiDAR-Geometrie, um mithilfe eines kleinen Sprachmodells Zielpositionen im Freien zu schätzen. Zusammengenommen deuten diese Ansätze darauf hin, dass die „Navigation per natürlicher Sprache“ sich von einem Forschungsthema hin zu einer realen Anwendung entwickelt.
Aktueller Stand
Derzeit ist keiner dieser Ansätze so weit, dass er eine klassische Navigationspipeline wie Nav2 ersetzen kann. Lernbasierte Methoden zeigen zwar vielversprechende Ergebnisse in Forschungsumgebungen, doch die Kosten für die Überprüfung von Reproduzierbarkeit und Sicherheit auf realer Hardware sind hoch, und der Einsatz in der Produktion und im Masseneinsatz ist weiterhin begrenzt. Das Design von newbot – ein klassischer Pfadplaner kombiniert mit einer unabhängigen Sicherheitsüberwachungsschicht inklusive eines physischen Not-Aus-Schalters (siehe „How Safe Velocity Control Works“ für Details) – spiegelt den aktuellen Stand der Technik in diesem Bereich wider. Auch wenn lernbasierte Methoden zunehmend in der Praxis Anwendung finden, scheint die realistische Wahl, zumindest in absehbarer Zukunft, ein Hybrid auf Basis klassischer Sicherheitsmechanismen zu sein.
Garantiert eine präzise Lokalisierung das Erreichen des Ziels?
Auch Kartierung, Hindernisbewältigung, Planung und Steuerung müssen funktionieren. Die Lokalisierungsgenauigkeit ist nur ein Teil der Navigationsleistung.
## Referenzen - [Social robot navigation: a review and benchmarking of learning-based methods](https://www.ncbi.nlm.nih.gov/pmc/articles/PMC12739477/) - [From Seeing to Experiencing: Scaling Navigation Foundation Models with Reinforcement Learning (arXiv)](https://arxiv.org/abs/2507.22028) - [Nav2 GitHub (ros-navigation)](https://github.com/ros-navigation/navigation2) - [Navigation Concepts — Nav2 Official Documentation](https://docs.nav2.org/concepts/index.html) - [Detailed Behavior Tree Walkthrough — Nav2 Official Documentation](https://docs.nav2.org/behavior_trees/overview/detailed_behavior_tree_walkthrough.html) - [CORE Planner Paper (arXiv)](https://arxiv.org/abs/2606.29222) - [FlashNav Paper (arXiv)](https://arxiv.org/abs/2606.15846) - [Think When It Matters (HUMA) Paper (arXiv)](https://arxiv.org/abs/2607.10991) - [SuperMap Paper (RSS 2026, arXiv)](https://arxiv.org/abs/2608.22896) - [GemNav Paper (arXiv)](https://arxiv.org/abs/2607.06882) - Die Implementierung von newbot wird auch in „[How Mapping and Autonomous Navigation Work](/en/project/newbot/newbot-slam-nav.html)“ und „[How Safe Velocity Control Works](/en/project/newbot/newbot-velocity-control.html)“ behandelt.
Kommentare
Bitte zuerst anmelden.
Noch keine Einträge.